

如需限制评估器运行的 LLM 成本,请参阅跟踪和限制评估器支出。评估器支出跟踪和限制使用模型定价中配置的每个模型的价格。
在 LangSmith UI 中查看成本
在 LangSmith UI 中,你可以通过三种方式查看使用量和支出:查看单个跟踪中的明细、查看项目统计信息中的聚合指标,以及查看仪表板。Token 和成本明细
UI 会将 token 使用量和成本分为三类:- 输入:发送给模型的提示中的 token。子类型包括:缓存读取、文本 token、图像 token 等。
- 输出:模型响应中生成的 token。子类型包括:推理 token、文本 token、图像 token 等。
- 其他:工具调用、检索步骤或任何自定义运行产生的成本。
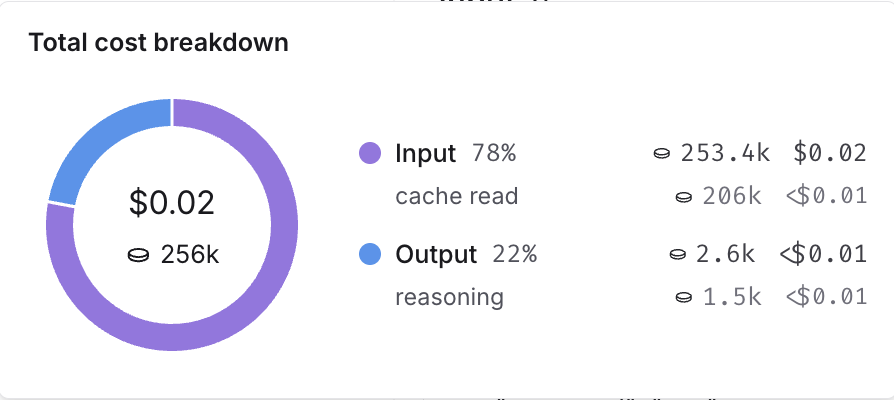
 你可以在 LangSmith UI 的以下位置查看这些明细:
在跟踪树中
跟踪树提供了 token 使用量和成本的最详细视图(针对单个跟踪)。它会显示整个跟踪的总使用量、每个父级运行的聚合值,以及每个子级运行的 token 和成本明细。 打开跟踪项目中的任意运行,即可查看其跟踪树。在跨线程跟踪成本时,请确保所有子级运行都包含线程元数据(
session_id 或 thread_id)。如果子级运行没有线程元数据,这些运行的 token 数量和成本将不会计入线程级聚合。有关设置线程元数据的详细信息,请参阅配置线程。在项目统计信息中
项目统计信息面板显示项目中所有跟踪的 token 使用总量和成本总额。在仪表板中
仪表板可帮助你了解成本和 token 使用量随时间变化的趋势。跟踪项目的预构建仪表板会显示总成本,以及按输入和输出 token 划分的成本明细。 你还可以在自定义仪表板中配置自定义成本跟踪图表。成本跟踪
你可以通过两种方式跟踪成本:- 自动:根据 LLM 调用的 token 数量和模型价格推导。
- 手动:直接在任意运行上指定,包括非 LLM 类型的运行。
| 方法 | 运行类型:LLM | 运行类型:其他 |
|---|---|---|
| 自动 |
| 不适用。 |
| 手动 | 如果 LLM 调用成本不是线性的(例如遵循自定义成本函数) | 为任意运行类型发送成本,例如工具调用、检索步骤 |
LLM 调用:根据 token 数量自动跟踪成本
要根据 token 使用量自动计算成本,你需要提供 token 数量、模型和服务商以及模型价格。-
发送 token 数量。许多模型会在响应中包含 token 数量。你必须提取这些信息,并使用以下方法之一将其包含在运行中:
-
在运行的元数据上设置
usage_metadata字段。此方法的优点是无需更改被跟踪函数的运行时输出:Java 和 Kotlin 示例使用了专用执行器。关闭执行器并等待其终止,可以确保进程退出前后台跟踪提交已完成。from langsmith import traceable, get_current_run_tree inputs = [ {"role": "system", "content": "你是一个有帮助的助手。"}, {"role": "user", "content": "我想预订一张两人桌。"}, ] @traceable( run_type="llm", metadata={"ls_provider": "my_provider", "ls_model_name": "my_model"} ) def chat_model(messages: list): # 假设这是真实应用所需的模型输出格式 assistant_message = { "role": "assistant", "content": "好的,您想预订几点的桌位?" } # 你计算得出或从服务商处接收到的 token 使用量 token_usage = { "input_tokens": 27, "output_tokens": 13, "total_tokens": 40, "input_token_details": {"cache_read": 10} } # 将 token 使用量附加到 LangSmith 运行 run = get_current_run_tree() run.set(usage_metadata=token_usage) return assistant_message chat_model(inputs)import { traceable, getCurrentRunTree } from "langsmith/traceable"; const inputs = [ { role: "system", content: "你是一个有帮助的助手。" }, { role: "user", content: "我想预订一张两人桌。" }, ]; const chatModel = traceable( async ({ messages }) => { // 应用所需的输出 const assistantMessage = { role: "assistant", content: "好的,您想预订几点的桌位?", }; // 你计算得出或从服务商处接收到的 token 使用量 const tokenUsage = { input_tokens: 27, output_tokens: 13, total_tokens: 40, input_token_details: { cache_read: 10 }, }; // 将使用量附加到 LangSmith 运行 const runTree = getCurrentRunTree(); runTree.metadata.usage_metadata = tokenUsage; return assistantMessage; }, { run_type: "llm", name: "chat_model", metadata: { ls_provider: "my_provider", ls_model_name: "my_model", }, } ); await chatModel({ messages: inputs });import com.langchain.smith.client.LangsmithClient; import com.langchain.smith.client.okhttp.LangsmithOkHttpClient; import com.langchain.smith.tracing.RunTree; import com.langchain.smith.tracing.RunType; import com.langchain.smith.tracing.TraceConfig; import com.langchain.smith.tracing.Tracing; import java.util.Arrays; import java.util.HashMap; import java.util.List; import java.util.Map; import java.util.concurrent.ExecutorService; import java.util.concurrent.Executors; import java.util.concurrent.TimeUnit; import java.util.function.Function; class CostTrackingUsageMetadataRun { public static void main(String[] args) throws InterruptedException { if (System.getenv("LANGSMITH_API_KEY") == null || System.getenv("LANGSMITH_API_KEY").isBlank()) { System.out.println( "[cost-tracking-usage-metadata-run] Skipping (LANGSMITH_API_KEY is not set)."); return; } LangsmithClient langsmith = LangsmithOkHttpClient.fromEnv(); ExecutorService executor = Executors.newSingleThreadExecutor(); try { List<Map<String, String>> inputs = Arrays.asList( message("system", "You are a helpful assistant."), message("user", "I'd like to book a table for two.")); Map<String, Object> metadata = new HashMap<>(); metadata.put("ls_provider", "my_provider"); metadata.put("ls_model_name", "my_model"); Function<List<Map<String, String>>, Map<String, String>> chatModel = Tracing.traceFunction( messages -> { Map<String, String> assistantMessage = message( "assistant", "Sure, what time would you like to book the table for?"); Map<String, Object> inputTokenDetails = new HashMap<>(); inputTokenDetails.put("cache_read", 10); Map<String, Object> tokenUsage = new HashMap<>(); tokenUsage.put("input_tokens", 27); tokenUsage.put("output_tokens", 13); tokenUsage.put("total_tokens", 40); tokenUsage.put("input_token_details", inputTokenDetails); RunTree run = Tracing.getCurrentRunTree(); if (run != null) { run.getMetadata().put("usage_metadata", tokenUsage); } return assistantMessage; }, TraceConfig.builder() .name("chat_model") .runType(RunType.LLM) .client(langsmith) .executor(executor) .metadata(metadata) .build()); chatModel.apply(inputs); } finally { executor.shutdown(); if (!executor.awaitTermination(10, TimeUnit.SECONDS)) { throw new IllegalStateException("Timed out waiting for LangSmith traces to submit"); } } } private static Map<String, String> message(String role, String content) { Map<String, String> message = new HashMap<>(); message.put("role", role); message.put("content", content); return message; } }import com.langchain.smith.client.okhttp.LangsmithOkHttpClient import com.langchain.smith.tracing.RunType import com.langchain.smith.tracing.TraceConfig import com.langchain.smith.tracing.getCurrentRunTree import com.langchain.smith.tracing.traceable import java.util.concurrent.Executors import java.util.concurrent.TimeUnit val langsmith = LangsmithOkHttpClient.fromEnv() val executor = Executors.newSingleThreadExecutor() fun message(role: String, content: String) = mapOf("role" to role, "content" to content) try { val inputs = listOf( message("system", "You are a helpful assistant."), message("user", "I'd like to book a table for two."), ) val chatModel = traceable( { _: List<Map<String, String>> -> val assistantMessage = message( "assistant", "Sure, what time would you like to book the table for?", ) val tokenUsage = mapOf( "input_tokens" to 27, "output_tokens" to 13, "total_tokens" to 40, "input_token_details" to mapOf("cache_read" to 10), ) getCurrentRunTree()?.metadata?.put("usage_metadata", tokenUsage) assistantMessage }, TraceConfig.builder() .name("chat_model") .runType(RunType.LLM) .client(langsmith) .executor(executor) .metadata( mapOf( "ls_provider" to "my_provider", "ls_model_name" to "my_model", ), ) .build(), ) chatModel(inputs) } finally { executor.shutdown() check(executor.awaitTermination(10, TimeUnit.SECONDS)) { "Timed out waiting for LangSmith traces to submit" } } -
在被跟踪函数的输出中返回
usage_metadata字段。将usage_metadata键直接包含在被跟踪函数返回的对象中。LangSmith 会从输出中提取该字段:from langsmith import traceable inputs = [ {"role": "system", "content": "你是一个有帮助的助手。"}, {"role": "user", "content": "我想预订一张两人桌。"}, ] output = { "choices": [ { "message": { "role": "assistant", "content": "好的,您想预订几点的桌位?" } } ], "usage_metadata": { "input_tokens": 27, "output_tokens": 13, "total_tokens": 40, "input_token_details": {"cache_read": 10} }, } @traceable( run_type="llm", metadata={"ls_provider": "my_provider", "ls_model_name": "my_model"} ) def chat_model(messages: list): return output chat_model(inputs)import { traceable } from "langsmith/traceable"; const messages = [ { role: "system", content: "你是一个有帮助的助手。" }, { role: "user", content: "我想预订一张两人桌。" } ]; const output = { choices: [ { message: { role: "assistant", content: "好的,您想预订几点的桌位?", }, }, ], usage_metadata: { input_tokens: 27, output_tokens: 13, total_tokens: 40, }, }; const chatModel = traceable( async ({ messages, }: { messages: { role: string; content: string }[]; model: string; }) => { return output; }, { run_type: "llm", name: "chat_model", metadata: { ls_provider: "my_provider", ls_model_name: "my_model" } } ); await chatModel({ messages });import com.langchain.smith.client.LangsmithClient; import com.langchain.smith.client.okhttp.LangsmithOkHttpClient; import com.langchain.smith.tracing.RunType; import com.langchain.smith.tracing.TraceConfig; import com.langchain.smith.tracing.Tracing; import java.util.Arrays; import java.util.HashMap; import java.util.List; import java.util.Map; import java.util.concurrent.ExecutorService; import java.util.concurrent.Executors; import java.util.concurrent.TimeUnit; import java.util.function.Function; class CostTrackingUsageMetadataOutput { public static void main(String[] args) throws InterruptedException { if (System.getenv("LANGSMITH_API_KEY") == null || System.getenv("LANGSMITH_API_KEY").isBlank()) { System.out.println( "[cost-tracking-usage-metadata-output] Skipping (LANGSMITH_API_KEY is not set)."); return; } LangsmithClient langsmith = LangsmithOkHttpClient.fromEnv(); ExecutorService executor = Executors.newSingleThreadExecutor(); try { List<Map<String, String>> messages = Arrays.asList( message("system", "You are a helpful assistant."), message("user", "I'd like to book a table for two.")); Map<String, Object> metadata = new HashMap<>(); metadata.put("ls_provider", "my_provider"); metadata.put("ls_model_name", "my_model"); Function<List<Map<String, String>>, Map<String, Object>> chatModel = Tracing.traceFunction( inputMessages -> output(), TraceConfig.builder() .name("chat_model") .runType(RunType.LLM) .client(langsmith) .executor(executor) .metadata(metadata) .build()); chatModel.apply(messages); } finally { executor.shutdown(); if (!executor.awaitTermination(10, TimeUnit.SECONDS)) { throw new IllegalStateException("Timed out waiting for LangSmith traces to submit"); } } } private static Map<String, Object> output() { Map<String, Object> output = new HashMap<>(); Map<String, Object> choice = new HashMap<>(); choice.put( "message", message("assistant", "Sure, what time would you like to book the table for?")); output.put("choices", Arrays.asList(choice)); Map<String, Object> inputTokenDetails = new HashMap<>(); inputTokenDetails.put("cache_read", 10); Map<String, Object> usageMetadata = new HashMap<>(); usageMetadata.put("input_tokens", 27); usageMetadata.put("output_tokens", 13); usageMetadata.put("total_tokens", 40); usageMetadata.put("input_token_details", inputTokenDetails); output.put("usage_metadata", usageMetadata); return output; } private static Map<String, String> message(String role, String content) { Map<String, String> message = new HashMap<>(); message.put("role", role); message.put("content", content); return message; } }import com.langchain.smith.client.okhttp.LangsmithOkHttpClient import com.langchain.smith.tracing.RunType import com.langchain.smith.tracing.TraceConfig import com.langchain.smith.tracing.traceable import java.util.concurrent.Executors import java.util.concurrent.TimeUnit val langsmith = LangsmithOkHttpClient.fromEnv() val executor = Executors.newSingleThreadExecutor() fun message(role: String, content: String) = mapOf("role" to role, "content" to content) val output = mapOf( "choices" to listOf( mapOf( "message" to message( "assistant", "Sure, what time would you like to book the table for?", ), ), ), "usage_metadata" to mapOf( "input_tokens" to 27, "output_tokens" to 13, "total_tokens" to 40, "input_token_details" to mapOf("cache_read" to 10), ), ) try { val messages = listOf( message("system", "You are a helpful assistant."), message("user", "I'd like to book a table for two."), ) val chatModel = traceable( { _: List<Map<String, String>> -> output }, TraceConfig.builder() .name("chat_model") .runType(RunType.LLM) .client(langsmith) .executor(executor) .metadata( mapOf( "ls_provider" to "my_provider", "ls_model_name" to "my_model", ), ) .build(), ) chatModel(messages) } finally { executor.shutdown() check(executor.awaitTermination(10, TimeUnit.SECONDS)) { "Timed out waiting for LangSmith traces to submit" } }
使用量元数据架构和成本计算
LangSmith 可以识别usage_metadata字典中的以下字段。你可以直接查看完整的 Python 类型或 TypeScript 接口。number模型输入中使用的 token 数量。所有输入 token 类型的总和。number模型响应中使用的 token 数量。所有输出 token 类型的总和。number输入和输出中使用的 token 数量。可选,可以推导得出。等于 input_tokens + output_tokens。object输入 token 类型的明细。键为 token 类型字符串,值为数量。例如{"cache_read": 5}。已知字段包括:audio、text、image、cache_read、cache_creation、cache_read_over_200k(Gemini)、ephemeral_5m_input_tokens、ephemeral_1h_input_tokens(Anthropic 临时缓存层级)。具体字段还可能因模型或服务商而异。object输出 token 类型的明细。键为 token 类型字符串,值为数量。例如{"reasoning": 5}。已知字段包括:audio、text、image、reasoning。具体字段还可能因模型或服务商而异。number输入 token 的成本。number输出 token 的成本。numbertoken 的成本总额。可选,可以推导得出。等于 input_cost + output_cost。object输入成本的明细。键为 token 类型字符串,值为成本金额。成本计算一次运行的成本会按照 token 类型从具体到宽泛的顺序进行贪心计算。假设你设置了每 100 万个输入 token 2 美元的价格,同时设置了每 100 万个object输出成本的明细。键为 token 类型字符串,值为成本金额。cache_read输入 token 1 美元的详细价格,以及每 100 万个输出 token 3 美元的价格。如果你上传了以下使用量元数据:那么 token 成本将按以下方式计算:{ "input_tokens": 20, "input_token_details": {"cache_read": 5}, "output_tokens": 10, "total_tokens": 30, }# 注意,LangSmith 会先计算 cache_read 成本,然后对剩余的 # input_tokens 应用默认输入价格。 input_cost = 5 * 1e-6 + (20 - 5) * 2e-6 # 3.5e-5 output_cost = 10 * 3e-6 # 3e-5 total_cost = input_cost + output_cost # 6.5e-5 -
在运行的元数据上设置
-
指定模型名称。使用自定义模型时,需要在运行的元数据中指定以下字段,以便将 token 数量与成本关联起来。在查看跟踪和进行筛选时,提供这些元数据字段也有助于识别模型。
ls_provider:模型的服务商,例如“openai”“anthropic”ls_model_name:模型名称,例如“gpt-5.4-mini”“claude-opus-4-8”
-
设置模型价格。LangSmith 使用其模型定价表将模型名称映射到每个 token 的价格,以根据 token 数量计算成本。
对于不同 token 类型具有不同价格的模型(例如多模态 token 或缓存 token),你可以为每种 token 类型指定价格明细。将鼠标悬停�� 输入价格 和 输出价格 条目旁边的 … 上,即可查看按 token 类型划分的价格明细。该表包含大多数 OpenAI、Anthropic 和 Gemini 模型的定价信息。如果你使用自定义价格,可以创建新的模型价格条目,或覆盖默认模型的价格。LangSmith 不会将模型定价映射的更新反映到已经记录的跟踪成本中。不支持回填模型定价更改。
创建新的模型价格条目或修改现有条目
要修改默认模型价格,请创建一个与默认条目具有相同模型、服务商和匹配模式的新条目。 要在模型定价映射中创建新条目,请点击右上角的 + 模型 按钮。 在这里,你可以指定以下字段:- 模型名称:模型的可读名称。
- 输入价格:模型每 100 万个输入 token 的成本。该数字会乘以提示中的 token 数量,以计算提示成本。
- 输入价格明细(可选):不同输入 token 类型的价格明细,例如
cache_read、video、audio。 - 输出价格:模型每 100 万个输出 token 的成本。该数字会乘以补全内容中的 token 数量,以计算补全成本。
- 输出价格明细(可选):不同输出 token 类型的价格明细,例如
reasoning、image等。 - 模型启用日期(可选):价格开始生效的日期。只有该日期之后的运行才会应用此模型价格。
- 匹配模式:用于匹配模型名称的正则表达式模式。该模式用于匹配运行元数据中的
ls_model_name值。 - 服务商(可选):模型的服务商。如果指定,则会与运行元数据中的
ls_provider进行匹配。
LLM 调用:直接发送成本
Gemini 2.5 Pro Preview 和 Gemini 2.5 Pro 使用分步成本函数,LangSmith 默认支持该函数。对于其他采用非线性定价的模型,请在客户端计算成本,并按照以下代码所示将其作为usage_metadata 发送:
from langsmith import traceable, get_current_run_tree

inputs = [
    {"role": "system", "content": "你是一个有帮助的助手。"},
    {"role": "user", "content": "我想预订一张两人桌。"},
]

@traceable(
    run_type="llm",
    metadata={"ls_provider": "my_provider", "ls_model_name": "my_model"}
)
def chat_model(messages: list):
    llm_output = {
        "choices": [
            {
                "message": {
                    "role": "assistant",
                    "content": "好的,您想预订几点的桌位?"
                }
            }
        ],
        "usage_metadata": {
            # 指定输入和输出的成本(以美元计)
            "input_cost": 1.1e-6,
            "input_cost_details": {"cache_read": 2.3e-7},
            "output_cost": 5.0e-6,
        },
    }
    run = get_current_run_tree()
    run.set(usage_metadata=llm_output["usage_metadata"])
    return llm_output["choices"][0]["message"]

chat_model(inputs)
import { traceable, getCurrentRunTree } from "langsmith/traceable";

const messages = [
  { role: "system", content: "你是一个有帮助的助手。" },
  { role: "user", content: "我想预订一张两人桌。" }
];

const chatModel = traceable(
  async (messages: { role: string; content: string }[]) => {
    const llmOutput = {
      choices: [
        {
          message: {
            role: "assistant",
            content: "好的,您想预订几点的桌位?",
          },
        },
      ],
      // 指定输入和输出的成本(以美元计)
      usage_metadata: {
        input_cost: 1.1e-6,
        input_cost_details: { cache_read: 2.3e-7 },
        output_cost: 5.0e-6,
      },
    };

    // 将使用量元数据附加到运行
    const runTree = getCurrentRunTree();
    runTree.metadata.usage_metadata = llmOutput.usage_metadata;

    // 仅返回助手消息
    return llmOutput.choices[0].message;
  },
  {
    run_type: "llm",
    name: "chat_model",
    metadata: {
      ls_provider: "my_provider",
      ls_model_name: "my_model",
    },
  }
);

await chatModel(messages);
import com.langchain.smith.client.LangsmithClient;
import com.langchain.smith.client.okhttp.LangsmithOkHttpClient;
import com.langchain.smith.tracing.RunTree;
import com.langchain.smith.tracing.RunType;
import com.langchain.smith.tracing.TraceConfig;
import com.langchain.smith.tracing.Tracing;
import java.util.Arrays;
import java.util.HashMap;
import java.util.List;
import java.util.Map;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.TimeUnit;
import java.util.function.Function;

class CostTrackingLlmCostDirect {
  public static void main(String[] args) throws InterruptedException {
    LangsmithClient langsmith = LangsmithOkHttpClient.fromEnv();
    ExecutorService executor = Executors.newSingleThreadExecutor();

    try {
      List<Map<String, String>> messages =
          Arrays.asList(
              message("system", "You are a helpful assistant."),
              message("user", "I'd like to book a table for two."));

      Map<String, Object> metadata = new HashMap<>();
      metadata.put("ls_provider", "my_provider");
      metadata.put("ls_model_name", "my_model");

      Function<List<Map<String, String>>, Map<String, String>> chatModel =
          Tracing.traceFunction(
              inputMessages -> {
                Map<String, Object> inputCostDetails = new HashMap<>();
                inputCostDetails.put("cache_read", 2.3e-7);

                Map<String, Object> usageMetadata = new HashMap<>();
                usageMetadata.put("input_cost", 1.1e-6);
                usageMetadata.put("input_cost_details", inputCostDetails);
                usageMetadata.put("output_cost", 5.0e-6);

                RunTree run = Tracing.getCurrentRunTree();
                if (run != null) {
                  run.getMetadata().put("usage_metadata", usageMetadata);
                }

                return message(
                    "assistant", "Sure, what time would you like to book the table for?");
              },
              TraceConfig.builder()
                  .name("chat_model")
                  .runType(RunType.LLM)
                  .client(langsmith)
                  .executor(executor)
                  .metadata(metadata)
                  .build());

      chatModel.apply(messages);
    } finally {
      executor.shutdown();
      if (!executor.awaitTermination(10, TimeUnit.SECONDS)) {
        throw new IllegalStateException("Timed out waiting for LangSmith traces to submit");
      }
    }
  }

  private static Map<String, String> message(String role, String content) {
    Map<String, String> message = new HashMap<>();
    message.put("role", role);
    message.put("content", content);
    return message;
  }
}
import com.langchain.smith.client.okhttp.LangsmithOkHttpClient
import com.langchain.smith.tracing.RunType
import com.langchain.smith.tracing.TraceConfig
import com.langchain.smith.tracing.getCurrentRunTree
import com.langchain.smith.tracing.traceable
import java.util.concurrent.Executors
import java.util.concurrent.TimeUnit

val langsmith = LangsmithOkHttpClient.fromEnv()
val executor = Executors.newSingleThreadExecutor()

fun message(role: String, content: String) = mapOf("role" to role, "content" to content)

try {
    val messages =
        listOf(
            message("system", "You are a helpful assistant."),
            message("user", "I'd like to book a table for two."),
        )

    val chatModel =
        traceable(
            { _: List<Map<String, String>> ->
                val usageMetadata =
                    mapOf(
                        "input_cost" to 1.1e-6,
                        "input_cost_details" to mapOf("cache_read" to 2.3e-7),
                        "output_cost" to 5.0e-6,
                    )
                getCurrentRunTree()?.metadata?.put("usage_metadata", usageMetadata)
                message(
                    "assistant",
                    "Sure, what time would you like to book the table for?",
                )
            },
            TraceConfig.builder()
                .name("chat_model")
                .runType(RunType.LLM)
                .client(langsmith)
                .executor(executor)
                .metadata(
                    mapOf(
                        "ls_provider" to "my_provider",
                        "ls_model_name" to "my_model",
                    ),
                )
                .build(),
        )

    chatModel(messages)
} finally {
    executor.shutdown()
    check(executor.awaitTermination(10, TimeUnit.SECONDS)) {
        "Timed out waiting for LangSmith traces to submit"
    }
}
其他运行:发送成本
你还可以为任何非 LLM 运行发送成本信息,例如工具调用。在运行的usage_metadata 中使用 total_cost 字段指定成本:
from langsmith import traceable, get_current_run_tree

# 示例工具:get_weather
@traceable(run_type="tool", name="get_weather")
def get_weather(city: str):
    # 在此编写工具逻辑
    result = {
        "temperature_f": 68,
        "condition": "sunny",
        "city": city,
    }

    # 此工具调用的成本(以任意方式计算)
    tool_cost = 0.0015

    # 将使用量元数据附加到 LangSmith 运行
    run = get_current_run_tree()
    run.set(usage_metadata={"total_cost": tool_cost})

    # 仅返回实际的工具结果(不包含使用量信息)
    return result

tool_response = get_weather("San Francisco")
import { traceable, getCurrentRunTree } from "langsmith/traceable";

// 示例工具:get_weather
const getWeather = traceable(
  async ({ city }) => {
    // 在此编写工具逻辑
    const result = {
      temperature_f: 68,
      condition: "sunny",
      city,
    };

    // 此工具调用的成本(以任意方式计算)
    const toolCost = 0.0015;

    // 将使用量元数据附加到 LangSmith 运行
    const runTree = getCurrentRunTree();
    runTree.metadata.usage_metadata = {
      total_cost: toolCost,
    };

    // 仅返回实际的工具结果(不包含使用量信息)
    return result;
  },
  {
    run_type: "tool",
    name: "get_weather"
  }
);

const toolResponse = await getWeather({ city: "San Francisco" });
import com.langchain.smith.client.LangsmithClient;
import com.langchain.smith.client.okhttp.LangsmithOkHttpClient;
import com.langchain.smith.tracing.RunTree;
import com.langchain.smith.tracing.RunType;
import com.langchain.smith.tracing.TraceConfig;
import com.langchain.smith.tracing.Tracing;
import java.util.HashMap;
import java.util.Map;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.TimeUnit;
import java.util.function.Function;

class CostTrackingToolCostRun {
  public static void main(String[] args) throws InterruptedException {
    LangsmithClient langsmith = LangsmithOkHttpClient.fromEnv();
    ExecutorService executor = Executors.newSingleThreadExecutor();

    try {
      Function<String, Map<String, Object>> getWeather =
          Tracing.traceFunction(
              city -> {
                Map<String, Object> result = new HashMap<>();
                result.put("temperature_f", 68);
                result.put("condition", "sunny");
                result.put("city", city);

                RunTree run = Tracing.getCurrentRunTree();
                if (run != null) {
                  Map<String, Object> usageMetadata = new HashMap<>();
                  usageMetadata.put("total_cost", 0.0015);
                  run.getMetadata().put("usage_metadata", usageMetadata);
                }

                return result;
              },
              TraceConfig.builder()
                  .name("get_weather")
                  .runType(RunType.TOOL)
                  .client(langsmith)
                  .executor(executor)
                  .build());

      Map<String, Object> toolResponse = getWeather.apply("San Francisco");
    } finally {
      executor.shutdown();
      if (!executor.awaitTermination(10, TimeUnit.SECONDS)) {
        throw new IllegalStateException("Timed out waiting for LangSmith traces to submit");
      }
    }
  }
}
import com.langchain.smith.client.okhttp.LangsmithOkHttpClient
import com.langchain.smith.tracing.RunType
import com.langchain.smith.tracing.TraceConfig
import com.langchain.smith.tracing.getCurrentRunTree
import com.langchain.smith.tracing.traceable
import java.util.concurrent.Executors
import java.util.concurrent.TimeUnit

val langsmith = LangsmithOkHttpClient.fromEnv()
val executor = Executors.newSingleThreadExecutor()

try {
    val getWeather =
        traceable(
            { city: String ->
                val result =
                    mapOf(
                        "temperature_f" to 68,
                        "condition" to "sunny",
                        "city" to city,
                    )
                getCurrentRunTree()
                    ?.metadata
                    ?.put("usage_metadata", mapOf("total_cost" to 0.0015))
                result
            },
            TraceConfig.builder()
                .name("get_weather")
                .runType(RunType.TOOL)
                .client(langsmith)
                .executor(executor)
                .build(),
        )

    val toolResponse = getWeather("San Francisco")
} finally {
    executor.shutdown()
    check(executor.awaitTermination(10, TimeUnit.SECONDS)) {
        "Timed out waiting for LangSmith traces to submit"
    }
}
usage_metadata:
from langsmith import traceable

# 示例工具:get_weather
@traceable(run_type="tool", name="get_weather")
def get_weather(city: str):
    # 在此编写工具逻辑
    result = {
        "temperature_f": 68,
        "condition": "sunny",
        "city": city,
    }

    # 在此附加工具调用成本
    return {
        **result,
        "usage_metadata": {
            "total_cost": 0.0015,   # <-- 此工具调用的成本
        },
    }

tool_response = get_weather("San Francisco")
import { traceable } from "langsmith/traceable";

// 示例工具:get_weather
const getWeather = traceable(
  async ({ city }) => {
    // 在此编写工具逻辑
    const result = {
      temperature_f: 68,
      condition: "sunny",
      city,
    };

    // 在此附加工具调用成本
    return {
      ...result,
      usage_metadata: {
        total_cost: 0.0015,  // <-- 此工具调用的成本
      },
    };
  },
  {
    run_type: "tool",
    name: "get_weather"
  }
);

const toolResponse = await getWeather({ city: "San Francisco" });
import com.langchain.smith.client.LangsmithClient;
import com.langchain.smith.client.okhttp.LangsmithOkHttpClient;
import com.langchain.smith.tracing.RunType;
import com.langchain.smith.tracing.TraceConfig;
import com.langchain.smith.tracing.Tracing;
import java.util.HashMap;
import java.util.Map;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.TimeUnit;
import java.util.function.Function;

class CostTrackingToolCostOutput {
  public static void main(String[] args) throws InterruptedException {
    if (System.getenv("LANGSMITH_API_KEY") == null
        || System.getenv("LANGSMITH_API_KEY").isBlank()) {
      System.out.println(
          "[cost-tracking-tool-cost-output] Skipping (LANGSMITH_API_KEY is not set).");
      return;
    }

    LangsmithClient langsmith = LangsmithOkHttpClient.fromEnv();
    ExecutorService executor = Executors.newSingleThreadExecutor();

    try {
      Function<String, Map<String, Object>> getWeather =
          Tracing.traceFunction(
              city -> {
                Map<String, Object> result = new HashMap<>();
                result.put("temperature_f", 68);
                result.put("condition", "sunny");
                result.put("city", city);

                Map<String, Object> usageMetadata = new HashMap<>();
                usageMetadata.put("total_cost", 0.0015);
                result.put("usage_metadata", usageMetadata);
                return result;
              },
              TraceConfig.builder()
                  .name("get_weather")
                  .runType(RunType.TOOL)
                  .client(langsmith)
                  .executor(executor)
                  .build());

      Map<String, Object> toolResponse = getWeather.apply("San Francisco");
    } finally {
      executor.shutdown();
      if (!executor.awaitTermination(10, TimeUnit.SECONDS)) {
        throw new IllegalStateException("Timed out waiting for LangSmith traces to submit");
      }
    }
  }
}
import com.langchain.smith.client.okhttp.LangsmithOkHttpClient
import com.langchain.smith.tracing.RunType
import com.langchain.smith.tracing.TraceConfig
import com.langchain.smith.tracing.traceable
import java.util.concurrent.Executors
import java.util.concurrent.TimeUnit

val langsmith = LangsmithOkHttpClient.fromEnv()
val executor = Executors.newSingleThreadExecutor()

try {
    val getWeather =
        traceable(
            { city: String ->
                mapOf(
                    "temperature_f" to 68,
                    "condition" to "sunny",
                    "city" to city,
                    "usage_metadata" to mapOf("total_cost" to 0.0015),
                )
            },
            TraceConfig.builder()
                .name("get_weather")
                .runType(RunType.TOOL)
                .client(langsmith)
                .executor(executor)
                .build(),
        )

    val toolResponse = getWeather("San Francisco")
} finally {
    executor.shutdown()
    check(executor.awaitTermination(10, TimeUnit.SECONDS)) {
        "Timed out waiting for LangSmith traces to submit"
    }
}
Connect these docs to Claude, VSCode, and more via MCP for real-time answers.