

- 短期记忆,或称线程范围的记忆,通过在一个会话内维护消息历史来跟踪持续进行的对话。LangGraph 将短期记忆作为代理状态的一部分进行管理。状态通过检查点保存器持久化到数据库中,因此线程可以随时恢复。短期记忆在图被调用或步骤完成时更新,并且在每个步骤开始时读取状态。
- 长期记忆存储跨会话的、用户特定或应用级的数据,并且可以跨对话线程共享。它可以在_任何时间_和_任何线程_中被回忆。记忆的作用域可以是任何自定义命名空间,而不仅限于单个线程 ID。LangGraph 提供了存储(参考文档),以便您保存和回忆长期记忆。
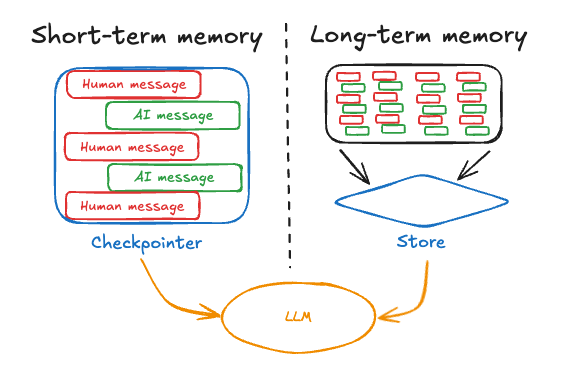
短期记忆
短期记忆让您的应用程序能够记住单个线程或对话内的先前交互。一个线程组织了一个会话中的多次交互,类似于电子邮件在一个对话中对消息进行分组的方式。 LangGraph 将短期记忆作为代理状态的一部分进行管理,并通过线程范围的检查点进行持久化。此状态通常包括对话历史记录以及其他状态数据,例如上传的文件、检索到的文档或生成的工件。通过将这些数据存储在图的状态中,机器人可以在为不同线程保持隔离的同时,访问给定对话的完整上下文。管理短期记忆
对话历史是短期记忆最常见的形式,而长对话给当今的大语言模型带来了挑战。完整的对话历史可能无法放入大语言模型的上下文窗口中,从而导致不可恢复的错误。即使您的大语言模型支持完整的上下文长度,大多数大语言模型在长上下文中的表现仍然不佳。它们可能会被陈旧或不相关的内容“分散注意力”,同时响应时间更慢且成本更高。 聊天模型通过消息接受上下文,这些消息包括开发者提供的指令(系统消息)和用户输入(用户消息)。在聊天应用中,消息在用户输入和模型响应之间交替出现,导致消息列表随时间推移越来越长。由于上下文窗口是有限的,且包含大量标记的消息列表可能成本高昂,因此许多应用程序可以通过使用技术手动移除或遗忘陈旧信息来获益。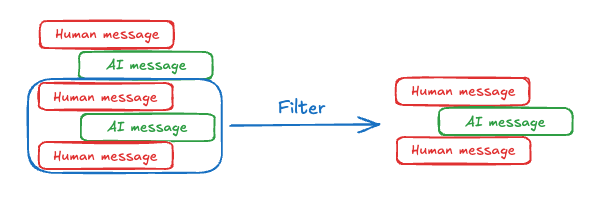 有关管理消息的常见技术的更多信息,请参阅添加和管理记忆指南。
长期记忆
LangGraph 中的长期记忆允许系统在不同的对话或会话中保留信息。与作用域为线程的短期记忆不同,长期记忆保存在自定义的“命名空间”中。 长期记忆是一个没有放之四海而皆准的解决方案的复杂挑战。然而,以下问题提供了一个框架,帮助您探索不同的技术:- 记忆的类型是什么?人类使用记忆来记住事实(语义记忆)、经历(情景记忆)和规则(程序性记忆)。人工智能代理可以以相同的方式使用记忆。例如,人工智能代理可以使用记忆来记住关于用户的特定事实以完成任务。
- 您希望何时更新记忆? 记忆可以作为代理应用程序逻辑的一部分进行更新(例如,“在主要路径上”)。在这种情况下,代理通常在响应用户之前决定记住事实。或者,记忆可以作为后台任务(在后台/异步运行并生成记忆的逻辑)进行更新。我们在下文中解释了这些方法之间的权衡。
语义记忆
语义记忆,无论是对于人类还是人工智能代理,都涉及对特定事实和概念的保留。对于人类,它可以包括在学校学到的信息以及对概念及其关系的理解。对于人工智能代理,语义记忆通常用于通过记住来自过往交互的事实或概念来个性化应用程序。语义记忆与“语义搜索”不同,后者是一种使用“含义”(通常表示为嵌入)来查找相似内容的技术。语义记忆是心理学中的一个术语,指的是存储事实和知识,而语义搜索是一种基于含义(而非精确匹配)来检索信息的方法。
个人资料
记忆可以是一个持续更新的、关于用户、组织或其他实体(包括代理本身)的范围明确且具体的单一“个人资料”。个人资料通常只是一个 JSON 文档,其中包含您为表示您的领域而选择的各种键值对。 当记忆一个个人资料时,您需要确保每次都更新该资料。因此,您需要传入先前的个人资料并要求模型生成新的个人资料(或一些可以应用到旧个人资料的 JSON 补丁)。随着个人资料变大,这可能会变得容易出错,并且可能需要将个人资料拆分为多个文档,或在生成文档时使用严格解码以确保记忆模式保持有效。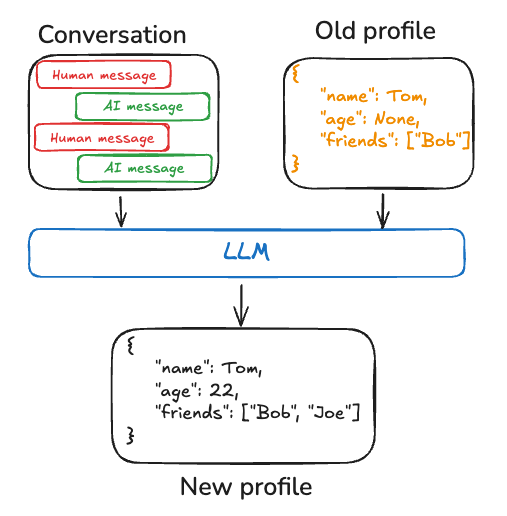
集合
或者,记忆可以是一个持续更新和扩展的文档集合。每个单独的记忆范围更窄,更容易生成,这意味着您不太可能随时间丢失信息。对于大语言模型来说,为新信息生成_新_对象比将新信息与现有个人资料进行协调要容易。因此,文档集合往往会导致下游更高的召回率。 然而,这会将一些复杂性转移到记忆更新上。模型现在必须_删除_或_更新_列表中的现有项目,这可能会很棘手。此外,某些模型可能默认过度插入,而其他模型可能默认过度更新。请参阅 Trustcall 包以了解管理此问题的一种方法,并考虑进行评估(例如使用 LangSmith 等工具)以帮助您调整行为。 使用文档集合还将复杂性转移到了对列表的记忆搜索上。Store 目前同时支持语义搜索和按内容过滤。
最后,使用记忆集合可能会使向模型提供全面的上下文变得具有挑战性。虽然单个记忆可能遵循特定的模式,但这种结构可能无法捕获记忆之间的完整上下文或关系。因此,在使用这些记忆生成响应时,模型可能缺少在统一个人资料方法中更容易获得的重要上下文信息。
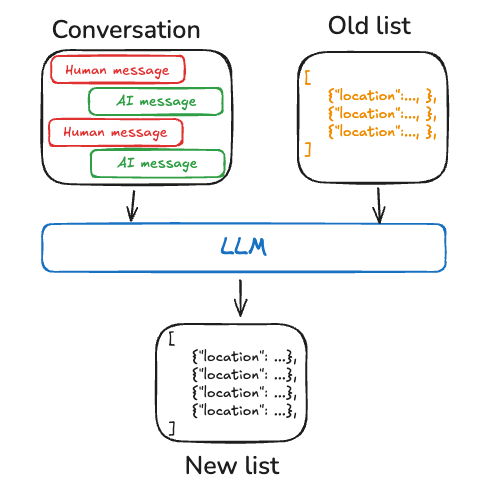 无论采用何种记忆管理方法,核心点在于代理将使用语义记忆来支持其响应,这通常会导致更个性化和相关的交互。
情景记忆
情景记忆,无论是对于人类还是人工智能代理,都涉及回忆过去的事件或动作。CoALA 论文对此进行了很好的阐述:事实可以写入语义记忆,而经历可以写入情景记忆。对于人工智能代理,情景记忆通常用于帮助代理记住如何完成一项任务。 在实践中,情景记忆通常通过小样本示例提示来实现,代理从中学习过去的操作序列以正确执行任务。有时“展示”比“告诉”更容易,大语言模型能很好地从示例中学习。小样本学习让您可以通过用输入-输出示例更新提示来“编程”您的大语言模型,以说明预期行为。虽然可以使用各种最佳实践来生成小样本示例,但挑战通常在于根据用户输入选择最相关的示例。 请注意,记忆存储只是将数据存储为小样本示例的一种方式。如果您希望更多开发者参与,或让小样本示例与您的评估工具更紧密地结合,您也可以使用 LangSmith 数据集来存储您的数据,并实现您自己的检索逻辑,以根据用户输入选择最相关的示例。 请参阅这篇博客文章,其中展示了使用小样本提示来提升工具调用性能;以及这篇博客文章,其中使用小样本示例来使大语言模型与人类偏好保持一致。程序性记忆
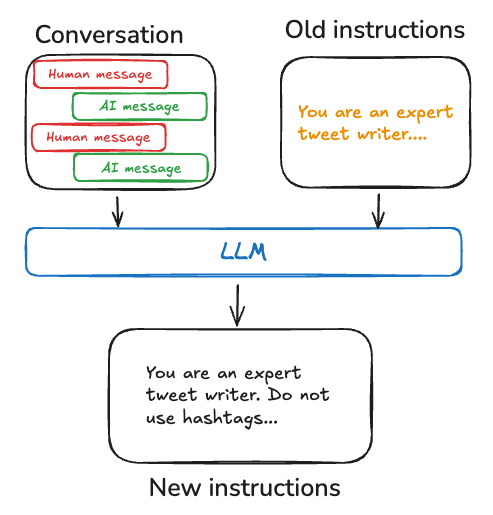
程序性记忆,无论是对于人类还是人工智能代理,都涉及记住用于执行任务的规则。对于人类,程序性记忆就像内化了如何执行任务的知识,例如通过基本的运动技能和平衡来骑自行车。另一方面,情景记忆涉及回忆具体经历,例如第一次成功在没有辅助轮的情况下骑自行车,或一次风景优美的难忘骑行。对于人工智能代理,程序性记忆是模型权重、代理代码和代理提示的组合,它们共同决定了代理的功能。 在实践中,代理修改其模型权重或重写代码的情况相当少见。然而,代理修改自身提示词的情况更为常见。 优化代理指令的一种有效方法是通过“反思”或元提示。这涉及向代理提供其当前的指令(例如系统提示词)以及最近的对话或明确的用户反馈。然后,代理根据此输入优化自己的指令。这种方法对于难以预先指定指令的任务特别有用,因为它允许代理从交互中学习和适应。 例如,我们构建了一个 Tweet 生成器,利用外部反馈和提示词重写来为 Twitter 生成高质量的论文摘要。在这个例子中,具体的摘要提示词很难先验地指定,但用户很容易对生成的推文提出批评,并就如何改进摘要过程提供反馈。 下面的伪代码展示了如何使用 LangGraph 记忆存储来实现这一点:使用存储来保存提示词,update_instructions 节点获取当前提示词(以及从 state["messages"] 中捕获的与用户对话的反馈),更新提示词,并将新提示词保存回存储。然后,call_model 从存储中获取更新后的提示词,并使用它来生成响应。
写入记忆
代理写入记忆主要有两种方法:“在主要路径上”和“在后台”。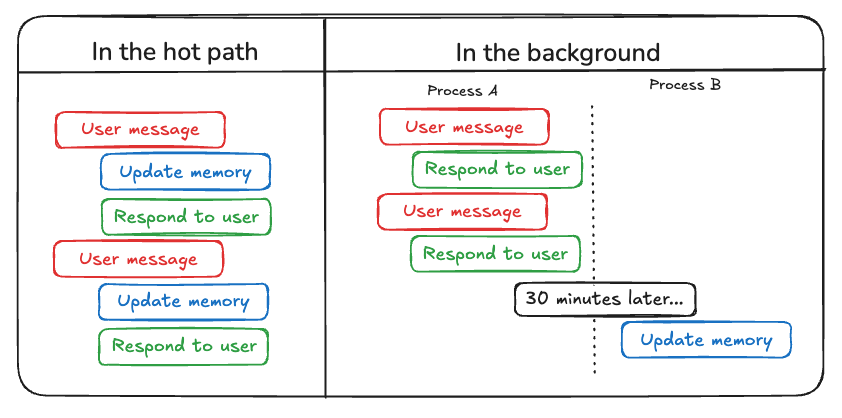
在主要路径上
在运行时创建记忆既有优势也有挑战。积极的一面是,这种方法允许实时更新,使新记忆可以立即用于后续交互。它还支持透明性,因为可以在记忆被创建和存储时通知用户。 然而,这种方法也存在挑战。如果代理需要一个新工具来决定提交什么到记忆中,可能会增加复杂性。此外,推理要保存什么到记忆的过程会影响代理的延迟。最后,代理必须在创建记忆和其他职责之间多任务处理,可能影响所创建记忆的数量和质量。 例如,ChatGPT 使用了一个 save_memories 工具来将记忆作为内容字符串进行插入或更新,并在每条用户消息中决定是否以及如何使用此工具。请参阅我们的 memory-agent 模板作为参考实现。在后台
将记忆创建作为独立的后台任务具有几个优势。它消除了主要应用程序的延迟,将应用程序逻辑与记忆管理分离,并允许代理更专注于完成任务。这种方法还提供了灵活安排记忆创建时间的灵活性,以避免冗余工作。 然而,这种方法也有其自身的挑战。确定写入记忆的频率变得至关重要,因为不频繁的更新可能使其他线程缺乏新的上下文。决定何时触发记忆形成也很重要。常见策略包括在设定的时间段后安排(如果发生新事件则重新安排)、使用定时任务计划,或允许用户或应用程序逻辑手动触发。 请参阅我们的 memory-service 模板作为参考实现。记忆存储
LangGraph 将长期记忆作为 JSON 文档存储在存储中。每个记忆都组织在一个自定义的namespace(类似文件夹)和一个独特的 key(类似文件名)下。命名空间通常包括用户或组织 ID 或其他标签,以便于组织信息。这种结构实现了记忆的分层组织。然后,通过内容过滤器支持跨命名空间搜索。
了解更多
Connect these docs to Claude, VSCode, and more via MCP for real-time answers.