

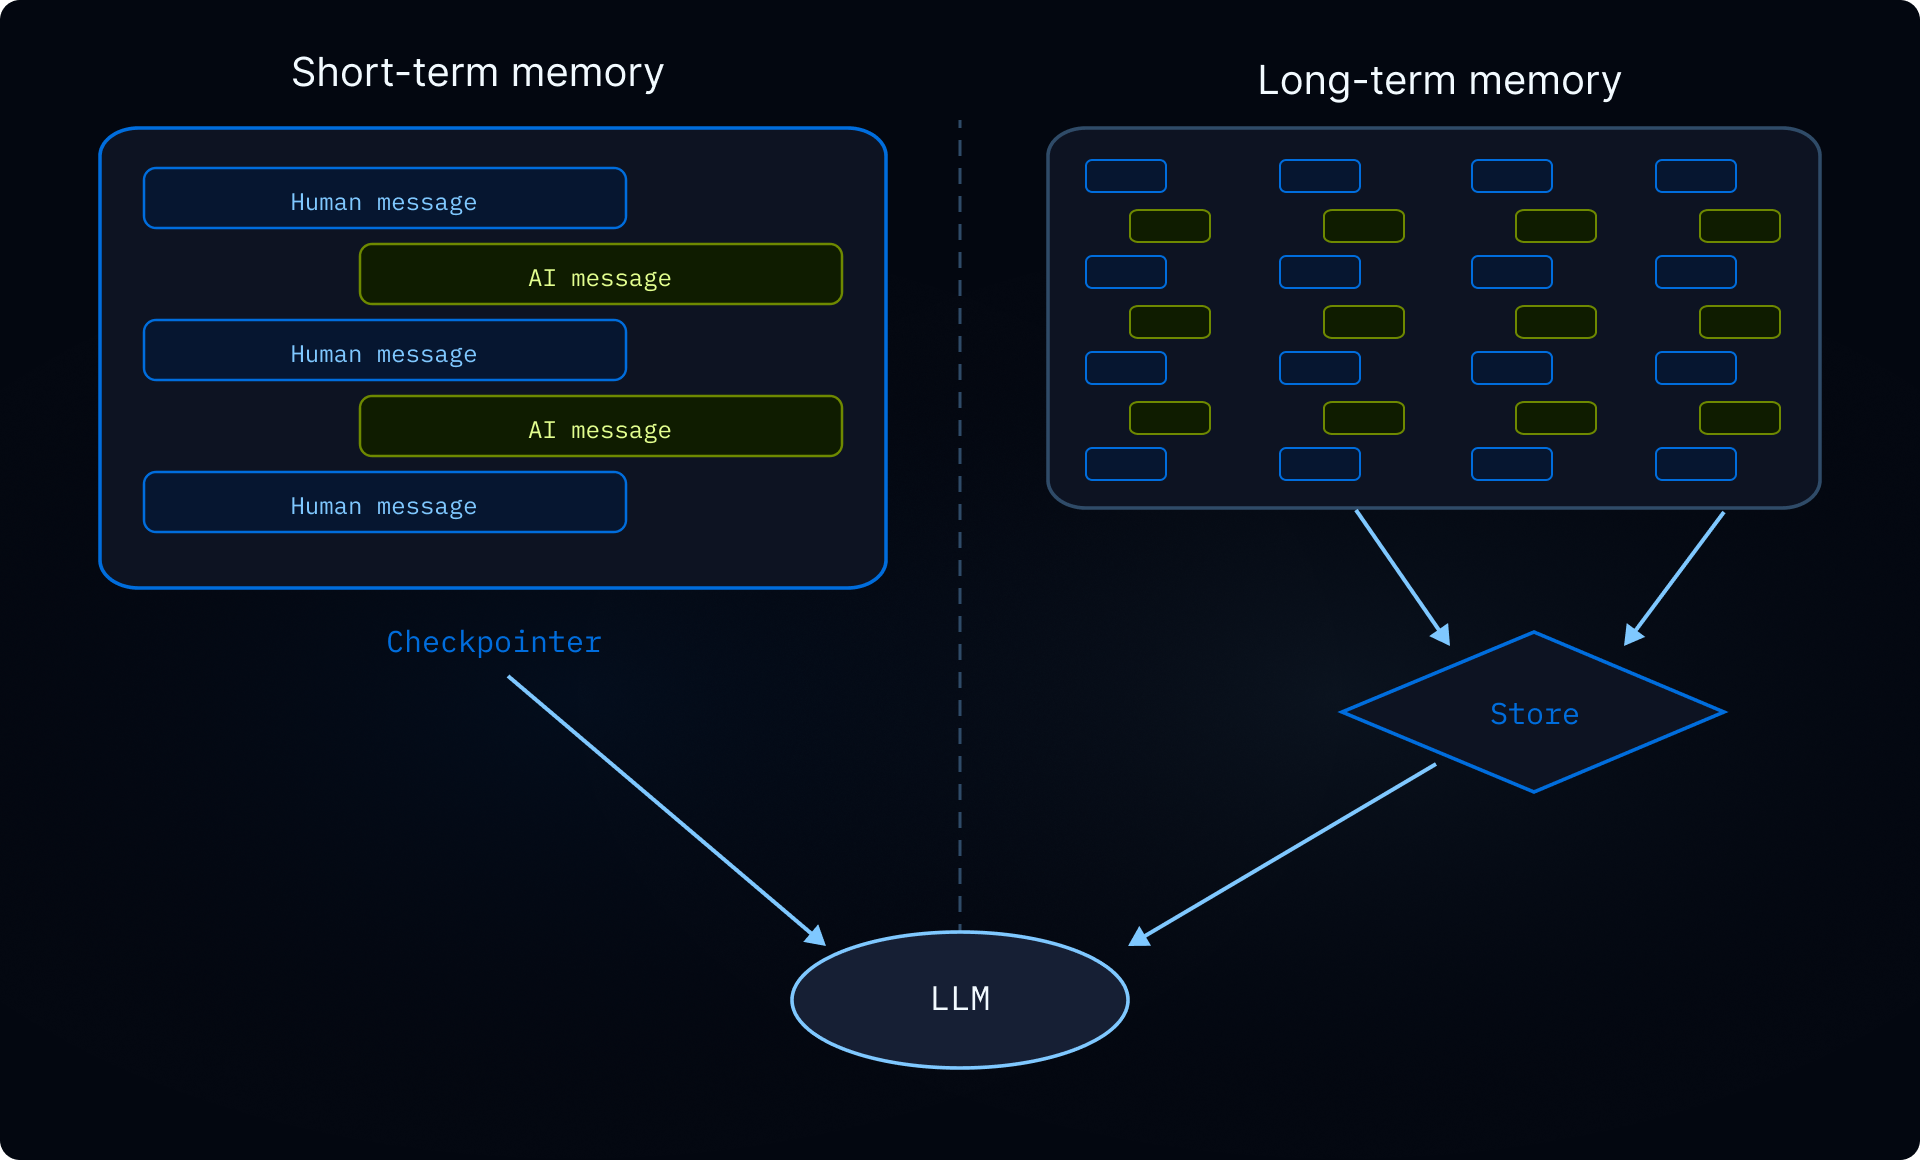
内存工作原理
- 将智能体指向内存文件。 创建智能体时,将文件路径传递给
memory=参数。你也可以通过skills=传递技能,这用于程序性内存(告诉智能体如何执行任务的可重用指令)。后端控制文件的存储位置以及谁可以访问它们。 - 智能体读取内存。 智能体可以在启动时将内存文件加载到系统提示中,或者在对话过程中按需读取它们。例如,技能使用按需加载:智能体在启动时只读取技能描述,然后仅在匹配任务时才读取完整的技能文件。这保持了上下文在需要特定能力前保持精简。
- 智能体更新内存(可选)。 当智能体学到新信息时,它可以使用内置的
edit_file工具来更新内存文件。更新可以在对话过程中发生(默认方式),也可以通过后台整合在对话间隙的后台进行。更改会被持久化,并在下次对话中可用。并非所有内存都是可写的:开发者定义的技能和组织策略通常是只读的。详情请参见只读内存与可写内存。
作用域内存
智能体内存可以设置作用域,使得相同的内存文件可被所有使用该智能体的人访问,或者内存文件可对每个用户独立。智能体作用域内存
赋予智能体一个随时间演变的持久身份。智能体作用域内存在所有用户之间共享,因此智能体通过每次对话积累其自身的人格、知识和学习到的偏好。随着它与用户互动,它会发展专业知识、改进方法并记住有效的方法。当它有写权限时,也可以学习和更新技能。 关键是后端的命名空间:将其设置为(assistant_id,) 意味着该智能体的每次对话都读写同一个内存文件。
访问
rt.serverInfo 需要 deepagents>=1.9.0。在较旧版本中,请改为从 getConfig().metadata.assistantId 读取助手 ID。完整示例:初始化内存并调用
完整示例:初始化内存并调用
向存储区填充初始内存,然后在两个线程中调用智能体,观察它如何记忆和更新所学到的内容。
用户作用域内存
为每个用户提供其自己的内存文件。智能体按用户记忆偏好、上下文和历史,同时核心智能体指令保持固定。如果存储在用户作用域的后端中,用户也可以拥有各自的技能。 命名空间使用(user_id,),因此每个用户都获得内存文件的独立副本。用户 A 的偏好永远不会泄露到用户 B 的对话中。
完整示例:跨用户的隔离内存
完整示例:跨用户的隔离内存
为不同用户初始化独立的内存,并以两个不同用户的身份调用智能体。每个用户只能看到自己的偏好。
高级用法
除了内存路径和作用域的基本配置选项外,你还可以为内存配置更高级的参数:情景性内存
情景性内存存储过往经历的记录:发生了什么、顺序如何以及结果是什么。与语义性内存(存储在AGENTS.md 等文件中的事实和偏好)不同,情景性内存保留了完整的对话上下文,因此智能体可以回忆起问题是如何解决的,而不仅仅是从中学到了什么。
Deep Agents 已经使用了支持情景性内存的机制:检查点:每个对话都被持久化为一个带检查点的线程。
为了使过往对话可搜索,可以将线程搜索封装在一个工具中。user_id 从运行时上下文中获取,而不是作为参数传递:
组织级内存
组织级内存遵循与用户作用域内存相同的模式,但使用全组织范围的命名空间,而不是每个用户一个。它用于应适用于组织中所有用户和智能体的策略或知识。 组织内存通常是只读的,以防止通过共享状态进行提示注入。详情请参见只读内存与可写内存。后台整合
默认情况下,智能体在对话期间(热路径)写入内存。另一种方式是将内存作为后台任务在对话间隙进行处理,有时称为睡眠时间计算。一个单独的深度智能体会审查最近的对话,提取关键事实,并将其与现有内存合并。
对于大多数应用程序,热路径就足够了。当你需要减少延迟或提高跨多次对话的内存质量时,请添加后台整合。
推荐的模式是在你的主智能体旁边部署一个整合智能体——一个深度智能体,读取最近的对话历史,提取关键事实,并将它们合并到内存存储区中——并使用定时任务来触发它。选择一个能反映用户实际与智能体交互频率的节拍:具有稳定每日流量的聊天产品可能每隔几小时整合一次,而每周只使用几次的工具只需每晚或每周运行一次。比用户对话频率高得多的整合只会浪费代币在无操作的运行上。
整合智能体
整合智能体读取最近的对话历史,并将关键事实合并到内存存储区中。在langgraph.json 中将其与主智能体一起注册:
src/consolidation-agent.ts
langgraph.json
定时任务
定时任务按固定计划运行整合智能体。智能体搜索最近的对话并将其综合到内存中。将计划与你的使用模式相匹配,使整合运行大致跟踪实际活动。 使用定时任务安排整合智能体:所有定时计划均以 UTC 解释。有关管理和删除定时任务的详情,请参见定时任务。
只读内存与可写内存
默认情况下,智能体可以读写内存文件。对于共享状态(如组织策略或合规规则),你可能希望将内存设置为只读,以便智能体可以引用但不能修改它。这可以防止通过共享内存进行提示注入,并确保只有你的应用程序代码控制文件中的内容。
安全考虑: 如果一个用户可以写入另一个用户读取的内存,恶意用户可能向共享状态注入指令。为了缓解:
- 默认使用用户作用域
(user_id),除非你有特定原因需要共享。 - 对共享策略使用只读内存(通过应用程序代码填充,而不是智能体)。
- 在智能体写入共享内存之前添加人在回路验证。使用中断来要求人工批准对敏感路径的写入。
并发写入
多个线程可以并行写入内存,但对同一文件的并发写入可能导致最后写入者胜出的冲突。对于用户作用域内存,这种情况很少见,因为用户通常一次只有一个活跃对话。对于智能体作用域或组织作用域内存,考虑使用后台整合来串行化写入,或将内存组织为按主题分隔的独立文件以减少争用。 实际上,如果写入因冲突而失败,LLM 通常足够聪明,可以重试或优雅地恢复,因此单次丢失的写入并非灾难性的。同一部署中的多个智能体
要在共享部署中为每个智能体提供自己的内存,请在命名空间中添加assistant_id:
assistant_id。
Connect these docs to Claude, VSCode, and more via MCP for real-time answers.