

为什么使用多代理?
当开发者说需要“多代理”时,通常是在寻找以下一种或多种能力:- 上下文管理:提供专门知识,同时不压垮模型的上下文窗口。如果上下文无限且延迟为零,你可以把所有知识都放进一个提示词;但现实并非如此,因此需要用模式来选择性地呈现相关信息。
- 分布式开发:让不同团队独立开发和维护能力,并以清晰边界组合成更大的系统。
- 并行化:为子任务生成专门工作单元,并并发执行以更快获得结果。
模式
以下是构建多代理系统的主要模式,每种模式都适用于不同用例:选择模式
使用下表将需求匹配到合适模式:- 分布式开发:不同团队是否可以独立维护组件?
- 并行化:多个代理是否可以并发执行?
- 多跳:该模式是否支持串行调用多个子代理?
- 直接用户交互:子代理是否可以直接与用户对话?
可视化概览
- Subagents
- Handoffs
- Skills
- Router
主代理将子代理作为工具进行协调。所有路由都经过主代理。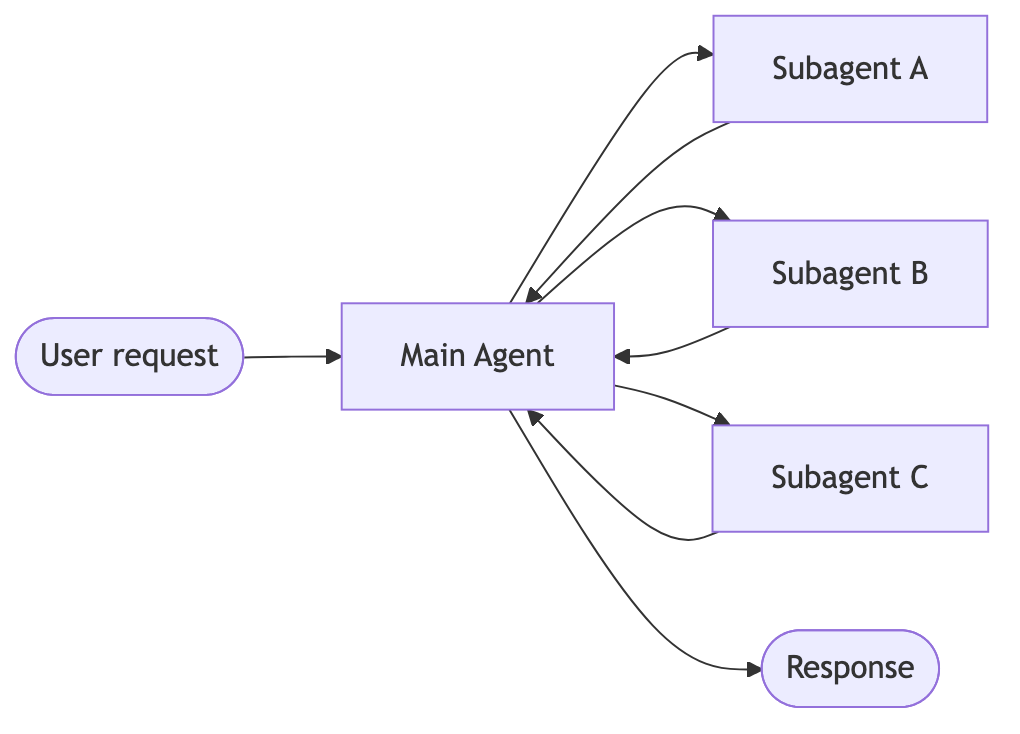
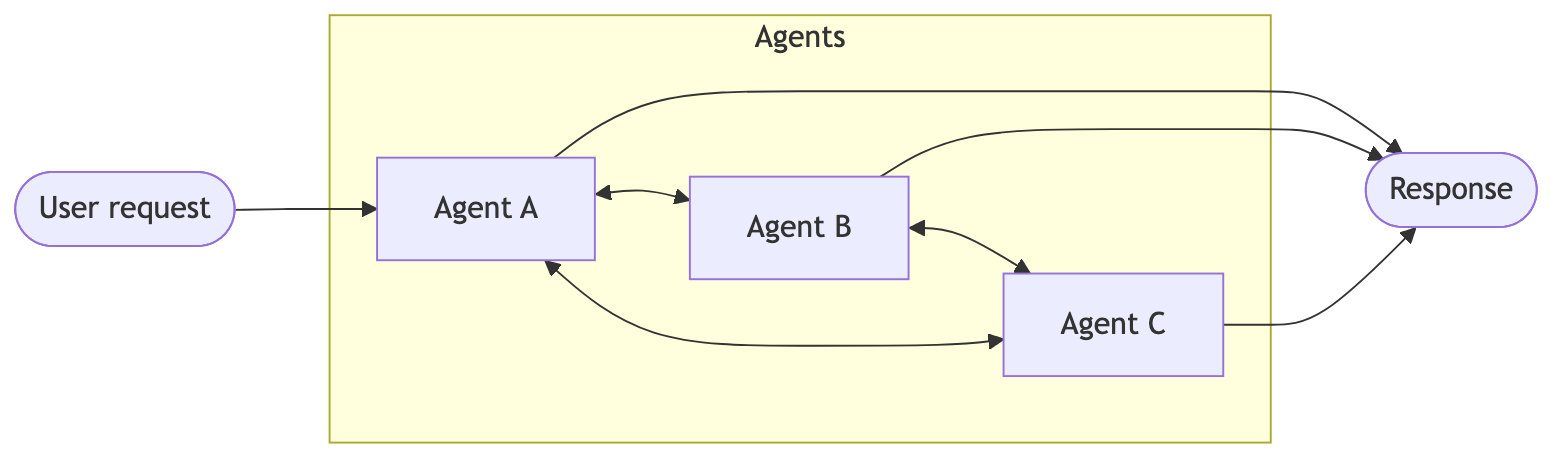
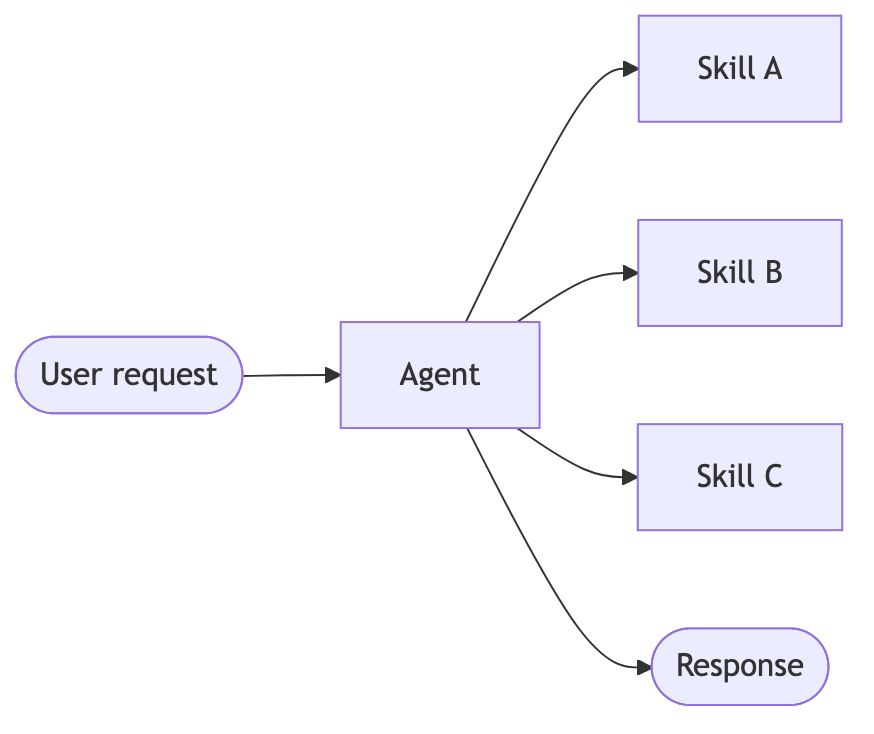
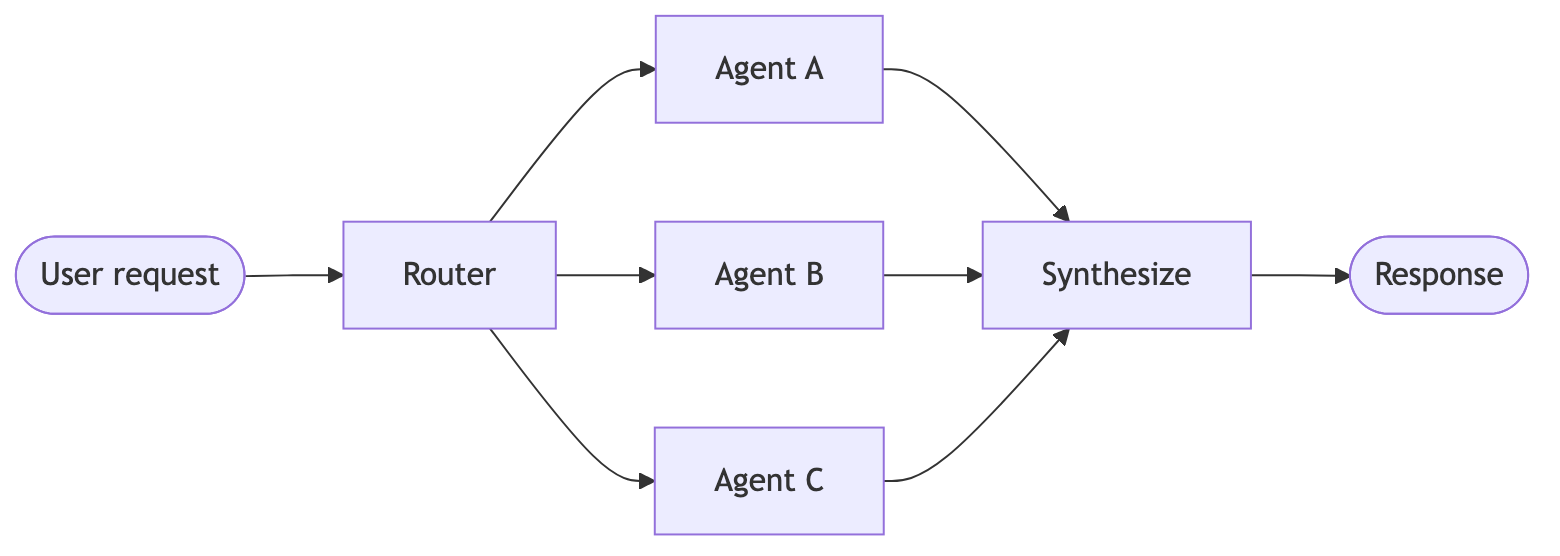
性能对比
不同模式具有不同性能特征。了解这些权衡有助于根据延迟和成本需求选择合适模式。 关键指标:- 模型调用:LLM 调用次数。调用越多,延迟越高(尤其是串行调用时),每次请求的 API 成本也越高。
- 处理的 token:所有调用中的总上下文窗口使用量。token 越多,处理成本越高,也越可能触及上下文限制。
一次性请求
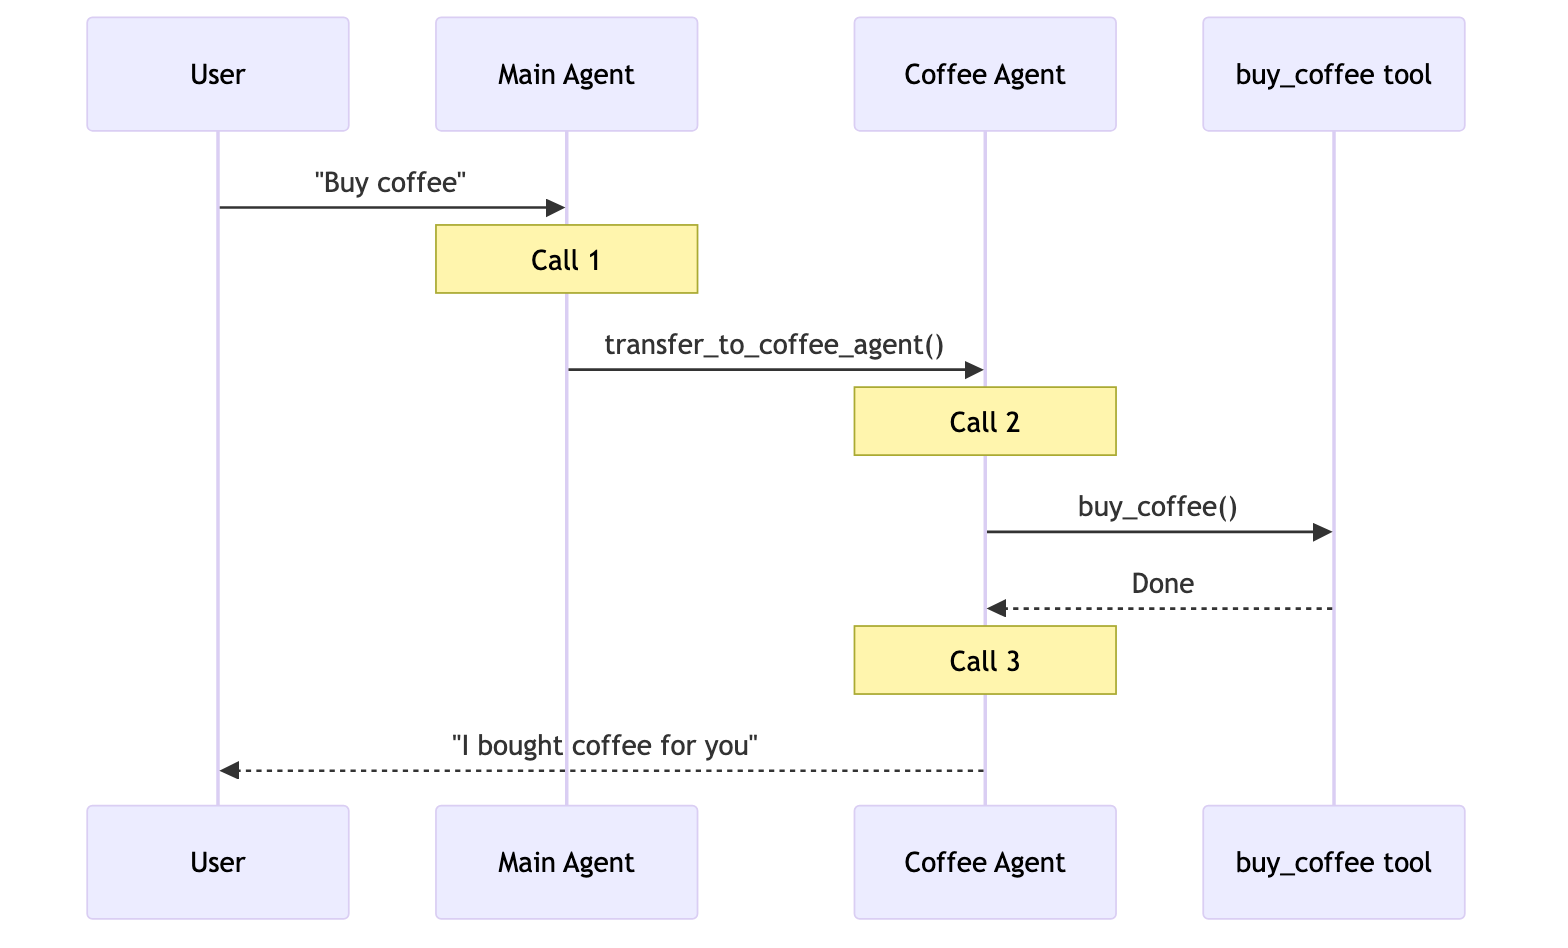
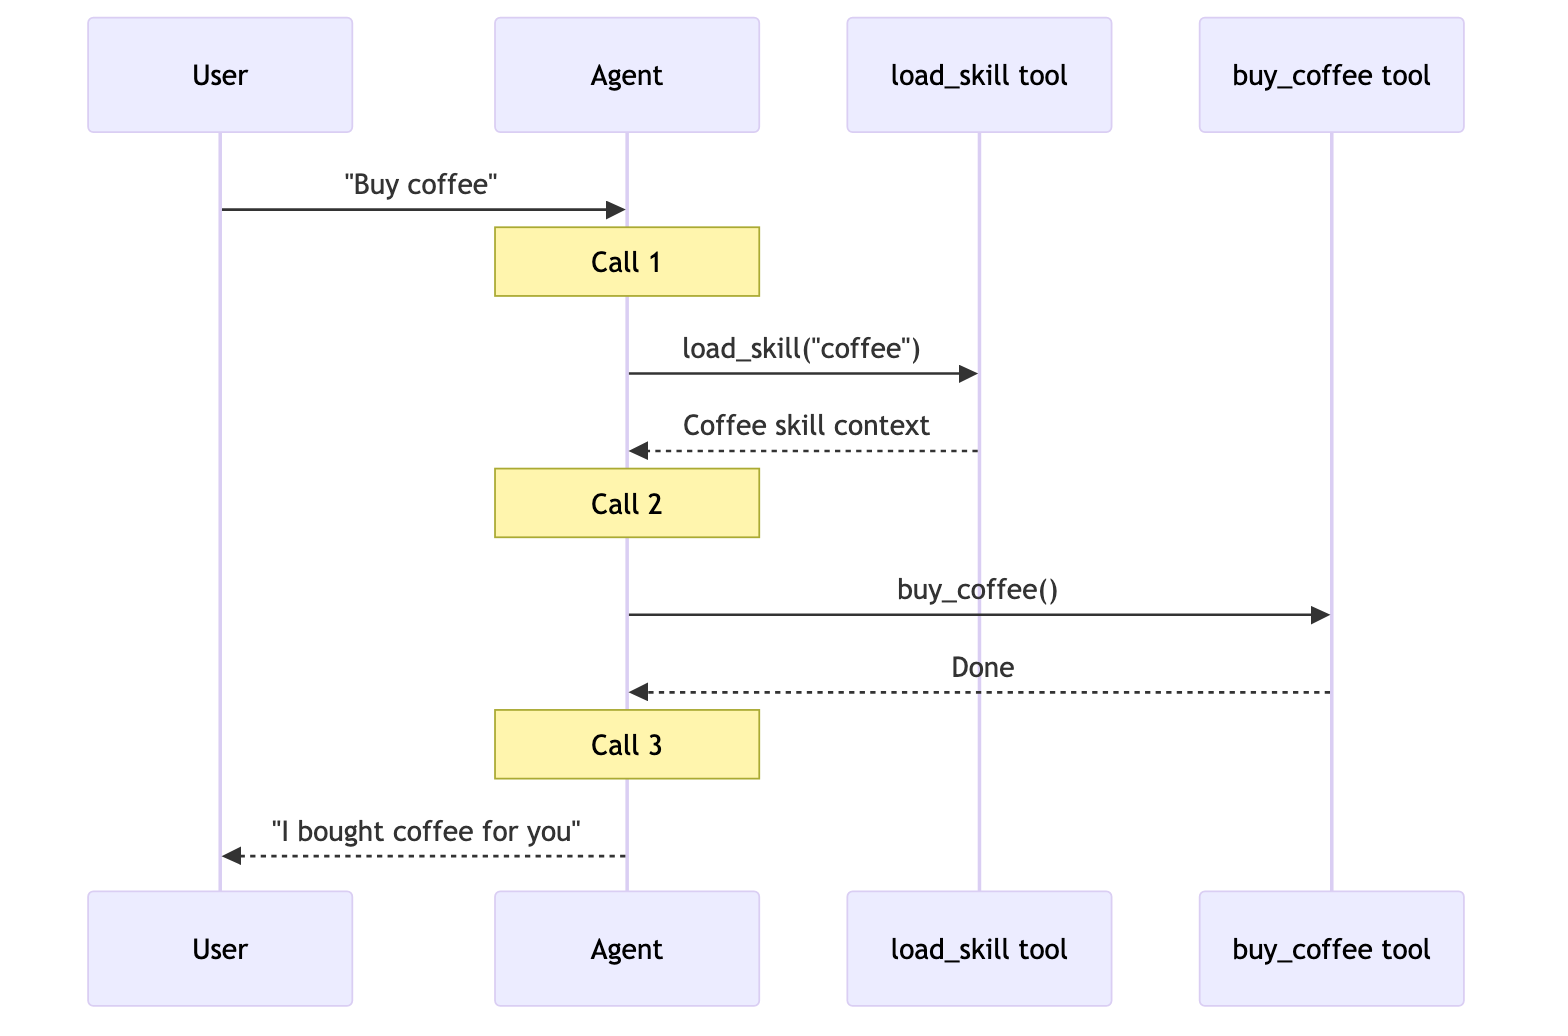
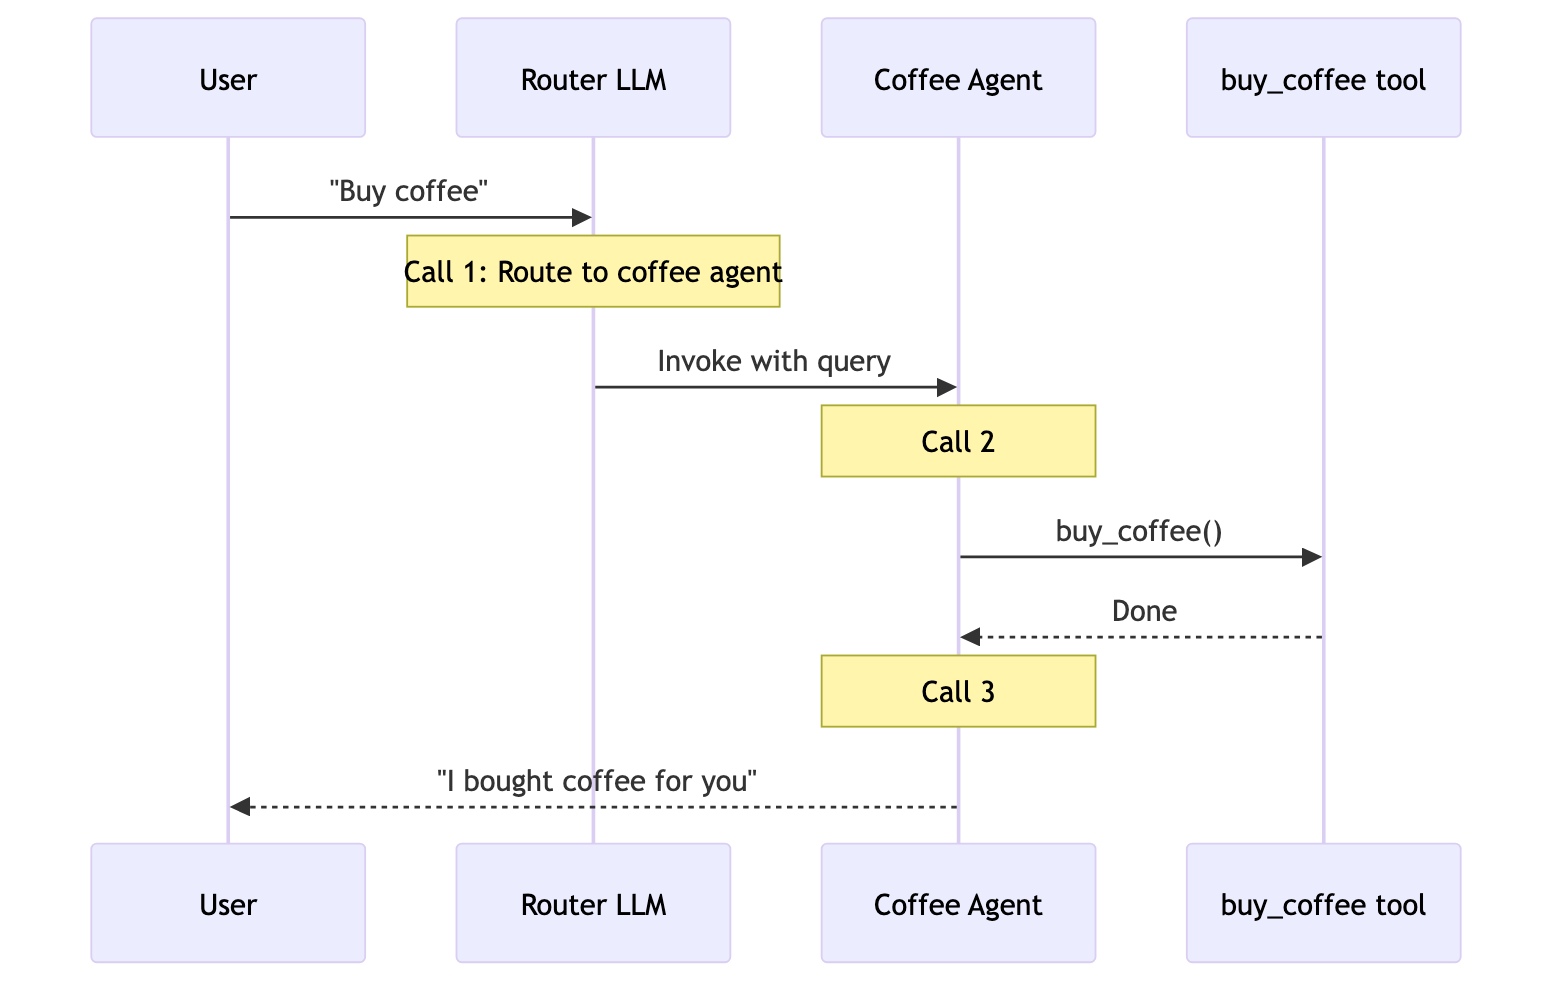
用户: “Buy coffee”专门的咖啡代理或技能可以调用
buy_coffee 工具。
- Subagents
- Handoffs
- Skills
- Router
4 次模型调用: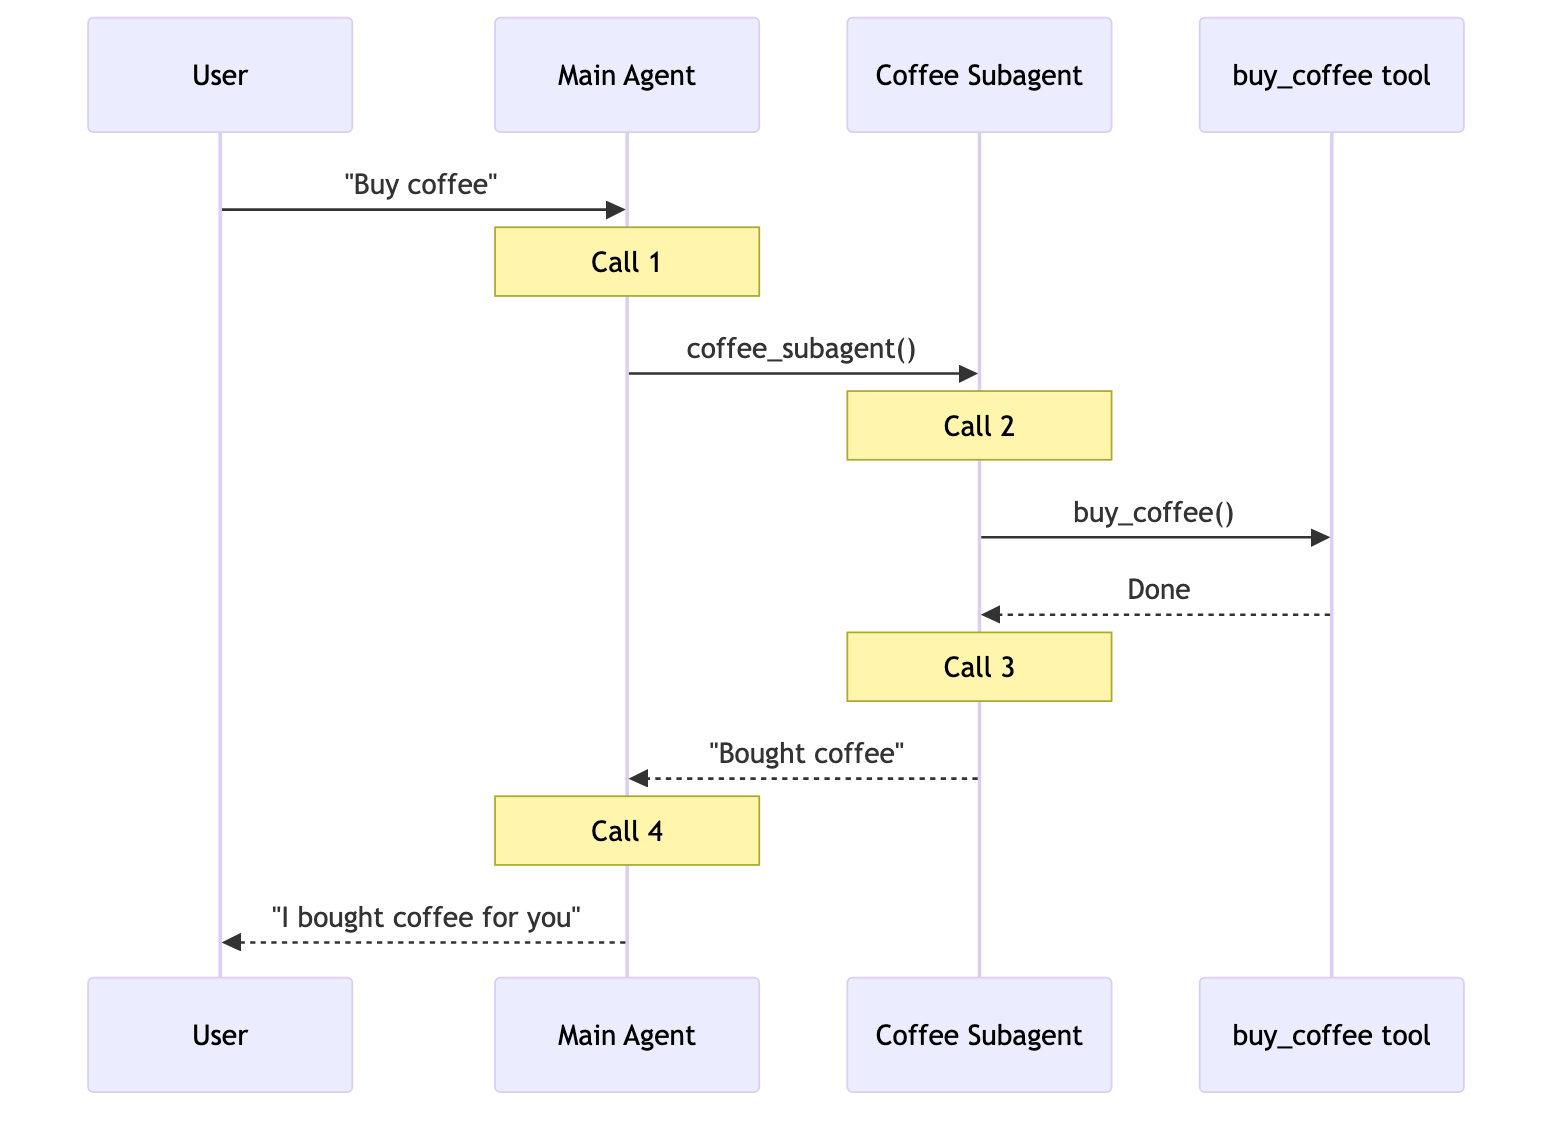
重复请求
第 1 轮: “Buy coffee” 第 2 轮: “Buy coffee again”用户在同一对话中重复相同请求。
- Subagents
- Handoffs
- Skills
- Router
再次 4 次调用 → 总计 8 次
- Subagents 设计上是无状态的,每次调用都遵循相同流程
- 主代理维护对话上下文,但子代理每次都会从全新状态开始
- 这提供了强上下文隔离,但会重复完整流程
多领域
用户: “Compare Python, JavaScript, and Rust for web development”每个语言代理或技能都包含约 2000 个 token 的文档。所有模式都可以进行并行工具调用。
- Subagents
- Handoffs
- Skills
- Router
5 次调用,约 9K token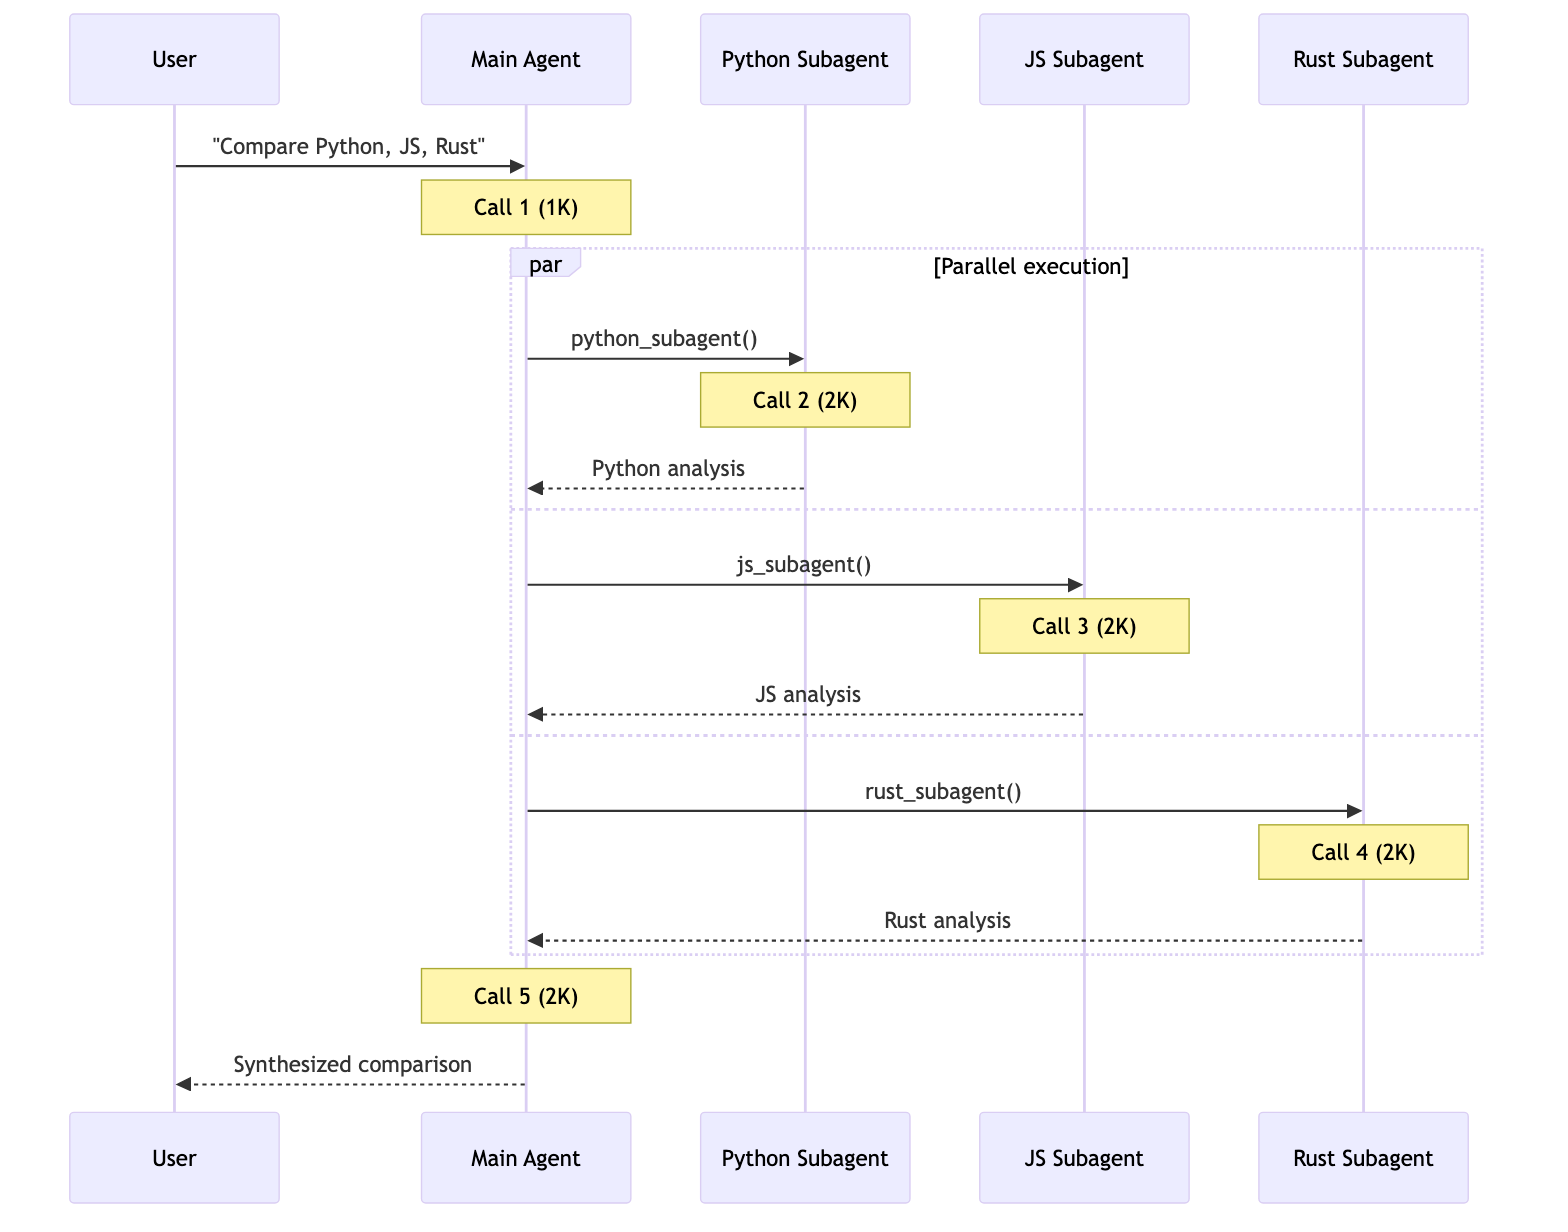 每个子代理只在相关上下文中隔离工作。总计:9K token。
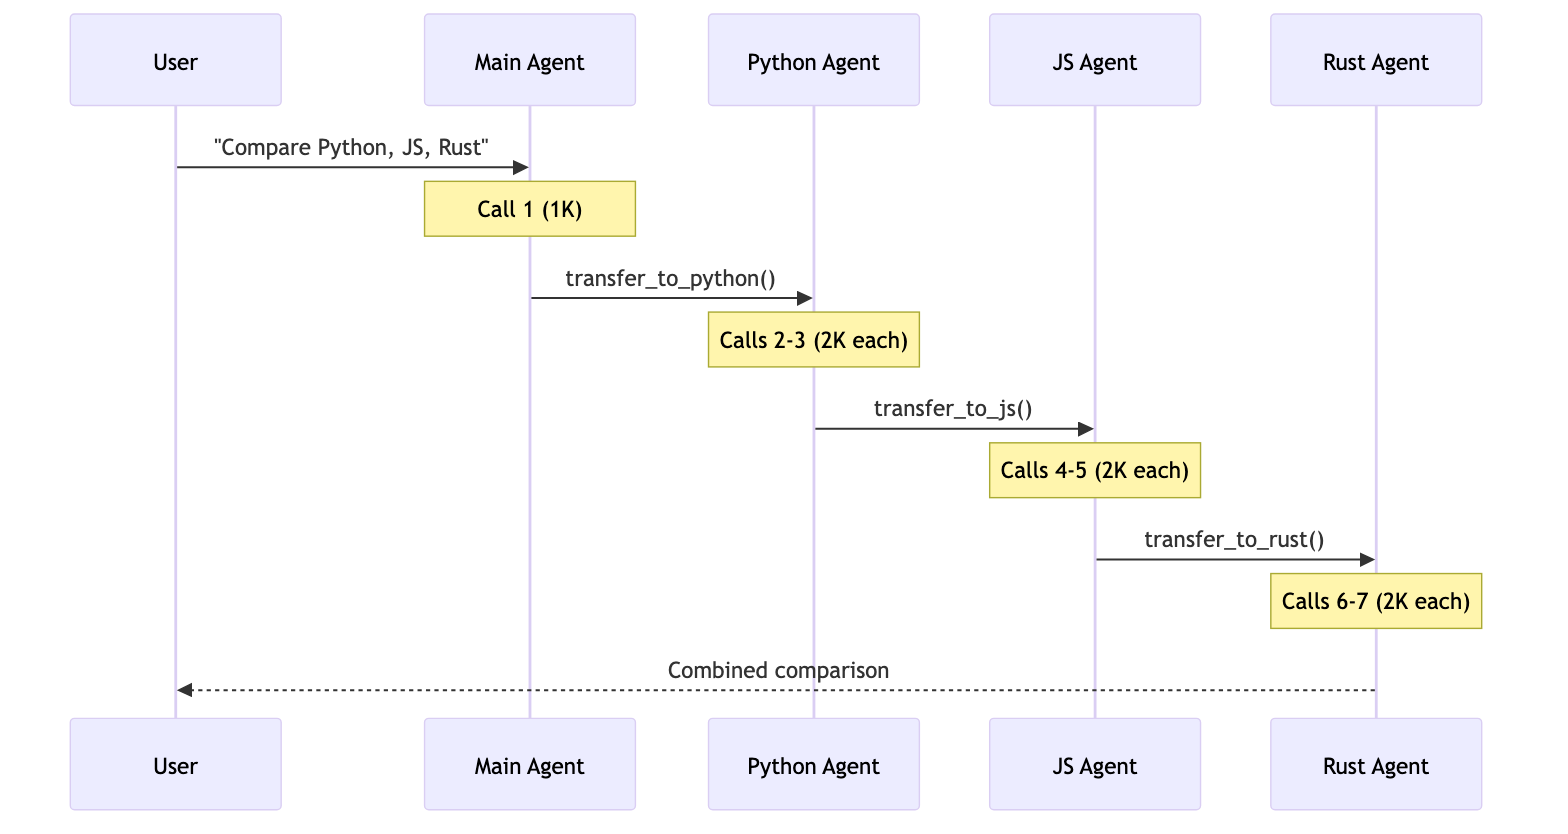
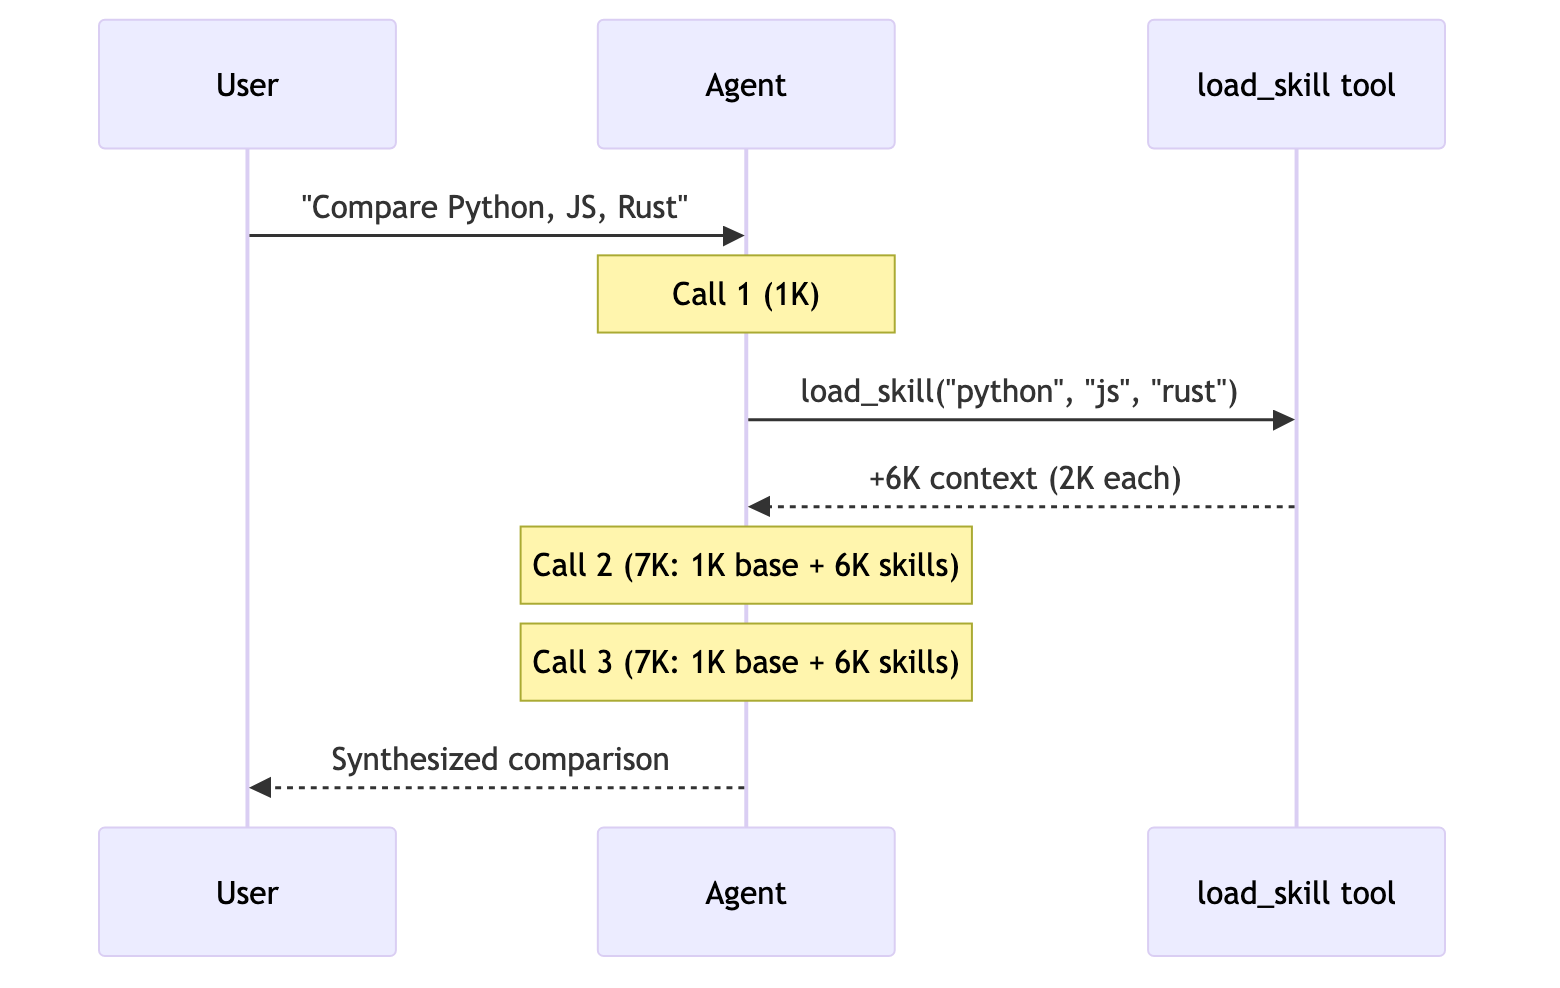
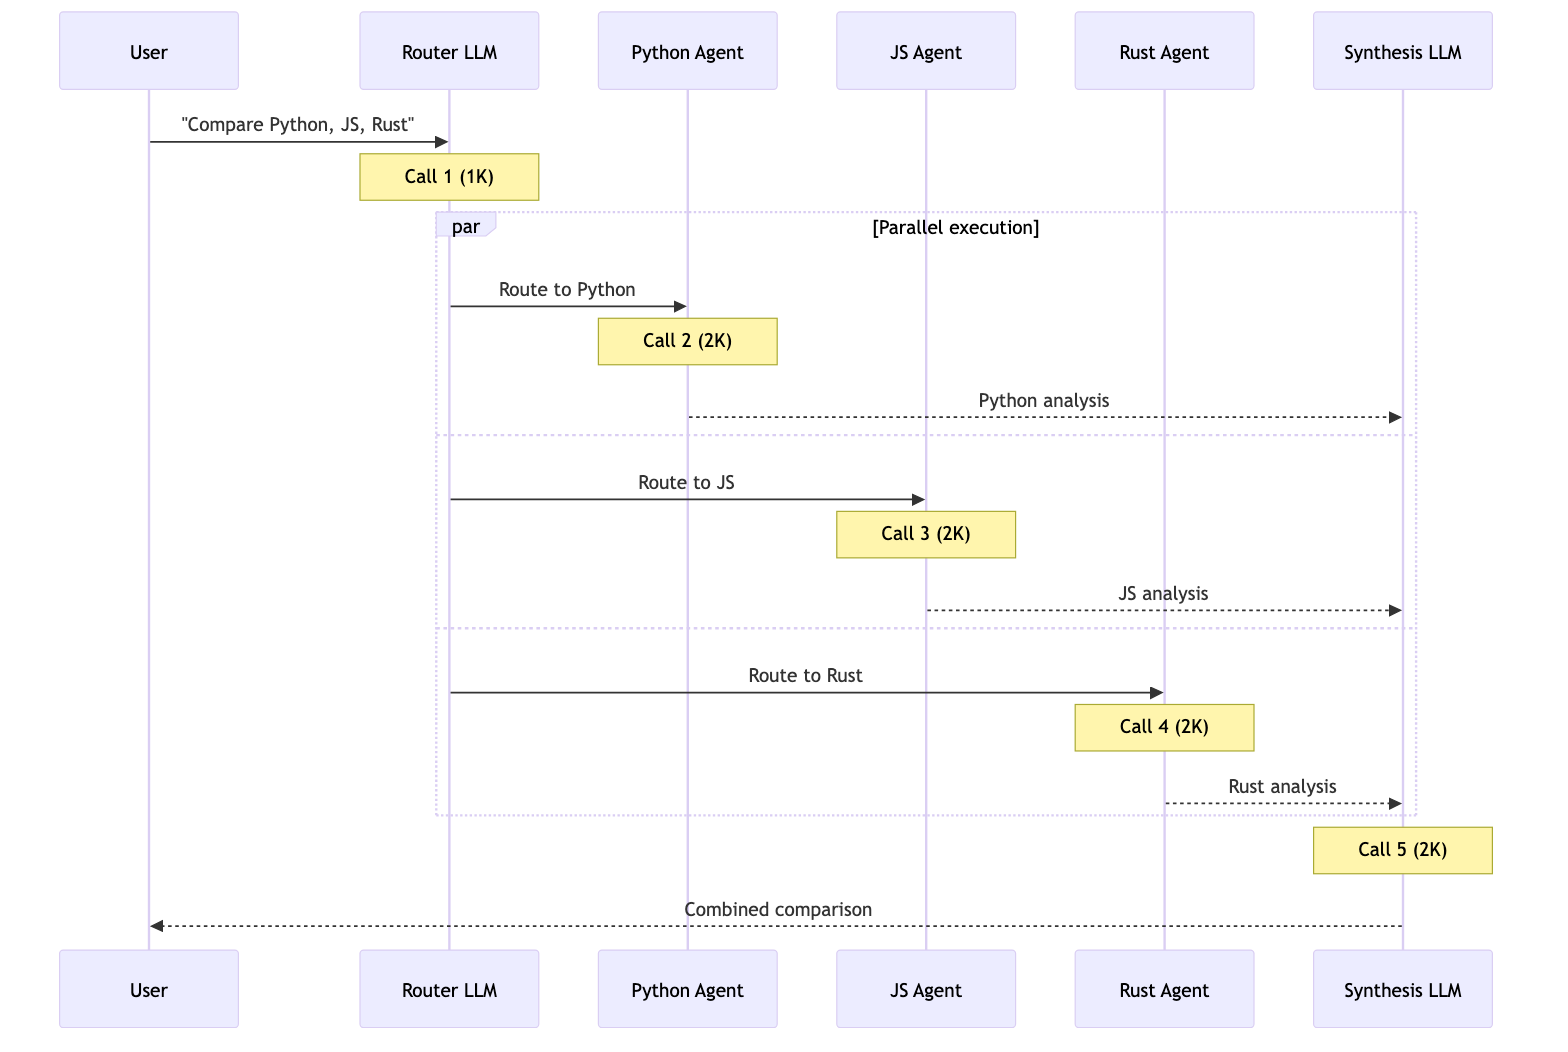
总结
以下是各模式在三个场景中的对比:Connect these docs to Claude, VSCode, and more via MCP for real-time answers.