

- 评估类型:评估的_时间和原因_。离线评估类型(基准测试、单元测试、回归测试)用于部署前测试;在线评估类型(监控、异常检测)用于生产环境。
- 评估器实现:评估的_方式_。可用的评估器方法(LLM-as-judge、代码、组合、汇总、成对评估),以及配置位置(UI 或 SDK、离线或在线)。
离线评估类型
离线评估会在部署前,使用经过整理的数据集测试应用。通过对带有参考输出的示例运行评估,团队可以比较不同版本、验证功能,并在向用户公开更改前建立信心。 使用 LangSmith SDK(Python 或 TypeScript)在客户端运行离线评估,或通过 Playground 在服务端运行,也可以将评估器绑定到数据集。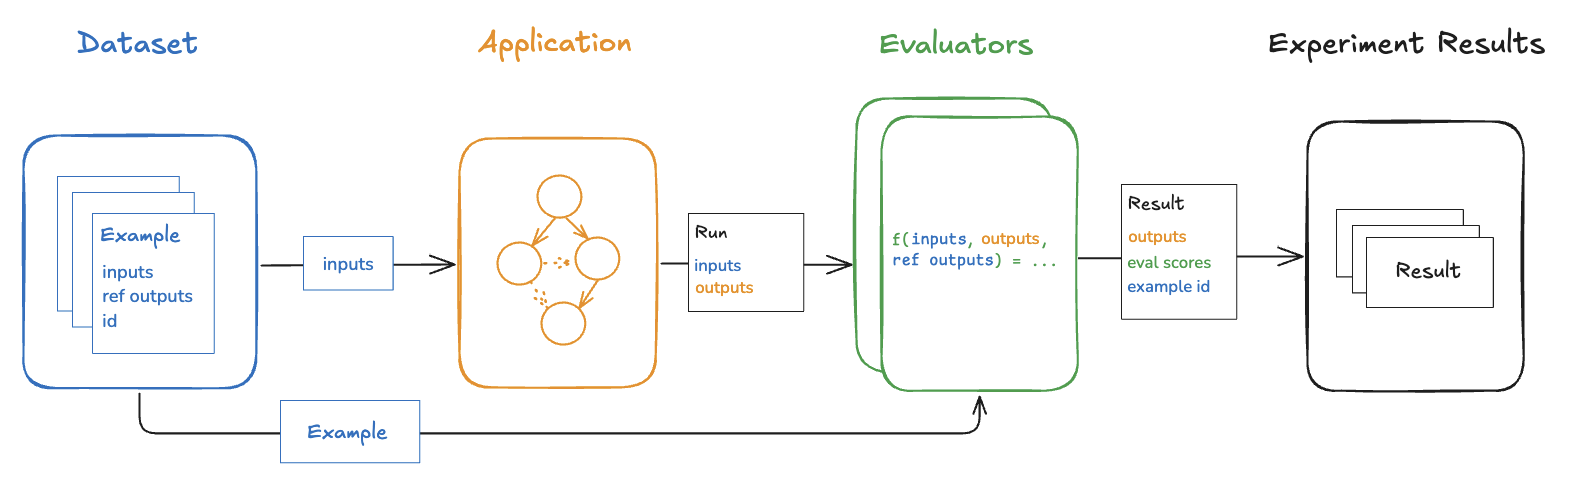
基准测试
_基准测试_会在经过整理的数据集上比较多个应用版本,以确定表现最佳的版本。此过程包括创建包含代表性输入的数据集、定义性能指标,以及测试每个版本。 基准测试要求整理包含金标准参考输出的数据集,并设计良好的比较指标。例如:- RAG 问答机器人:包含问题和参考答案的数据集,并使用 LLM-as-judge 评估器检查实际答案与参考答案之间的语义等价性。
- ReAct 智能体:包含用户请求和参考工具调用的数据集,并使用启发式评估器验证是否执行了所有预期的工具调用。
单元测试
_单元测试_用于验证系统各个组件的正确性。在 LLM 场景中,单元测试通常是针对输入或输出的基于规则的断言(例如,验证 LLM 生成的代码能否编译、JSON 是否能成功加载),以此验证基本功能。 单元测试通常要求结果稳定通过,因此适合用于 CI 流水线。在 CI 中运行时,请配置缓存,以尽量减少 LLM API 调用及相关成本。 如需了解详情,请参阅 Pytest 和 Vitest/Jest 页面。回归测试
_回归测试_用于衡量应用不同版本随时间变化的性能一致性。它们确保新版本不会在当前版本能够正确处理的案例上出现性能下降,并且最好能证明相较基线有所改进。这些测试通常在进行预计会影响用户体验的更新时运行(例如模型或架构变更)。 LangSmith 的比较视图会突出显示相对于基线的回归(红色)和改进(绿色),帮助你快速识别变更。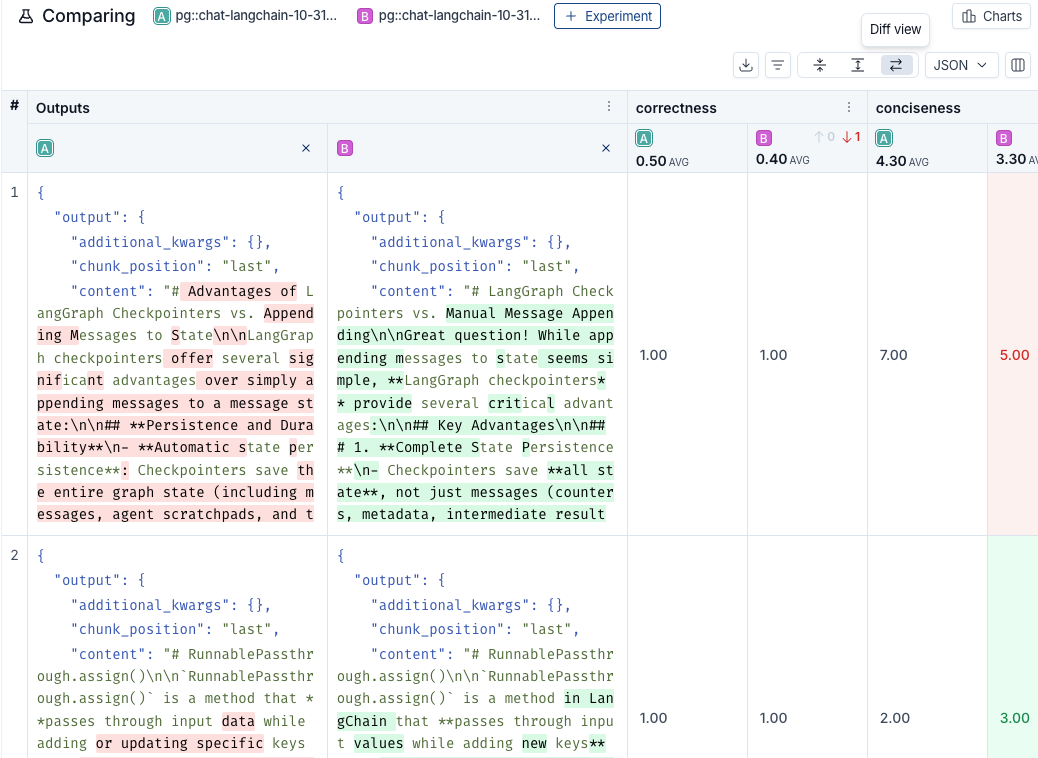
回测
_回测_会使用历史生产数据评估新的应用版本。系统会将生产日志转换为数据集,然后让新版本处理这些示例,以评估其在过去真实用户输入上的表现。 这种方法常用于评估新的模型版本。例如,当新模型可用时,可以使用最近的生产运行记录对其进行测试,并将结果与实际生产结果进行比较。成对评估
_成对评估_通过确定相对质量来比较两个版本的输出,而不是为其分配绝对分数。对于某些任务来说,确定“版本 A 优于版本 B”比单独为每个版本评分更容易。 这种方法特别适用于针对主观任务的 LLM-as-judge 评估。例如,在摘要任务中,确定“哪个摘要更清晰、更简洁?”通常比为清晰度分配数值分数更简单。 了解如何运行成对评估。在线评估类型
在线评估会近乎实时地评估生产应用的输出。由于没有参考输出,这些评估主要用于发现问题、监控质量趋势,以及识别可为未来离线测试提供参考的边缘案例。 在线评估器通常在服务端运行。LangSmith 提供内置的 LLM-as-judge 评估器供配置,也支持在 LangSmith 中运行的自定义代码评估器。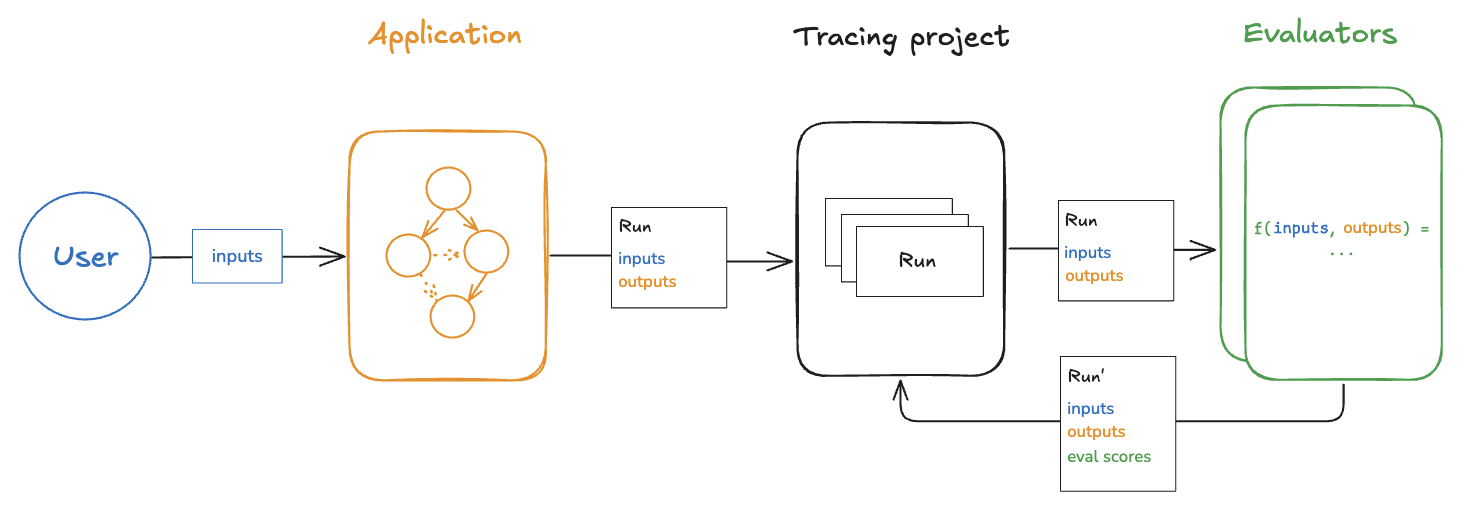
实时监控
在用户与系统交互的过程中持续监控应用质量。在线评估会自动处理生产流量,为每次交互提供即时反馈。这样可以在问题影响大量用户之前,发现质量下降、异常模式或意外行为。异常检测
识别偏离预期模式的异常值和边缘案例。在线评估器可以标记具有异常特征的运行记录——例如响应极长或极短、错误率异常,或输出未通过安全检查的记录——供人工审核,并考虑将其添加到离线数据集中。生产反馈循环
利用生产环境中的洞察改进离线评估。在线评估能够发现经过整理的数据集中可能不会出现的真实问题和使用模式。失败的生产运行记录可以作为数据集示例的候选项,从而形成迭代循环,让生产经验持续完善测试覆盖范围。实现评估器
上述评估类型描述了_何时_进行评估。LangSmith 提供了多种_如何_实现评估器的方法,这些评估器可用于上述不同的评估类型。LLM-as-a-judge
使用 LLM 根据提示中定义的标准为输出评分。这种方法适用于语气、清晰度或语义正确性等难以通过确定性规则捕获的主观质量。 常见使用场景包括:根据参考输出评估事实准确性(离线),或检查生产响应中是否包含有害内容(在线)。例如,对 RAG 系统进行基准测试时,可以使用 LLM-as-judge 评估器检查生成答案与参考答案之间的语义等价性。 配置 LLM-as-judge 评估器:代码评估器
编写确定性的、基于规则的函数来检查特定条件。这些评估器会执行自定义逻辑,用于验证结构、检查模式或应用业务规则。 代码评估器特别适用于单元测试,例如验证生成的代码能否编译、JSON 是否能正确解析,或必需字段是否存在。在回归测试中,它们可以跟踪结构化输出的一致性。在在线监控中,它们可以实时捕获格式违规。 定义代码评估器:组合评估器
使用加权平均值或求和,将多个评估器分数组合为单个指标。这样可以创建同时反映多个评估标准的综合质量分数。 在基准测试中,组合分数有助于从多个维度比较版本(例如,70% 准确性 + 20% 清晰度 + 10% 简洁性)。在在线监控中,它们可以为仪表板和告警提供单一指标。例如,可以将有帮助程度、正确性和语气分数进行加权组合,以跟踪聊天机器人的整体质量。 设置组合评估器:汇总评估器
针对整个实验而非单个示例计算指标。这些评估器会接收数据集中的所有输出,并计算精确率、召回率、F1 分数或分布分析等汇总统计数据。 当你需要数据集级别的指标时,汇总评估器对基准测试至关重要——它们用于比较不同版本的整体性能,而不是逐个比较示例分数。汇总评估器只能用于离线评估,因为它们需要处理完整的数据集。 实现汇总评估器:- 用于离线评估的自定义聚合函数:使用 SDK
成对评估器
比较两个版本的输出,以确定相对质量。这种方法在前面的成对评估部分介绍过,适用于绝对评分较为困难、但判断“哪个更好”相对直接的情况。 运行成对评估:- 比较现有实验:使用 SDK
Connect these docs to Claude, VSCode, and more via MCP for real-time answers.