

概念:成对评估
evaluate() 和两个现有实验来定义评估器并运行成对评估。最后,你将使用 LangSmith UI 查看成对实验。
前提条件
你也可以使用
evaluate_comparative() 来评估两个以上的现有实验。evaluate() 比较参数
最简单的情况下,evaluate / aevaluate 函数接受以下参数:
此外,你还可以传入以下可选参数:
定义成对评估器
成对评估器本质上就是具有指定签名的函数。评估器参数
自定义评估器函数必须使用特定的参数名称。它们可以接受以下任意参数子集:inputs: dict:对应数据集中单个示例输入的字典。outputs: list[dict]:一个包含两个元素的列表,其中是每个实验针对给定输入生成的字典输出。reference_outputs/referenceOutputs: dict:与示例关联的参考输出字典(如果有)。runs: list[Run]:一个包含两个元素的列表,其中是两个实验针对给定示例生成的完整 Run 对象。如果你需要访问每次运行的中间步骤或元数据,请使用此参数。example: Example:完整的数据集 Example,包括示例输入、输出(如果有)和元数据(如果有)。
inputs、outputs 和 reference_outputs / referenceOutputs。只有在需要获取应用实际输入和输出之外的额外追踪信息或示例元数据时,才需要使用 runs 和 example。
评估器输出
自定义评估器应返回以下类型之一: Python 和 JS/TS-
dict:包含以下键的字典:key,表示将要记录的反馈键scores,表示从运行 ID 到该运行得分的映射。comment,表示字符串。最常用于记录模型的推理过程。
list[int | float | bool]:一个包含两个得分的列表。假定该列表的顺序与runs/outputs评估器参数的顺序相同。评估器函数名称将用作反馈键。
pairwise_ 或 ranked_ 前缀。
运行成对评估
以下示例使用了一个提示,该提示要求 LLM 判断两个 AI 助手的响应哪个更好。示例使用结构化输出解析 AI 的响应:0、1 或 2。在下面的 Python 示例中,我们从 LangChain Hub 获取这个结构化提示,并将其与 LangChain 聊天模型封装器结合使用。使用 LangChain 完全是可选的。 为了说明这一点,TypeScript 示例直接使用 OpenAI SDK。
- Python:要求
langsmith>=0.2.0 - TypeScript:要求
langsmith>=0.2.9
查看成对实验
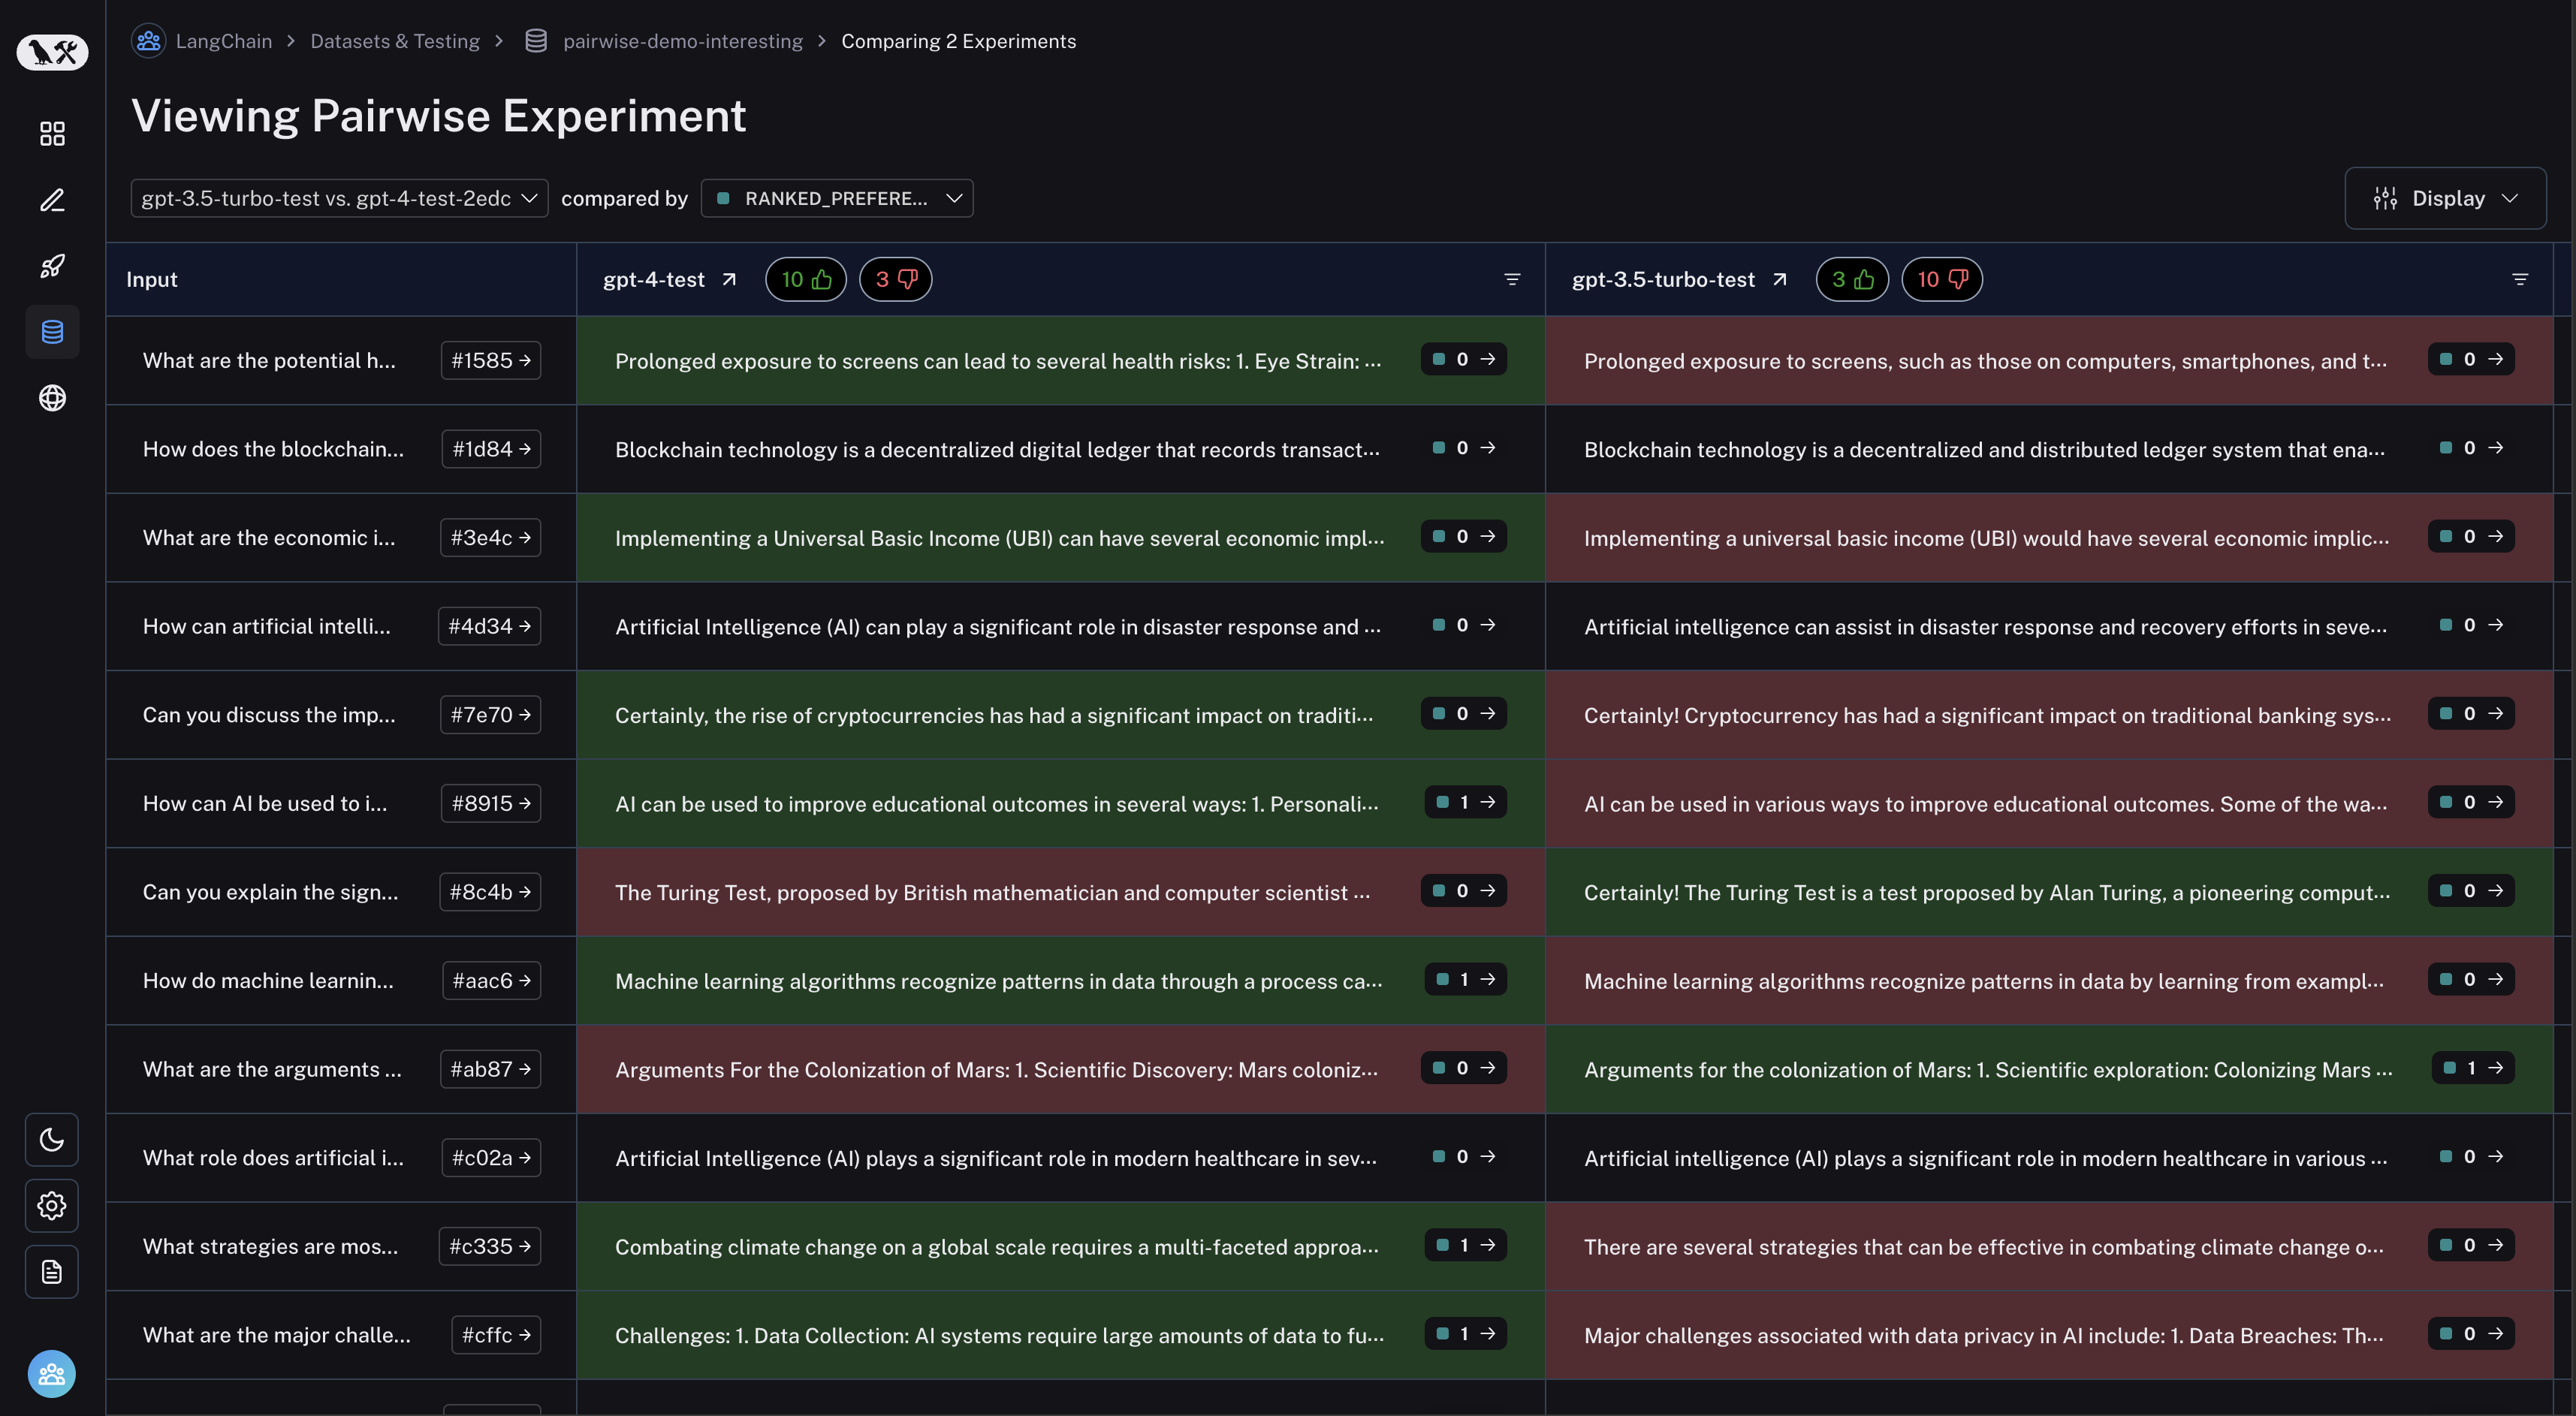
从数据集页面导航到“成对实验”标签页: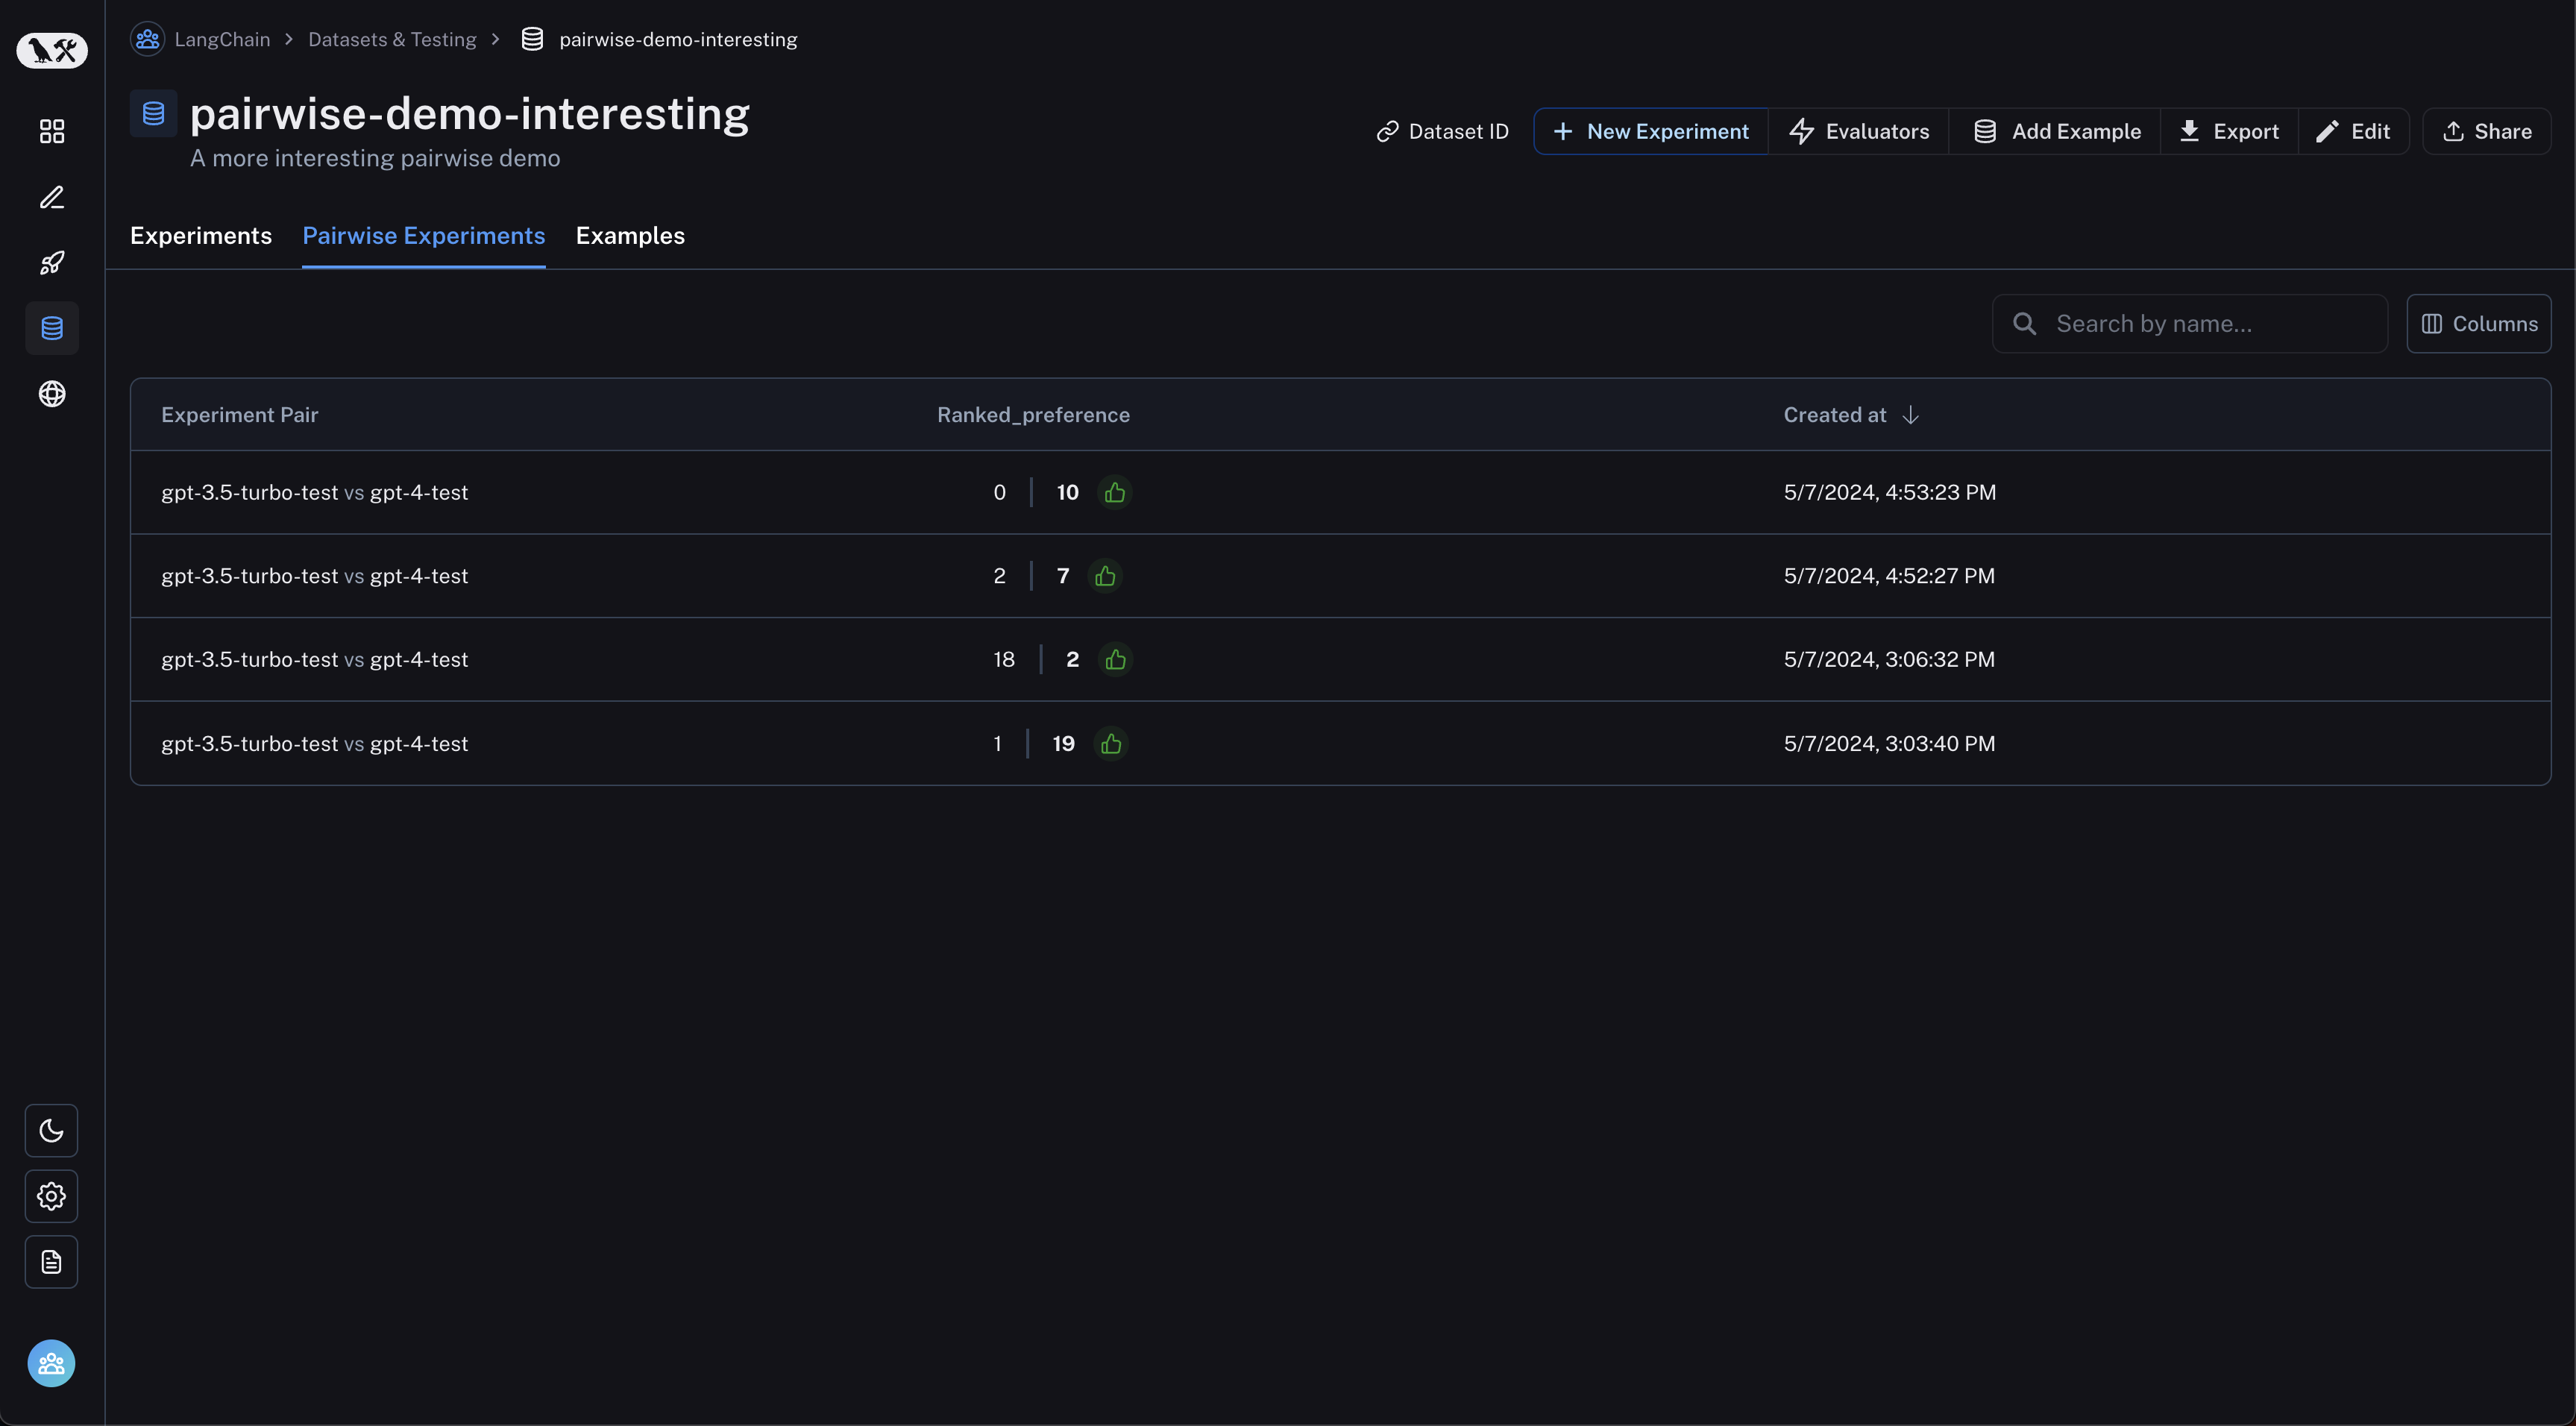 点击你想要检查的成对实验,系统会将你带到比较视图:
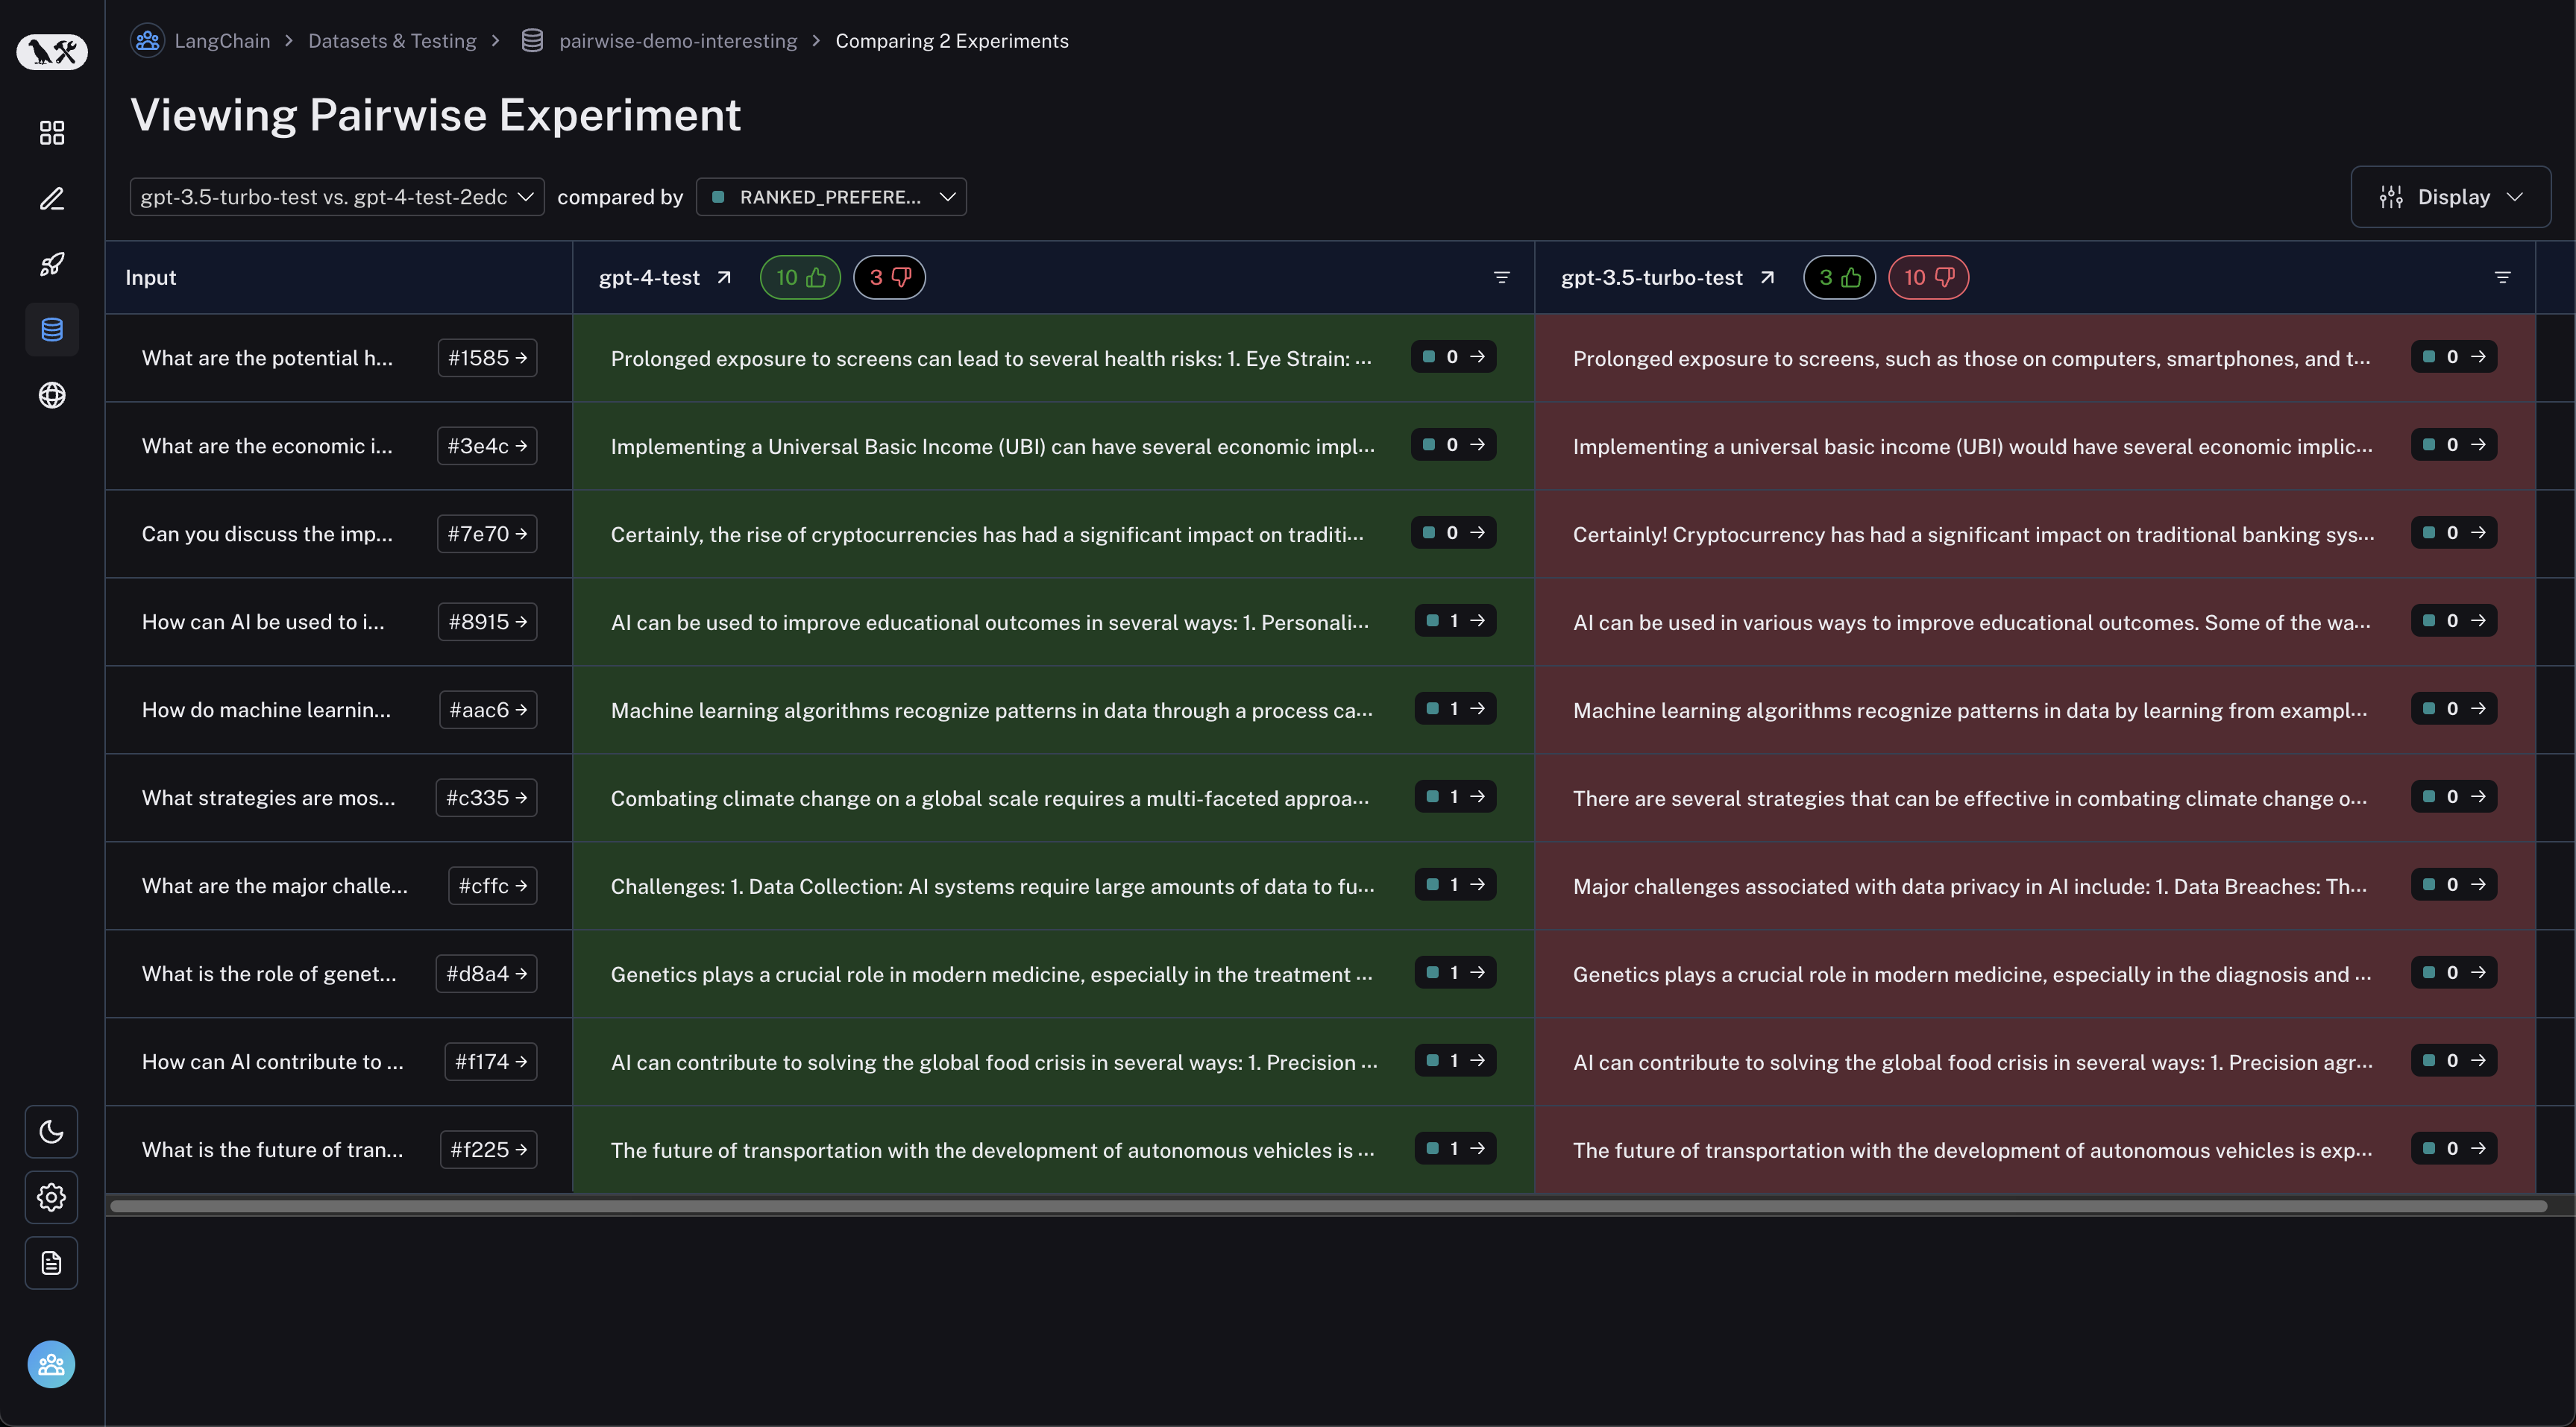
 你可以点击表头中的赞成/反对按钮,筛选出第一个实验表现更好或相反的运行:
Connect these docs to Claude, VSCode, and more via MCP for real-time answers.