

对于较大的 Python 评估任务,我们建议使用 aevaluate(),即 evaluate() 的异步版本。在阅读关于异步运行评估的使用指南之前,仍然建议先阅读本指南,因为两者的接口完全相同。在 JS/TS 中,evaluate() 已经是异步的,因此不需要单独的方法。运行大型任务时,配置
max_concurrency/maxConcurrency 参数也很重要。该参数通过将数据集有效地拆分到多个线程中来实现评估并行化。定义应用程序
首先,我们需要一个要评估的应用程序。在本示例中,我们将创建一个简单的毒性分类器。创建或选择数据集
我们需要一个数据集来评估应用程序。数据集将包含带标签的示例,其中包括有害和无害文本。 要求langsmith>=0.3.13
定义评估器
定义评估器主要有两种方式。在代码中本地定义
你也可以查看 LangChain 的开源评估包 openevals,其中提供了常见的预构建评估器。
- Python:要求
langsmith>=0.3.13 - TypeScript:要求
langsmith>=0.2.9
在 LangSmith UI 中定义
你也可以在 LangSmith UI 中定义评估器。你可以在 Evaluators 标签页下在 UI 中创建评估器。这些评估器会在每个新实验创建时自动触发。运行评估
我们将使用 evaluate() / aevaluate() 方法来运行评估。 主要参数包括:- 一个接收输入字典并返回输出字典的目标函数。每个 Example 的
example.inputs字段会被传递给目标函数。在本例中,toxicity_classifier已经设置为接收示例输入,因此可以直接使用。 data- 要评估的 LangSmith 数据集名称或 UUID,也可以是示例迭代器。evaluators- 用于评估函数输出的一组评估器;LangSmith UI 中的数据集评估器也会自动触发。metadata- 要附加到实验的可选对象。传入models、prompts和tools键,可以填充实验表格视图中对应的列。
langsmith>=0.3.13
向实验添加元数据
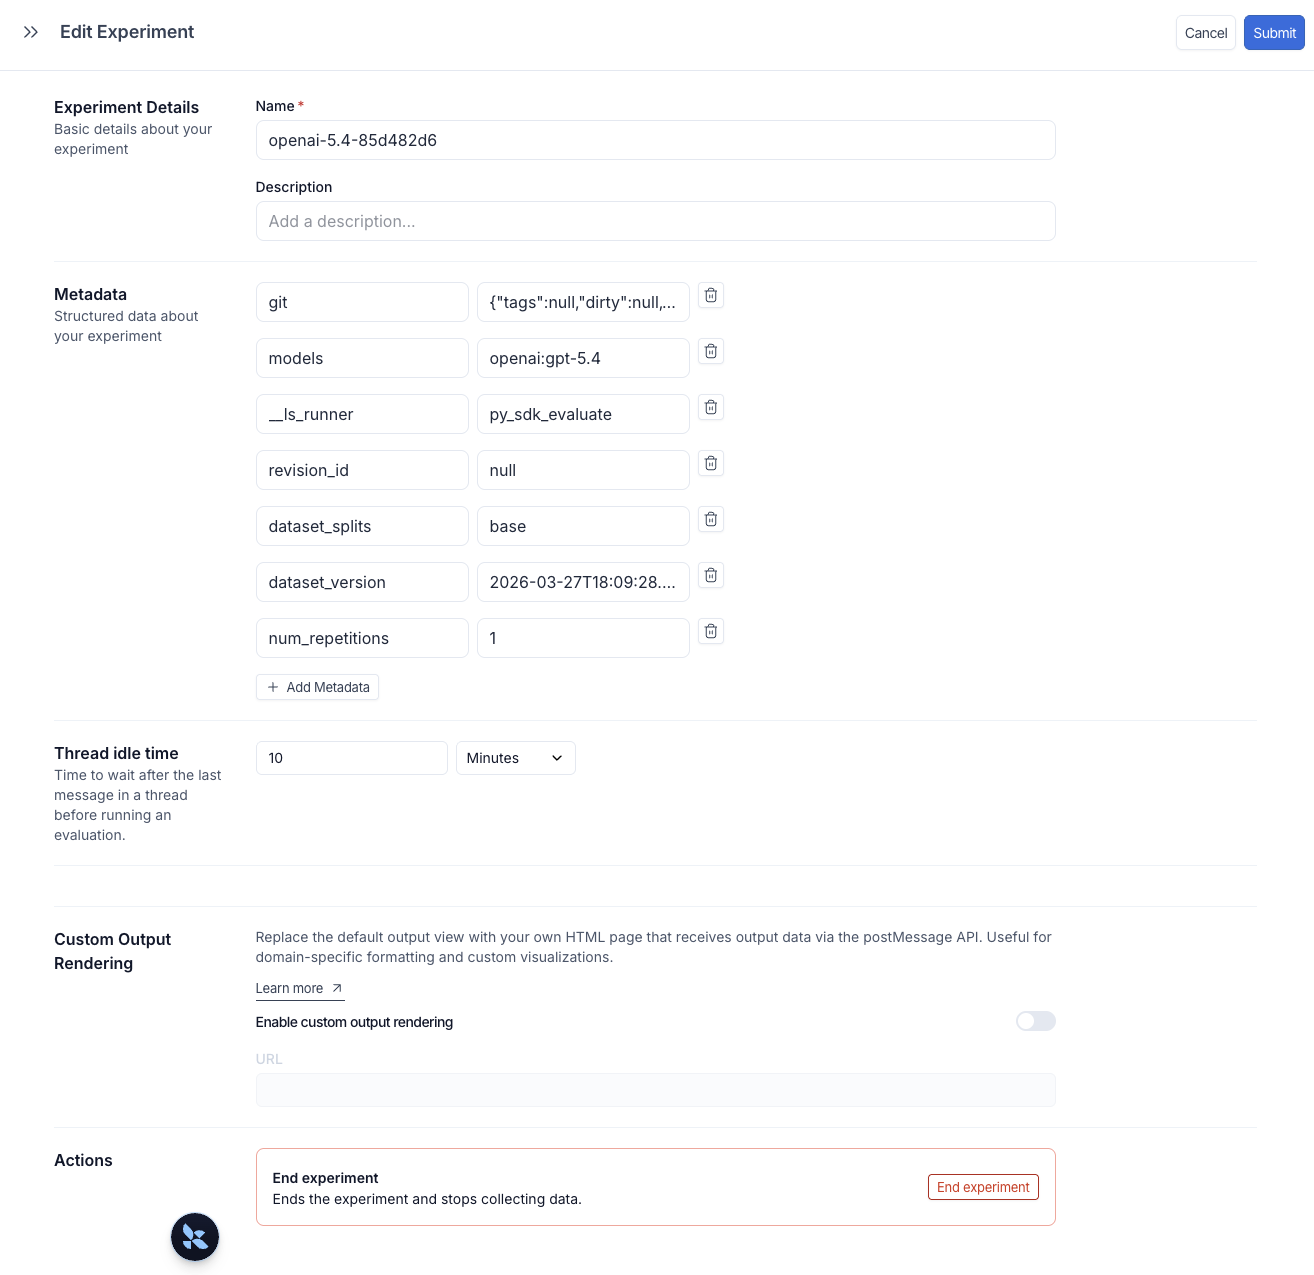
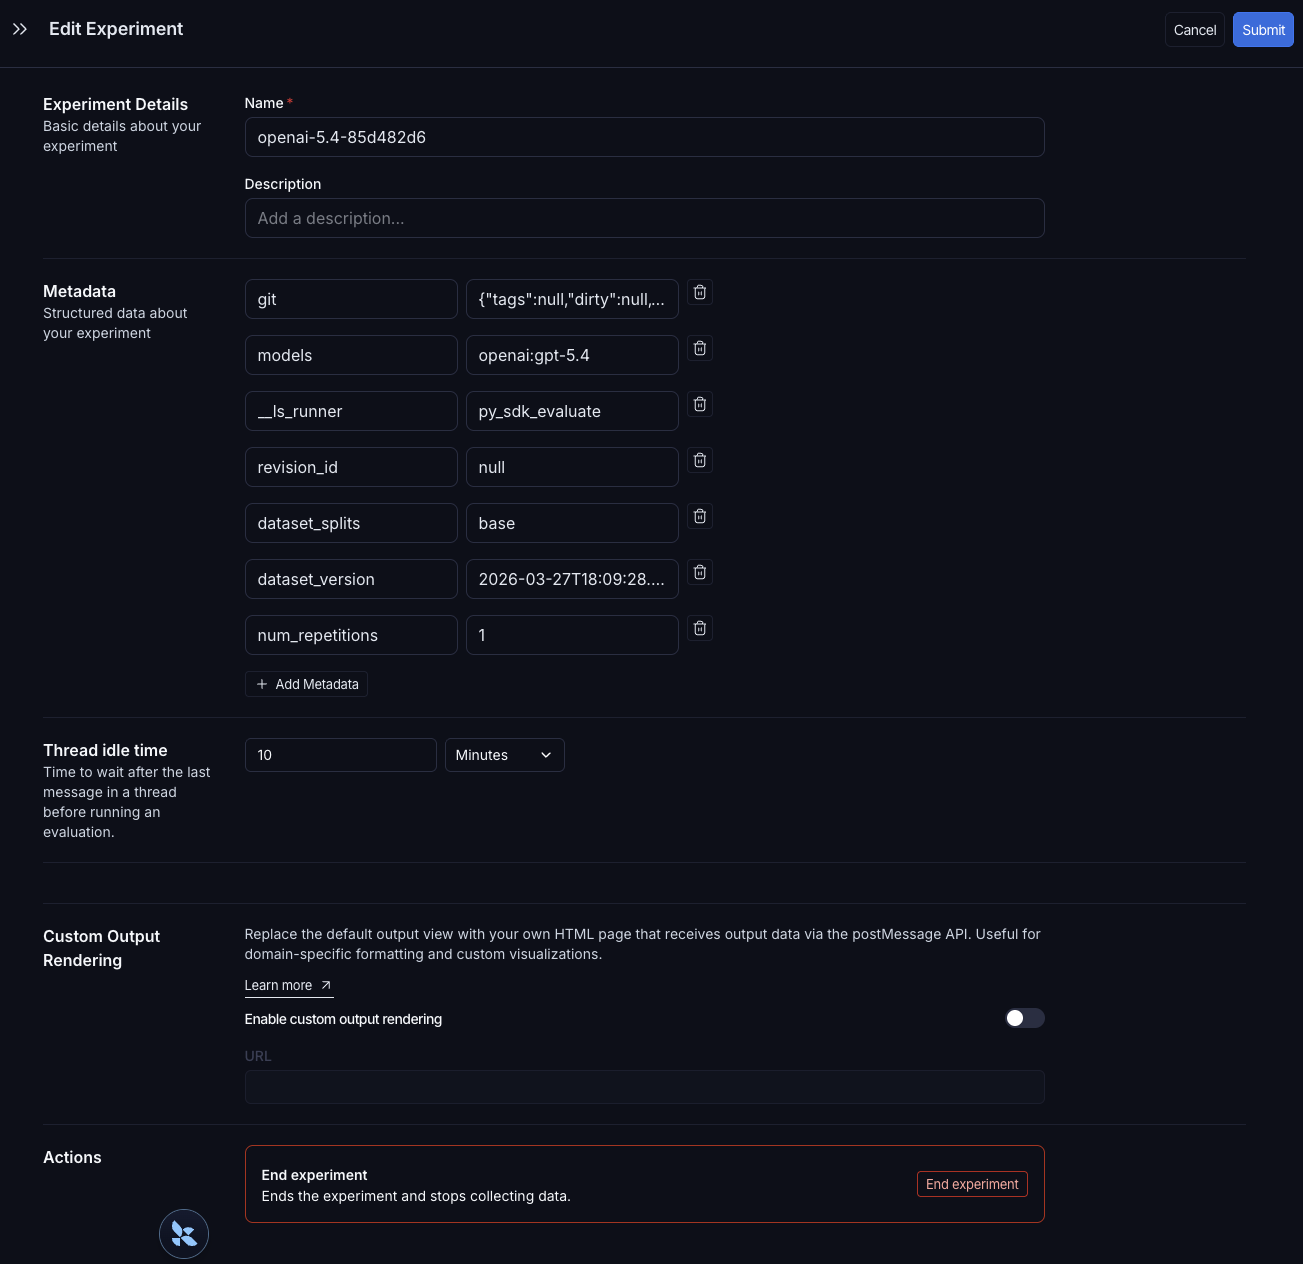
元数据是一组可以附加到实验的键值对,用于在实验表格中对实验进行分组和筛选。你可以在运行实验时通过metadata 参数传入元数据(请参阅运行评估),也可以之后直接在 LangSmith UI 中添加。
要打开 Edit Experiment 面板,请将鼠标悬停在实验表格中的某一行上,然后点击该行右侧出现的 Edit 铅笔图标。
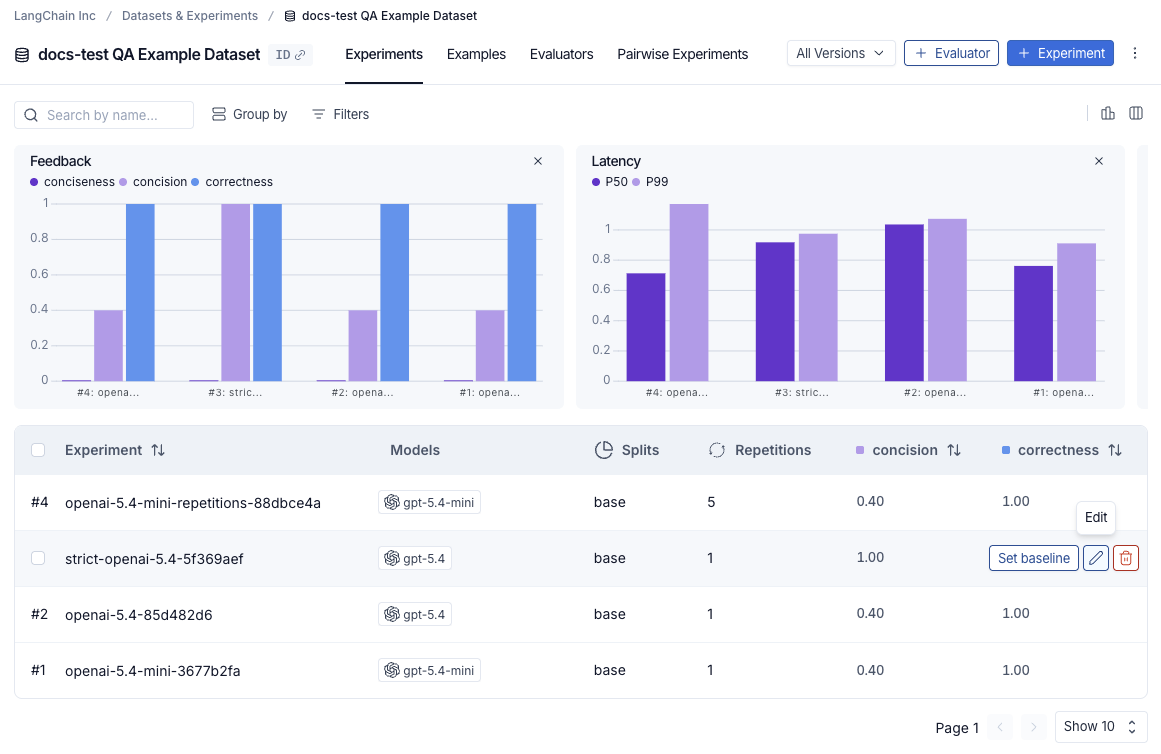
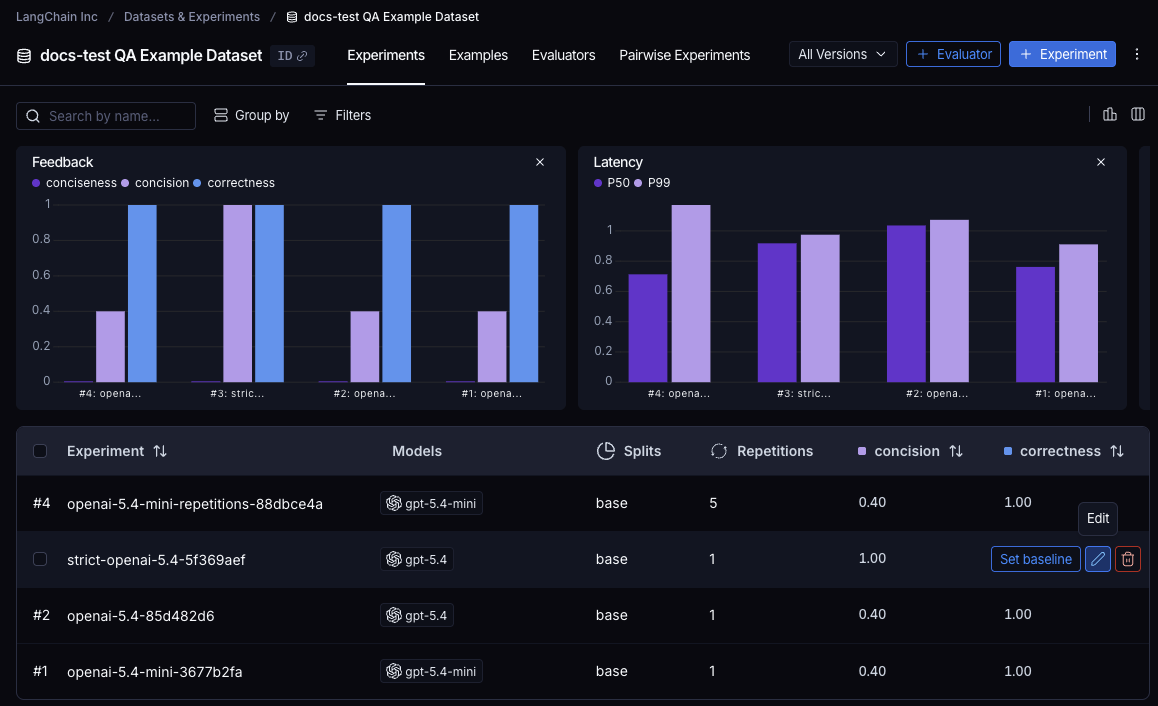 Edit Experiment 面板允许你更新实验名称和描述,并管理元数据键值对。点击 + Add Metadata 添加新的键值对,然后点击右上角的 Submit 保存更改。
 为实验添加元数据标签后,可以使用实验表格顶部的 Group by 控件,按照任意元数据字段对实验进行分组。表格上方的摘要图表会按组更新,显示每种配置的平均反馈分数、延迟和令牌使用量。这样可以方便地比较不同提示词版本、模型或其他更改在同一数据集上的表现。
保留的
models、prompts 和 tools 键会自动填充实验表格中的专用列。点击这些列中的某个值,可以按该值进行筛选或分组。完整详情请参阅按模型、提示词和工具筛选与分组。
查看结果
每次调用evaluate() 都会创建一个实验,你可以在 LangSmith UI 中查看,也可以通过 SDK 查询。更多详细信息请参阅分析实验。
针对数据集运行的实验会列在实验表格中。
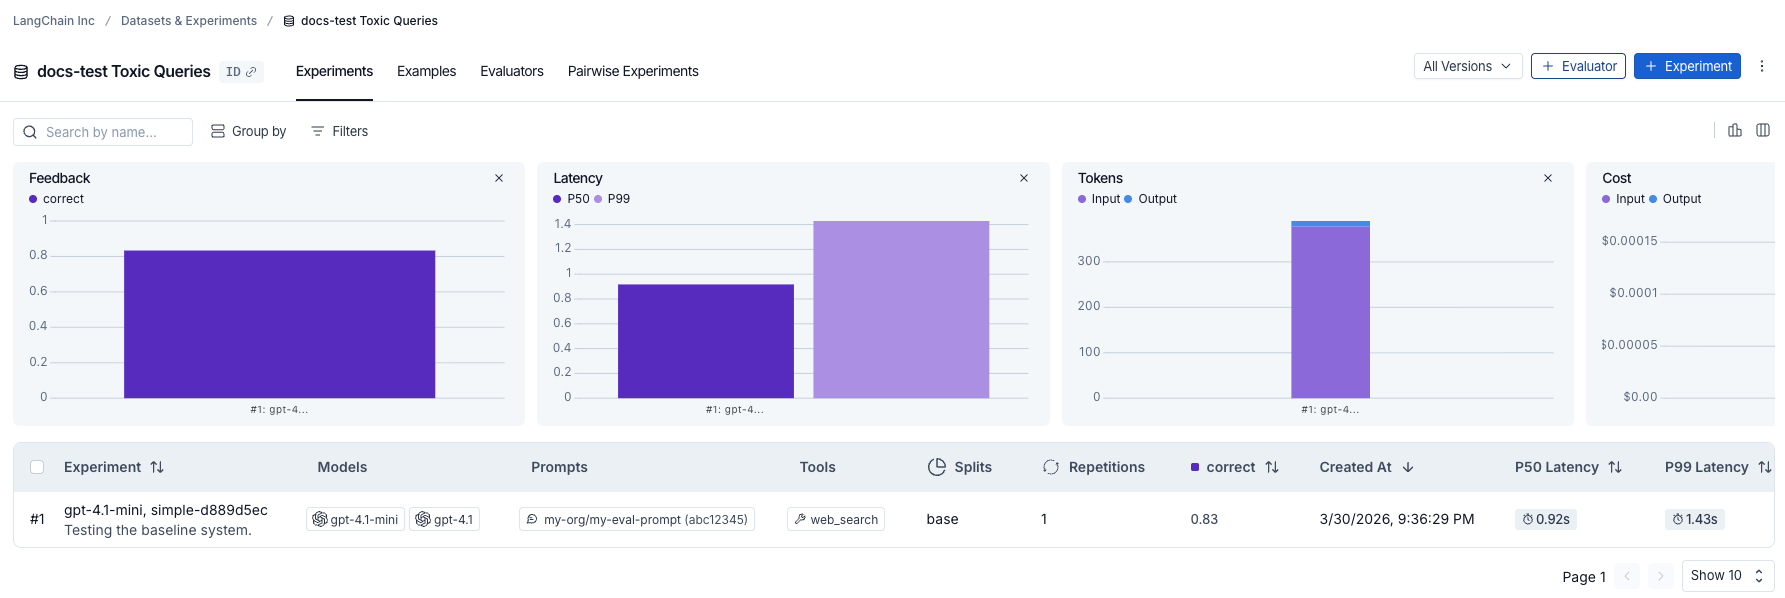
 对于从 Playground 或通过 SDK 运行的实验,Progress 列会实时跟踪完成情况。进度同时反映运行状态和评估状态。将鼠标悬停在进度条上,可以查看已完成的运行数量和已评估的运行数量。
通过 SDK 运行的实验需要以下版本才能支持进度跟踪:
- Python:
langsmith>=0.8.16 - TypeScript:
langsmith>=0.7.8
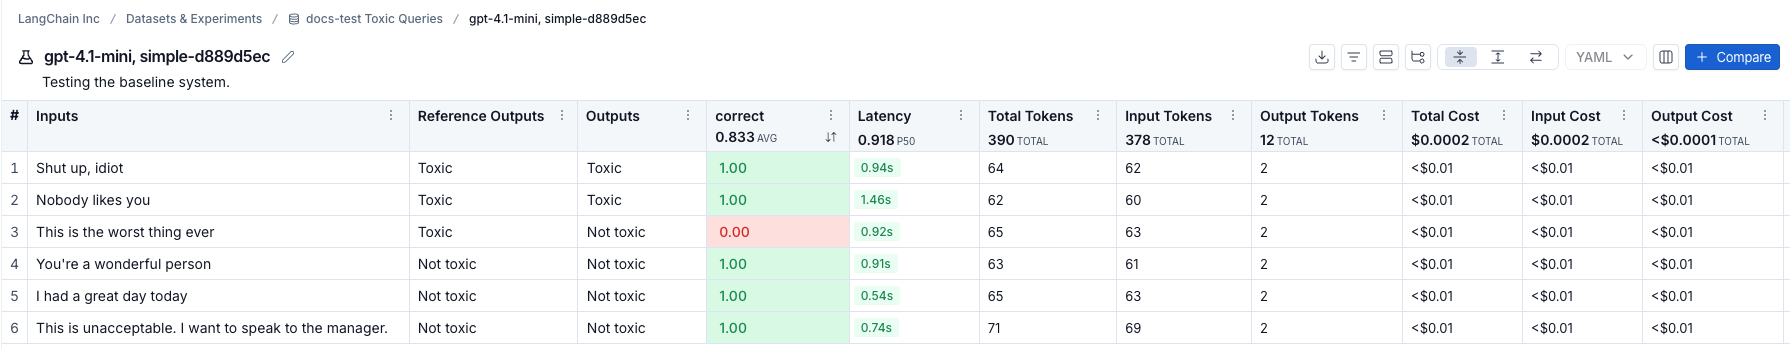
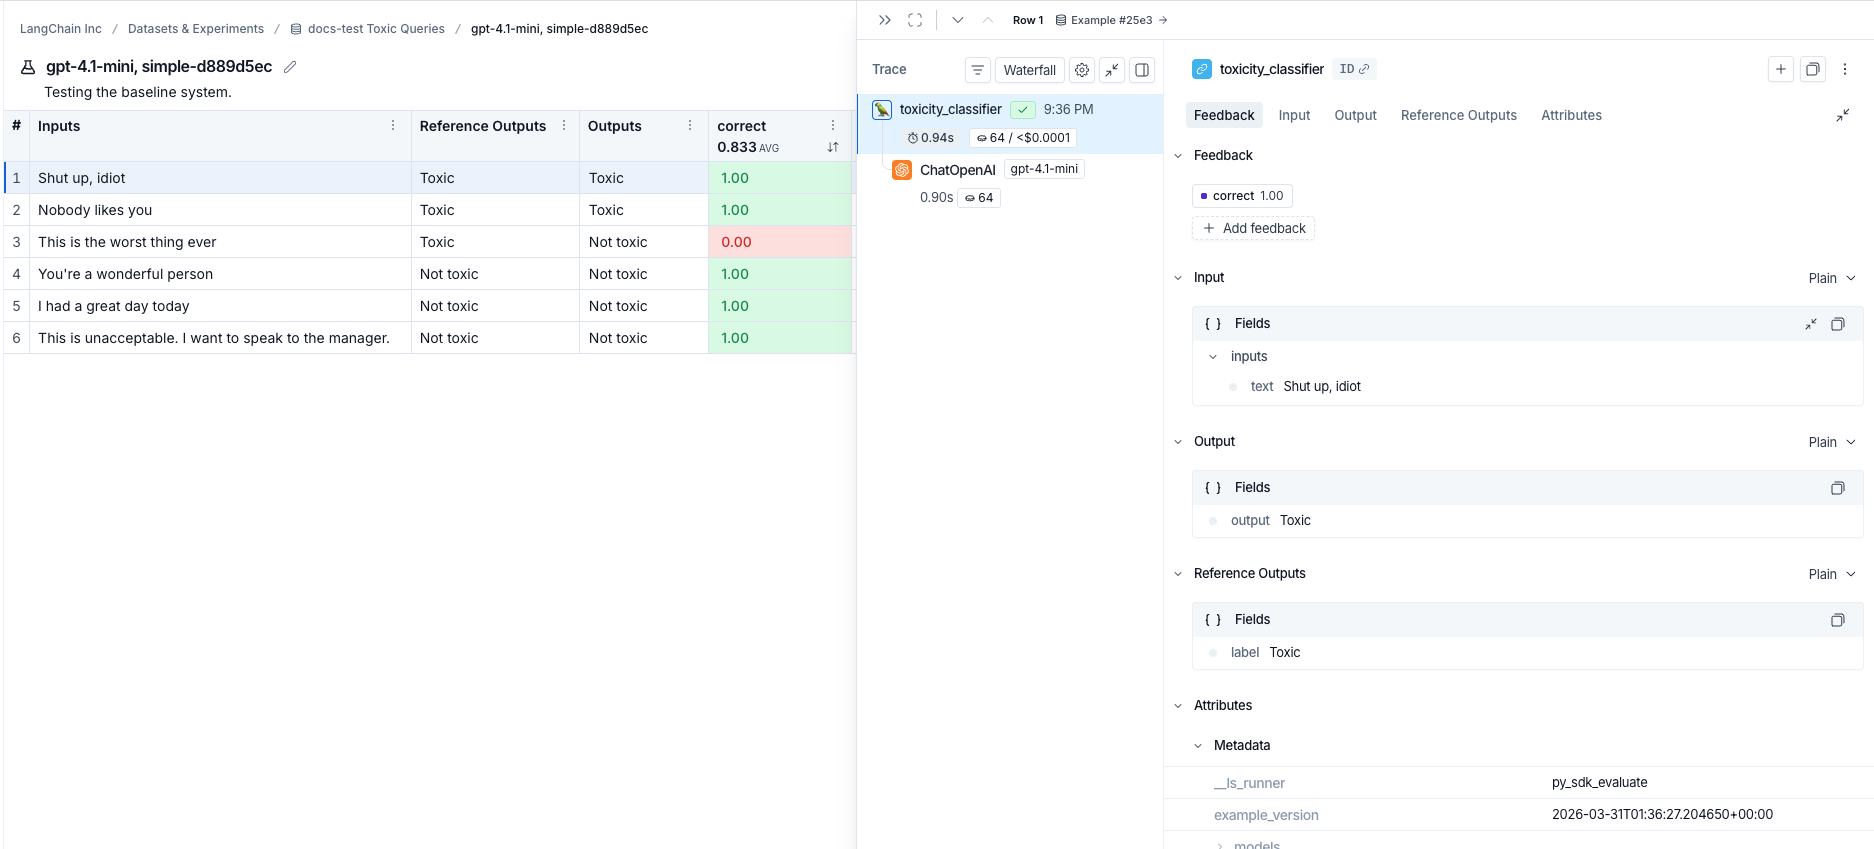
 点击某个示例,可以打开其详细信息面板,其中包括输入、输出、参考输出以及相关跟踪记录(如果你已为代码添加跟踪注释)。
参考代码
Click to see a consolidated code snippet
Click to see a consolidated code snippet
相关内容
Connect these docs to Claude, VSCode, and more via MCP for real-time answers.