

- 从您的生产追踪项目中选择样本运行记录进行测试。
- 将运行输入转换为一个数据集,并将运行输出记录为针对该数据集的初始实验。
- 在新数据集上执行您的新系统,并比较实验的结果。
通常,您不会有明确的“标准答案”可用。在这种情况下,您可以手动标注输出结果,或使用不依赖参考数据的评估器。如果您的应用程序允许获取真实标签(例如,允许用户提供反馈),我们强烈建议您这样做。
设置
配置环境
安装并设置环境变量。本指南要求langsmith>=0.2.4。
为方便起见,本教程将使用 LangChain OSS 框架,但所示的 LangSmith 功能与具体框架无关。
定义应用程序
对于此示例,让我们创建一个简单的推文写作应用程序,该程序可以访问一些互联网搜索工具:模拟生产数据
现在让我们模拟一些生产数据:将生产追踪记录转换为实验
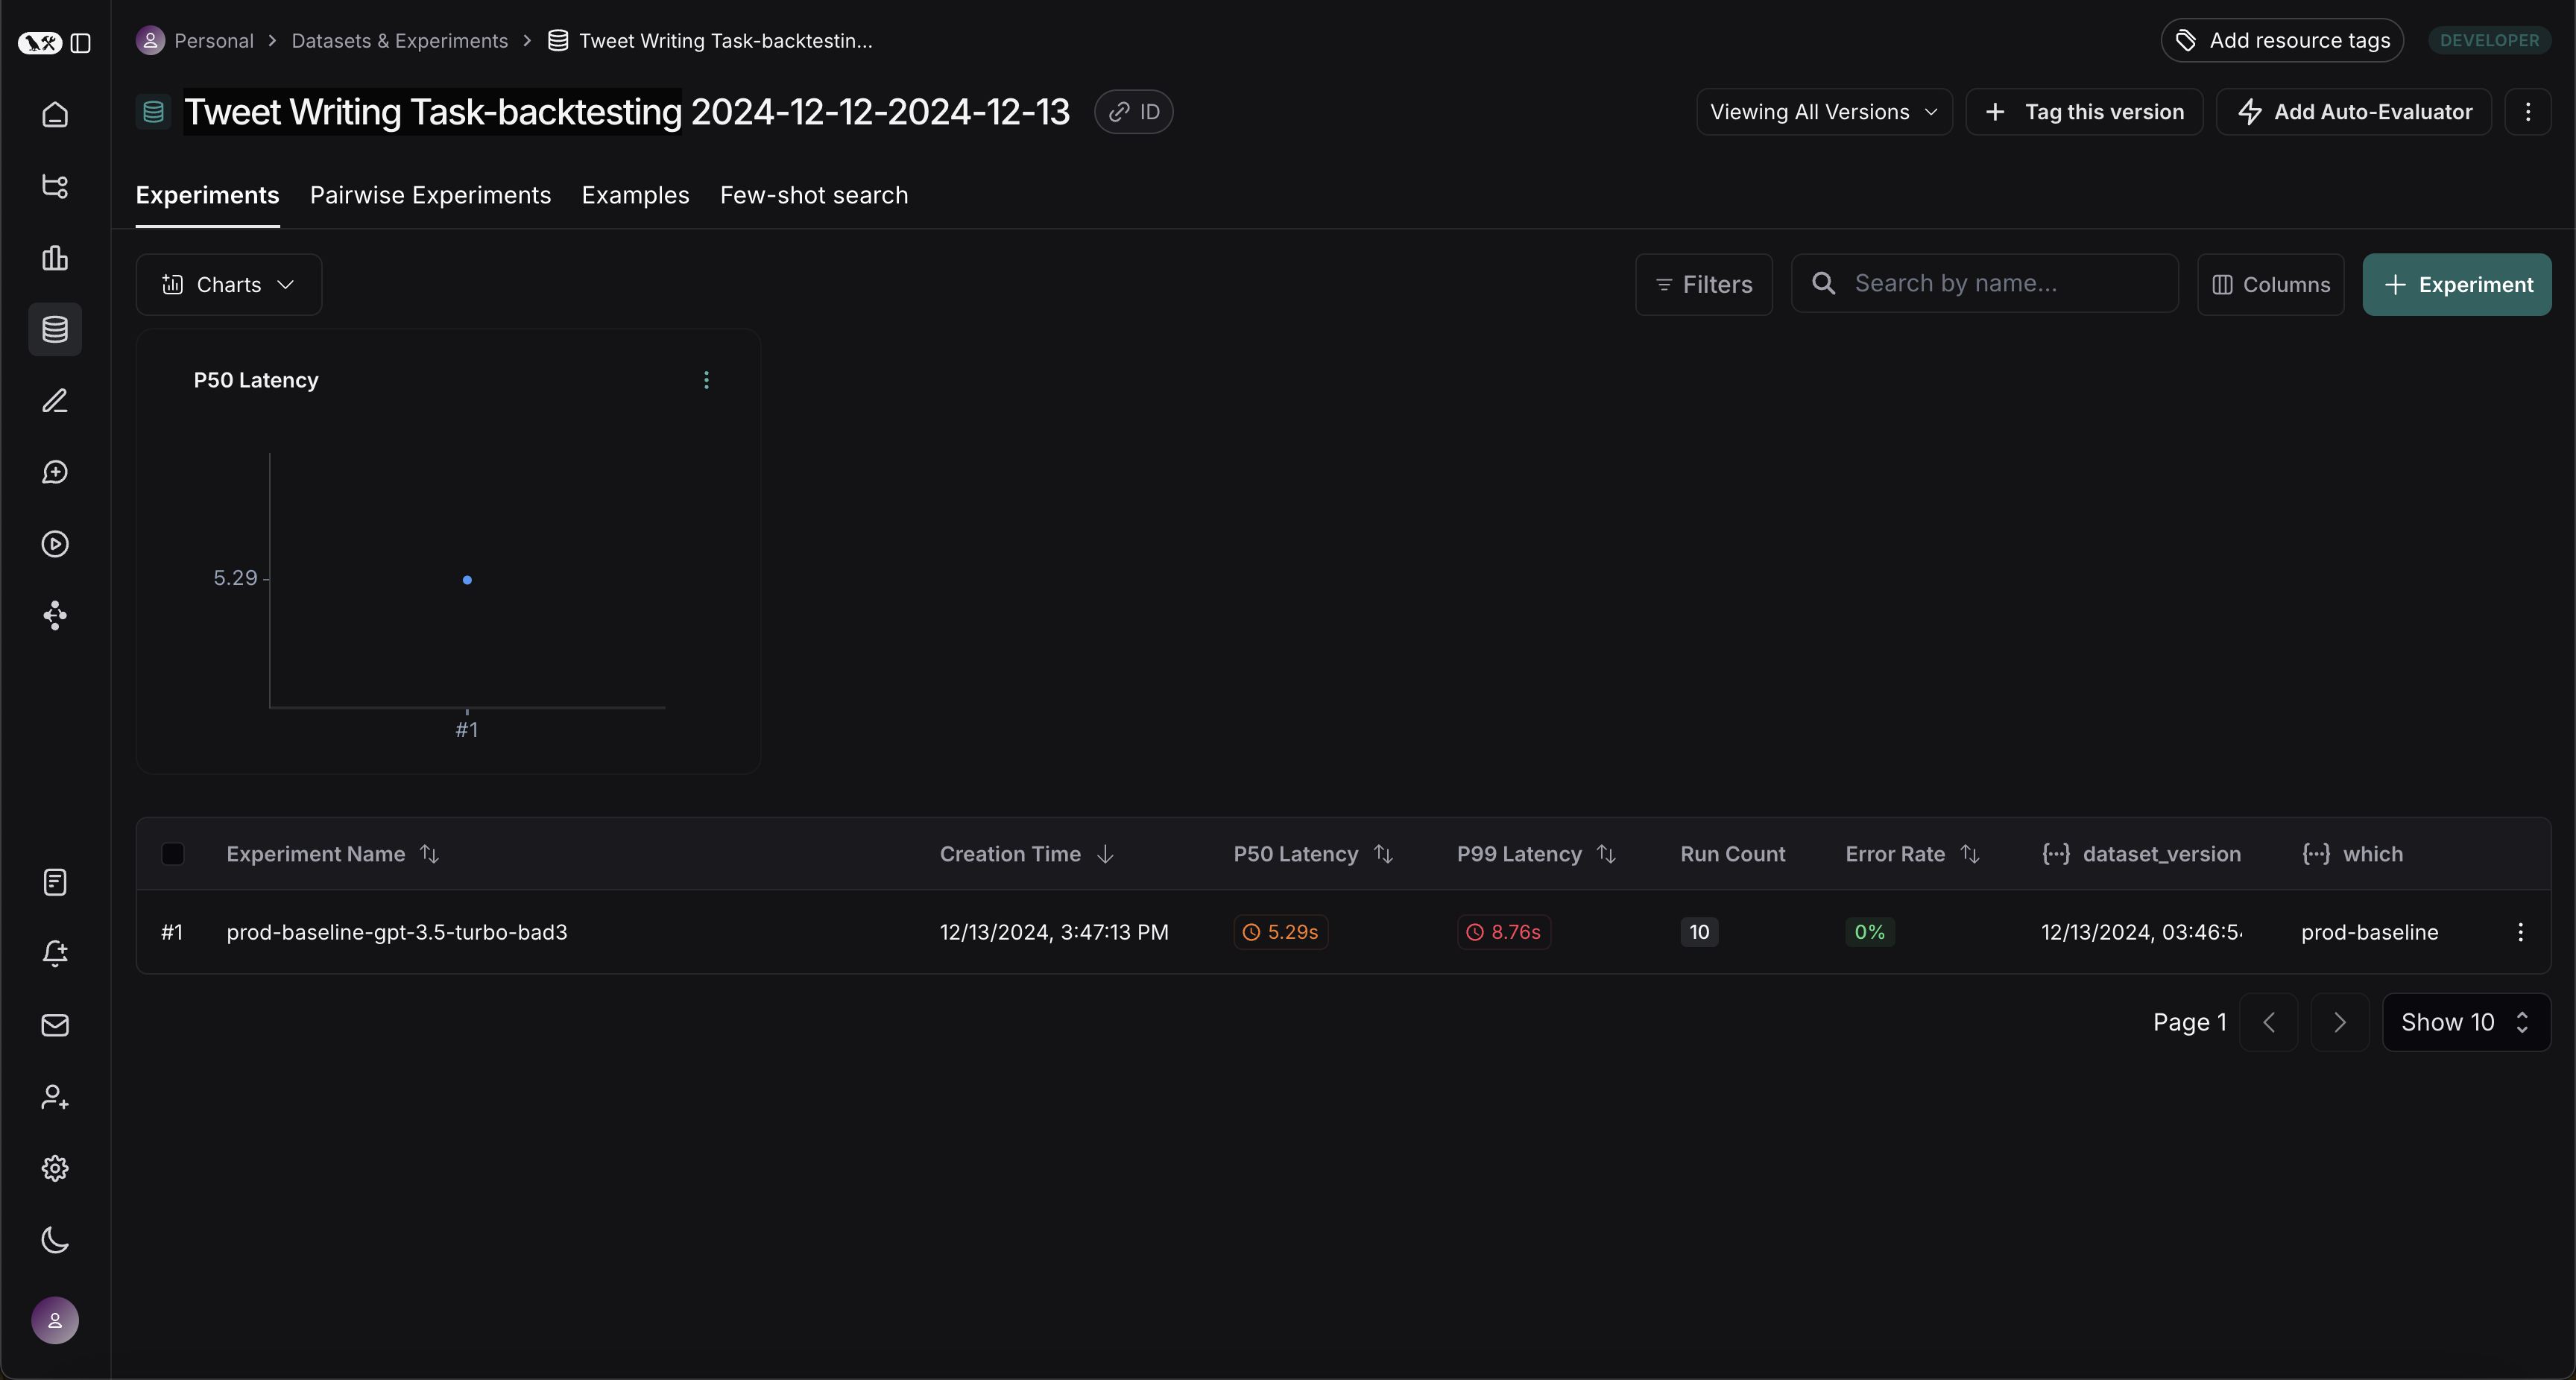
第一步是基于生产输入生成一个数据集。然后复制所有追踪记录作为基线实验。选择要进行回溯测试的运行记录
您可以使用list_runs 的 filter 参数来选择要进行回溯测试的运行记录。filter 参数使用 LangSmith 追踪查询语法 来选择运行记录。
将运行记录转换为实验
convert_runs_to_test 是一个函数,它接受一些运行记录并执行以下操作:
- 输入,以及可选的输出,作为示例保存到一个数据集中。
- 输入和输出作为一个实验存储起来,就像您运行了
evaluate函数并获得了这些输出一样。
与新系统进行基准测试
现在我们可以开始将我们的生产运行记录与一个新系统进行基准测试的过程。定义评估器
首先,让我们定义用于比较两个系统的评估器。请注意,我们没有参考输出,因此我们需要制定仅需要实际输出的评估指标。评估基线
现在,让我们针对基线实验运行我们的评估器。定义并评估新系统
现在,让我们定义并评估我们的新系统。在这个例子中,我们的新系统将与旧系统相同,但使用 GPT-4o 而不是 GPT-3.5。由于我们已将模型设置为可配置,我们可以只更新传递给智能体的默认配置:比较结果
运行两个实验后,您可以在数据集中查看它们: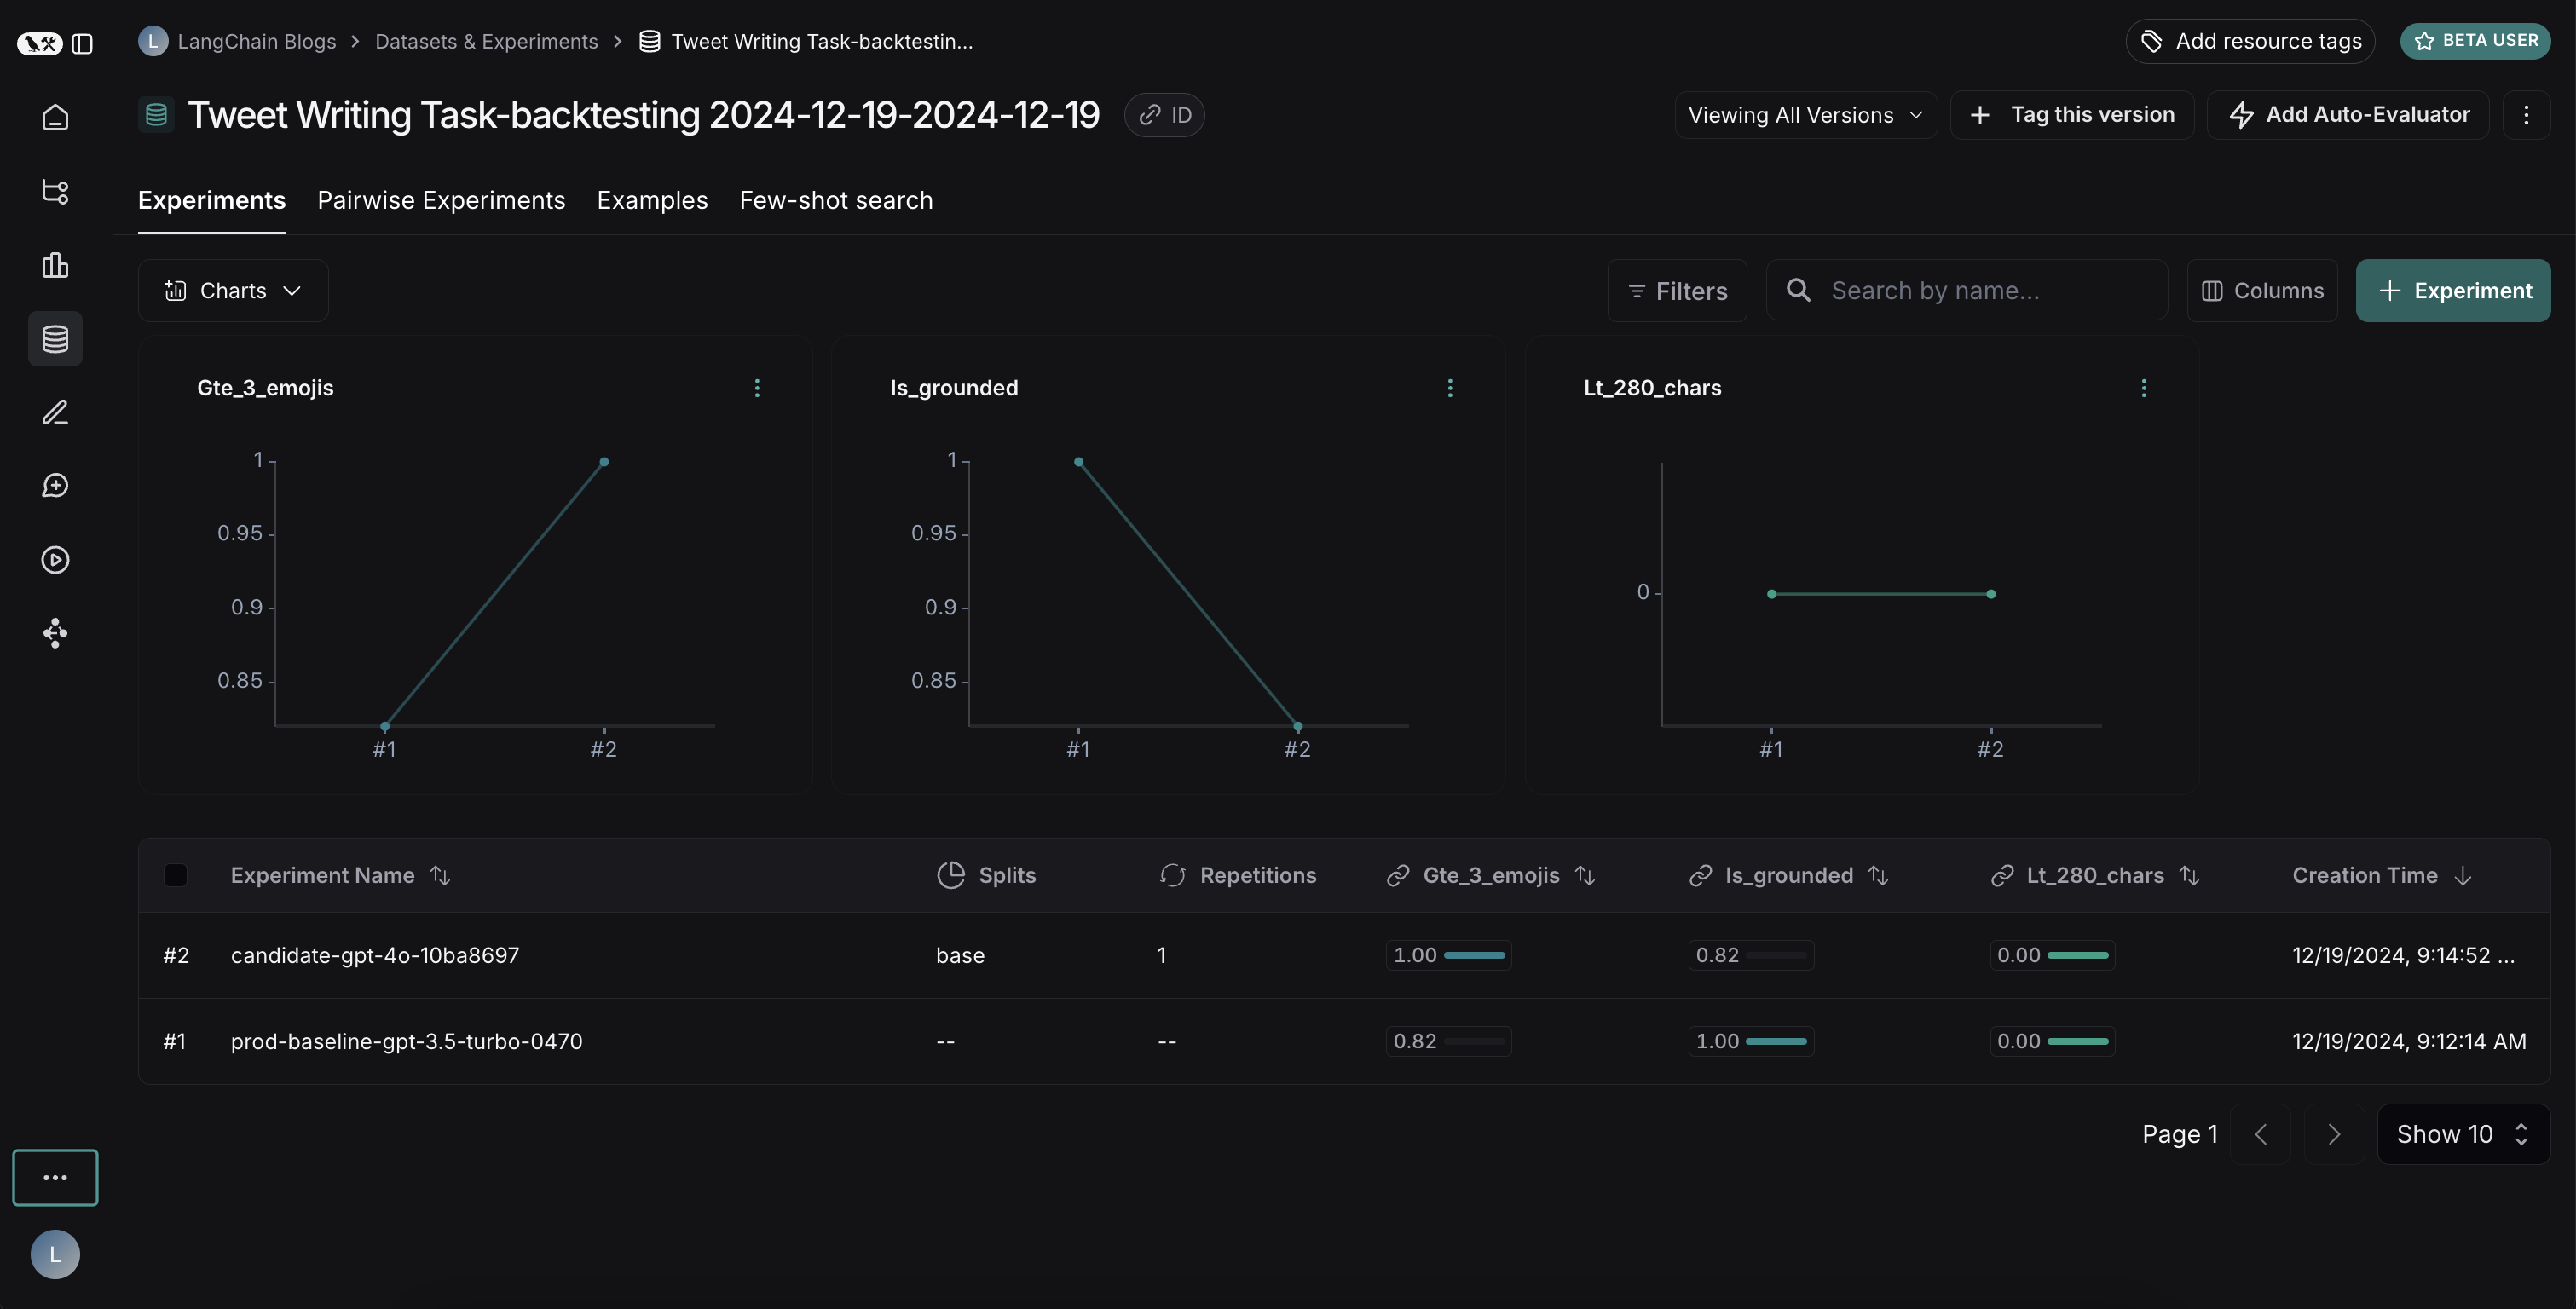 结果揭示了两个模型之间一个有趣的权衡:
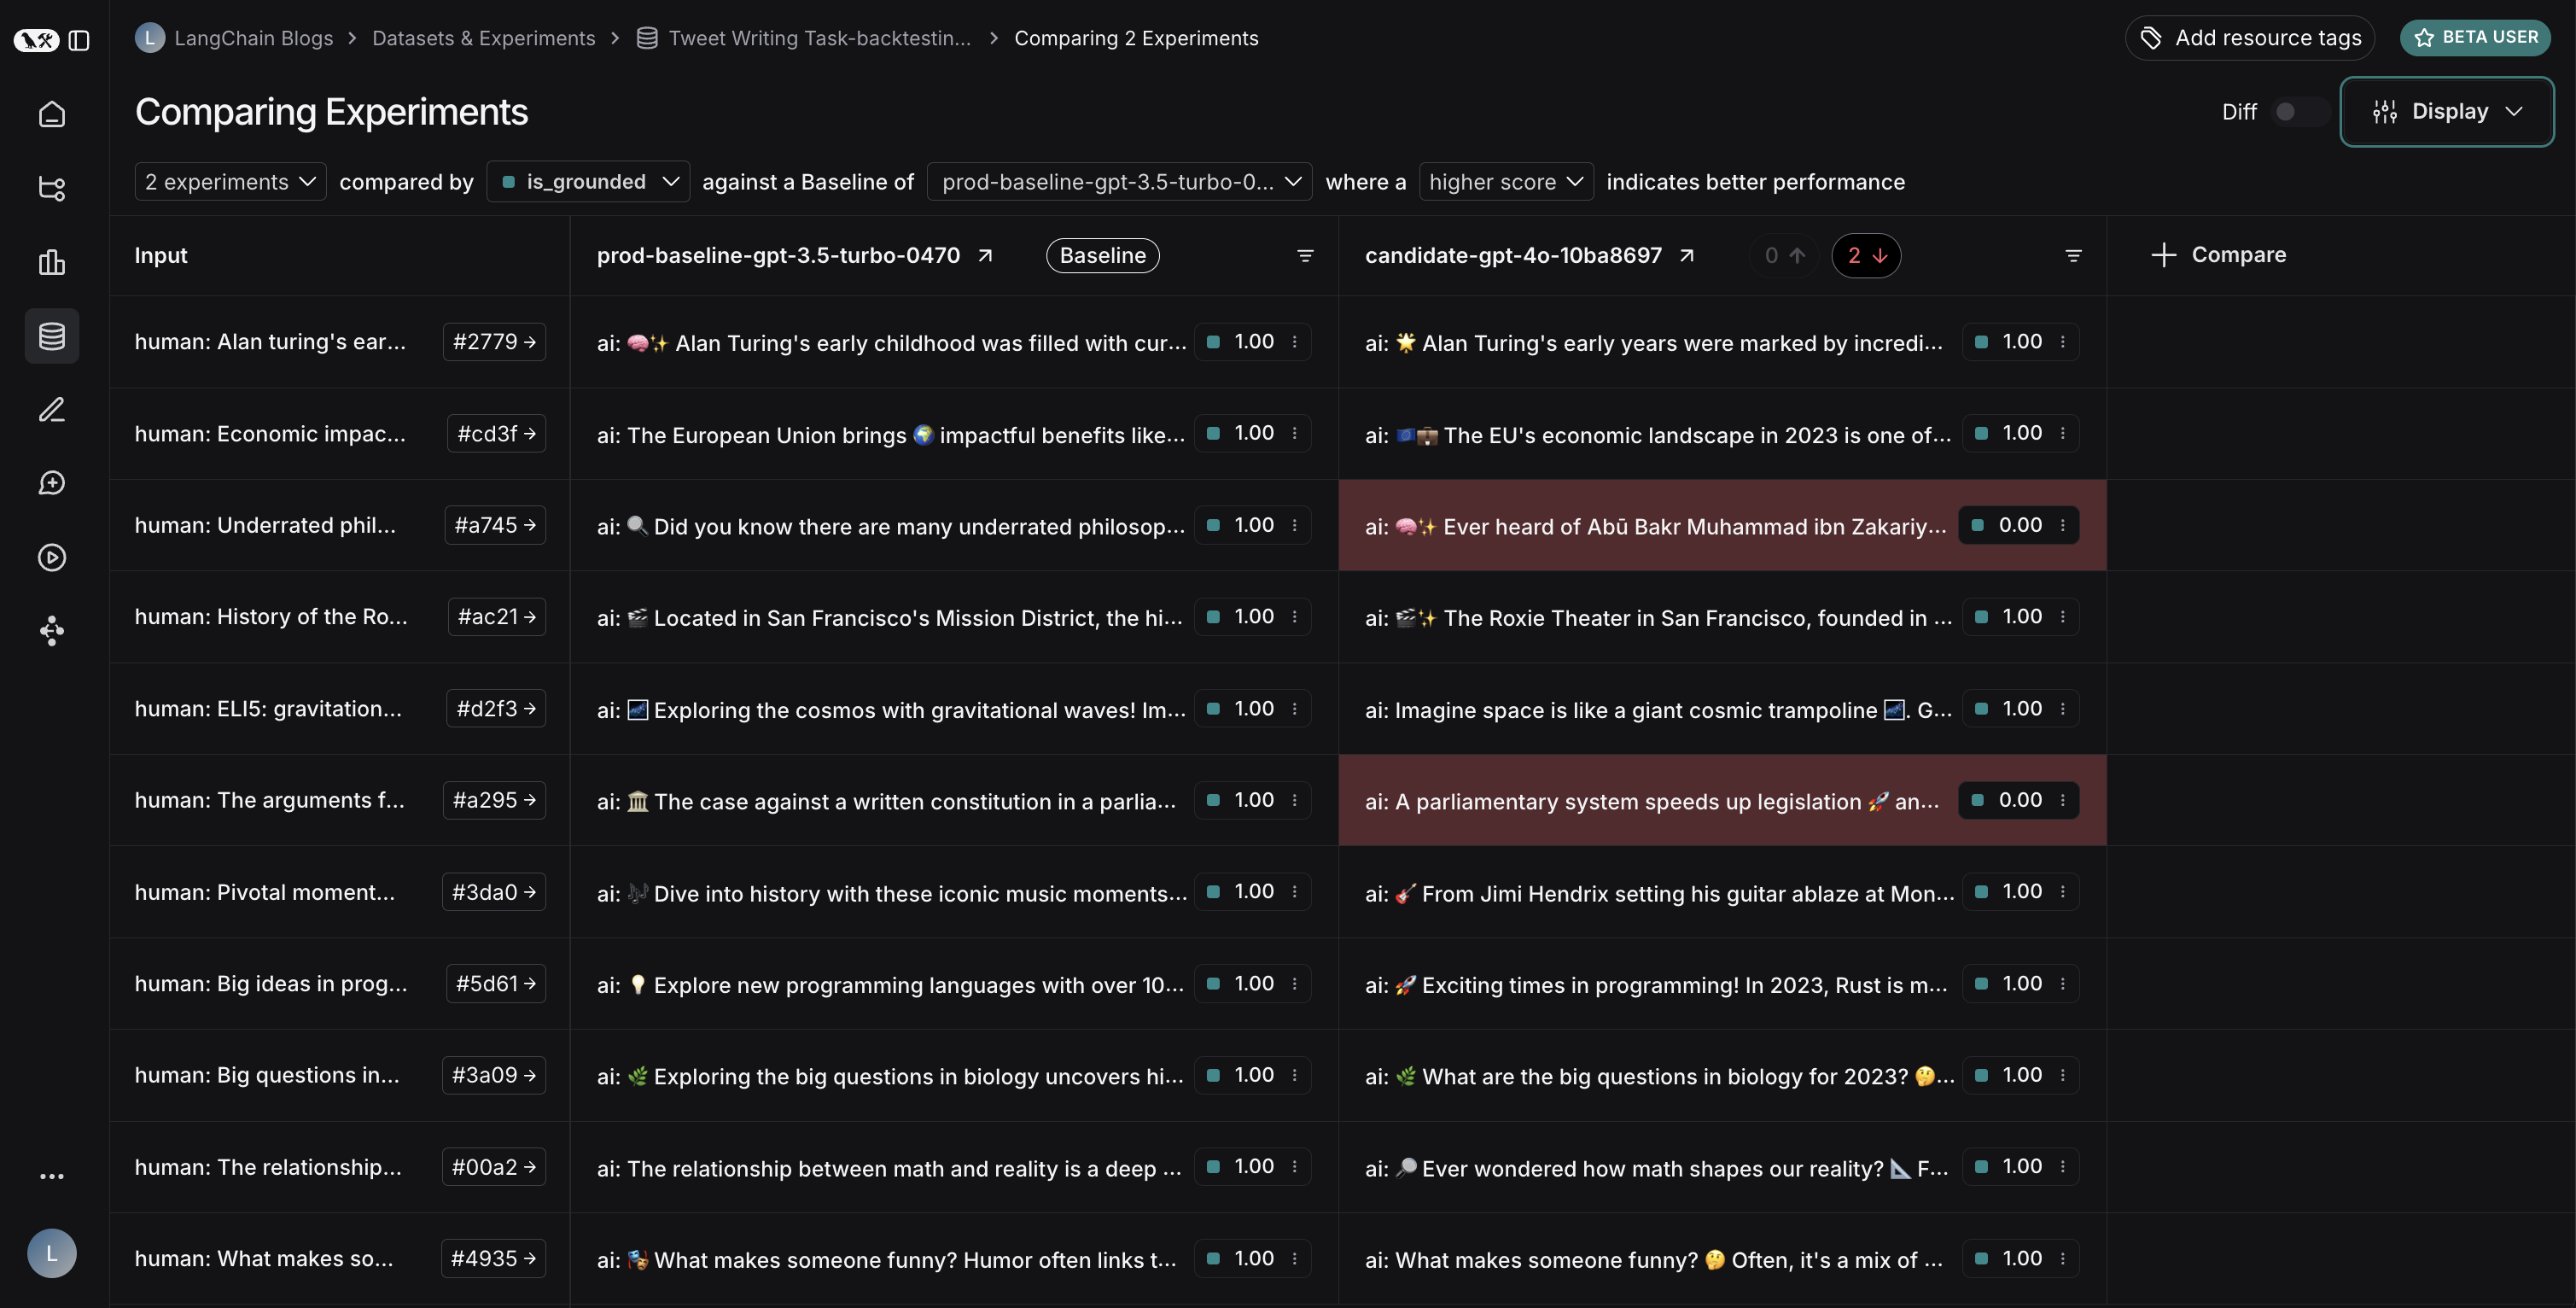
- GPT-4o 在遵守格式规则方面表现更好,始终包含所要求数量的表情符号。
- 然而,GPT-4o 在基于提供的搜索结果方面不太可靠。
- 优化我们的提示词,更加强调仅使用提供的信息
- 或者修改我们的系统架构,以更好地约束模型的输出
Connect these docs to Claude, VSCode, and more via MCP for real-time answers.