

评估什么
在构建评估之前,先确定哪些方面对你的应用最重要。将系统拆分为关键组件——LLM 调用、检索步骤、工具调用、输出格式等——并为每个组件确定质量标准。 从人工整理的示例开始。 为每个关键组件创建 5–10 个“什么样的结果才算好”的示例。这些示例可以作为真实标准,并帮助你确定应采用哪种评估方法。例如:- RAG 系统:良好检索结果(相关文档)和良好答案(准确、完整)的示例。
- Agent:正确选择工具、正确格式化参数,或 Agent 所采取的正确执行轨迹的示例。
- 聊天机器人:有帮助、符合品牌调性的响应示例,并且能够解决用户意图。
离线评估和在线评估
LangSmith 支持两种评估类型,分别服务于开发流程中的不同目的:离线评估
使用离线评估进行部署前测试:- 基准测试:比较多个版本,找出表现最佳的版本。
- 回归测试:确保新版本不会降低质量。
- 单元测试:验证各个组件的正确性。
- 回测:使用历史数据测试新版本。
在线评估
使用在线评估进行生产环境监控:- 实时监控:持续跟踪线上流量的质量。
- 异常检测:标记异常模式或边界情况。
- 生产反馈:发现问题,并将其添加到离线数据集中。
评估生命周期
在开发并部署应用时,你的评估策略会从部署前测试逐步发展到生产环境监控。在开发和测试期间,离线评估使用经过整理的数据集验证功能。部署后,在线评估会在线上流量中监控生产环境行为。随着应用日趋成熟,两种评估类型会在迭代反馈循环中协同工作,持续改进质量。1. 使用离线评估进行开发
在部署到生产环境之前,使用离线评估验证功能、对不同方法进行基准测试,并建立信心。 请按照快速入门运行你的第一个离线评估。2. 使用在线评估进行初始部署
部署后,使用在线评估监控生产环境质量、检测意外问题,并收集真实世界数据。 了解如何为生产环境监控配置在线评估。3. 持续改进
在迭代反馈循环中结合使用两种评估类型。在线评估发现的问题会转化为离线测试用例,离线评估验证修复结果,而在线评估则确认生产环境中的改进效果。核心评估目标
评估运行在不同目标上,具体取决于它是离线评估还是在线评估。离线评估的目标
离线评估运行在数据集和示例上。由于存在参考输出,因此可以比较预期结果与实际结果。数据集
数据集是用于评估应用的_示例集合_。示例是一对测试输入和参考输出。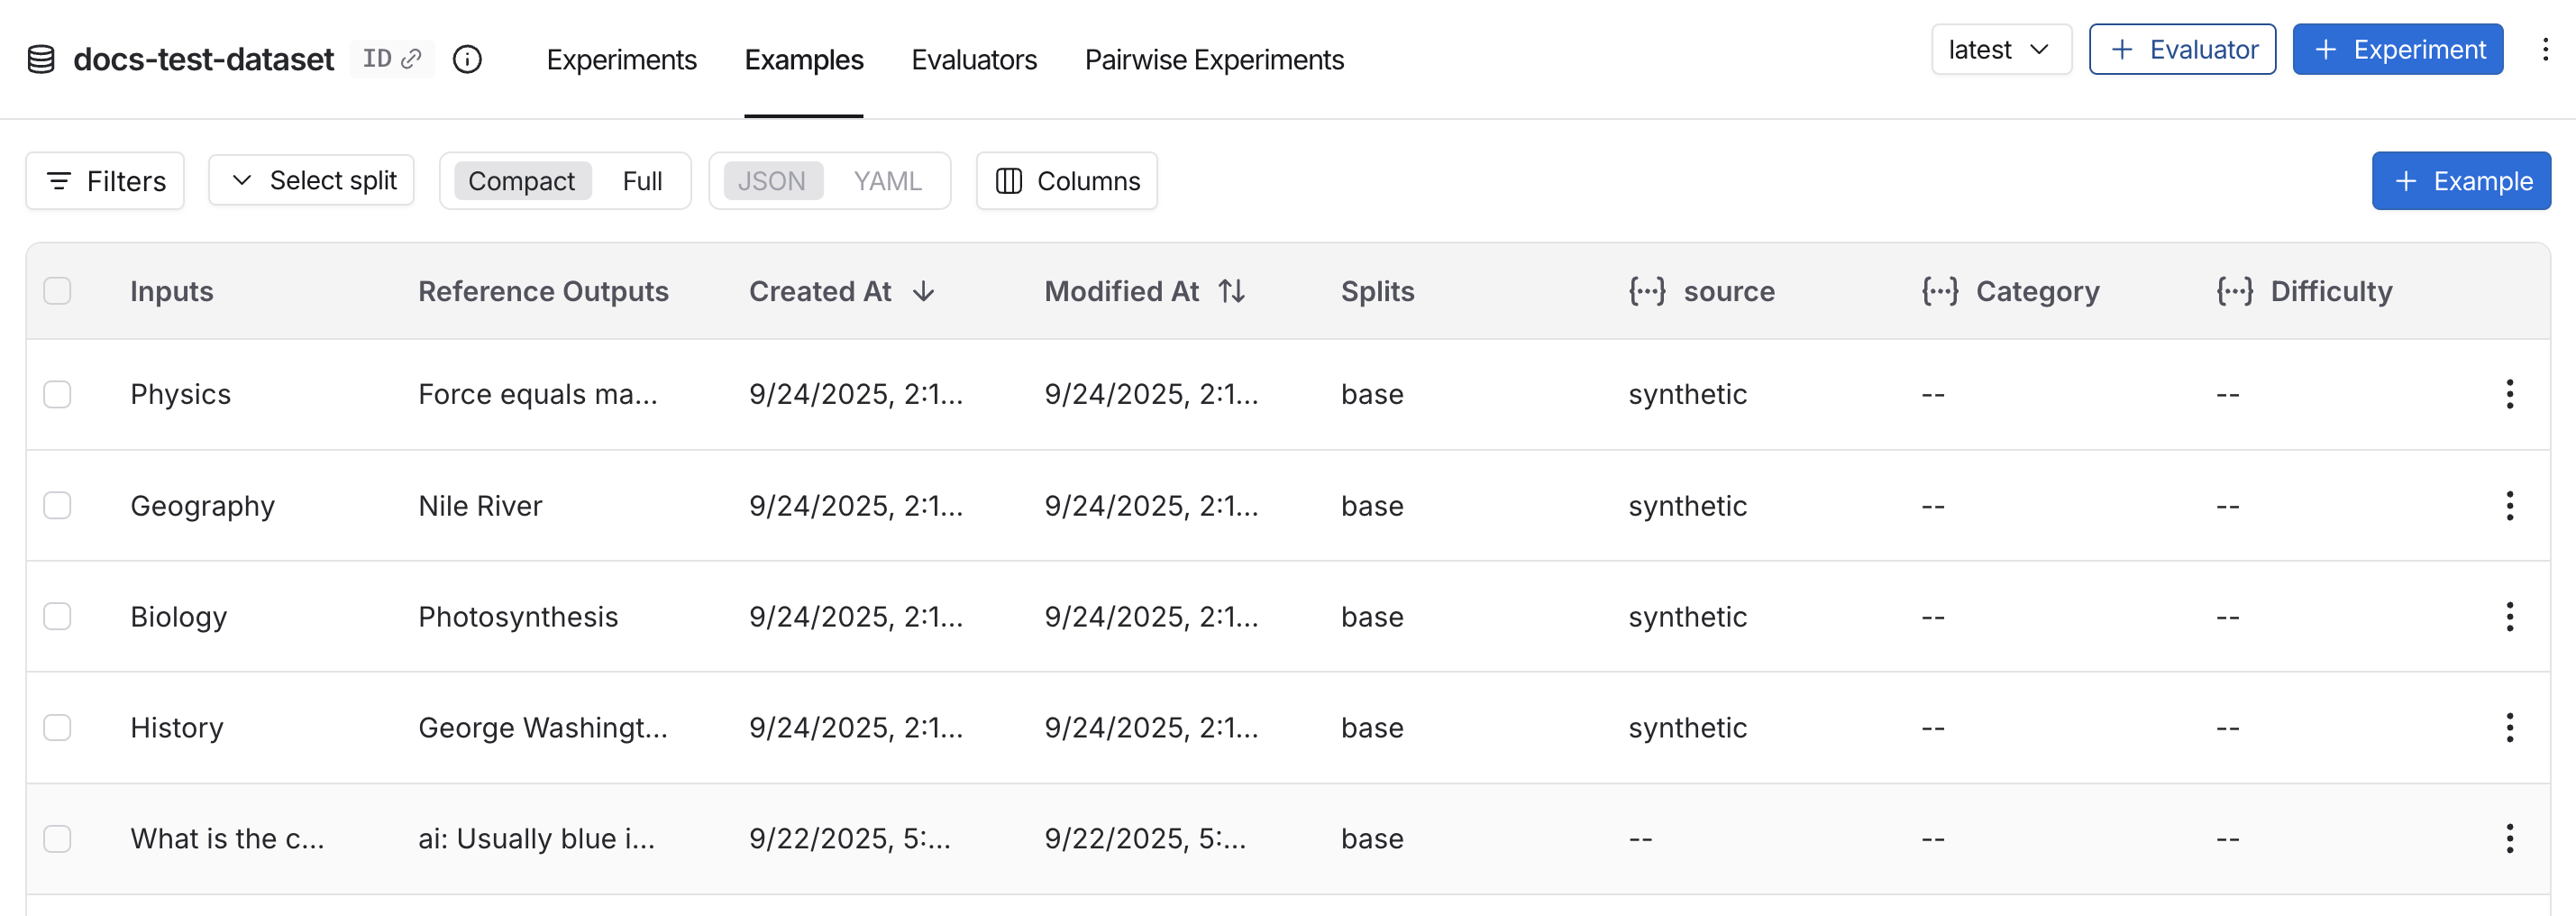
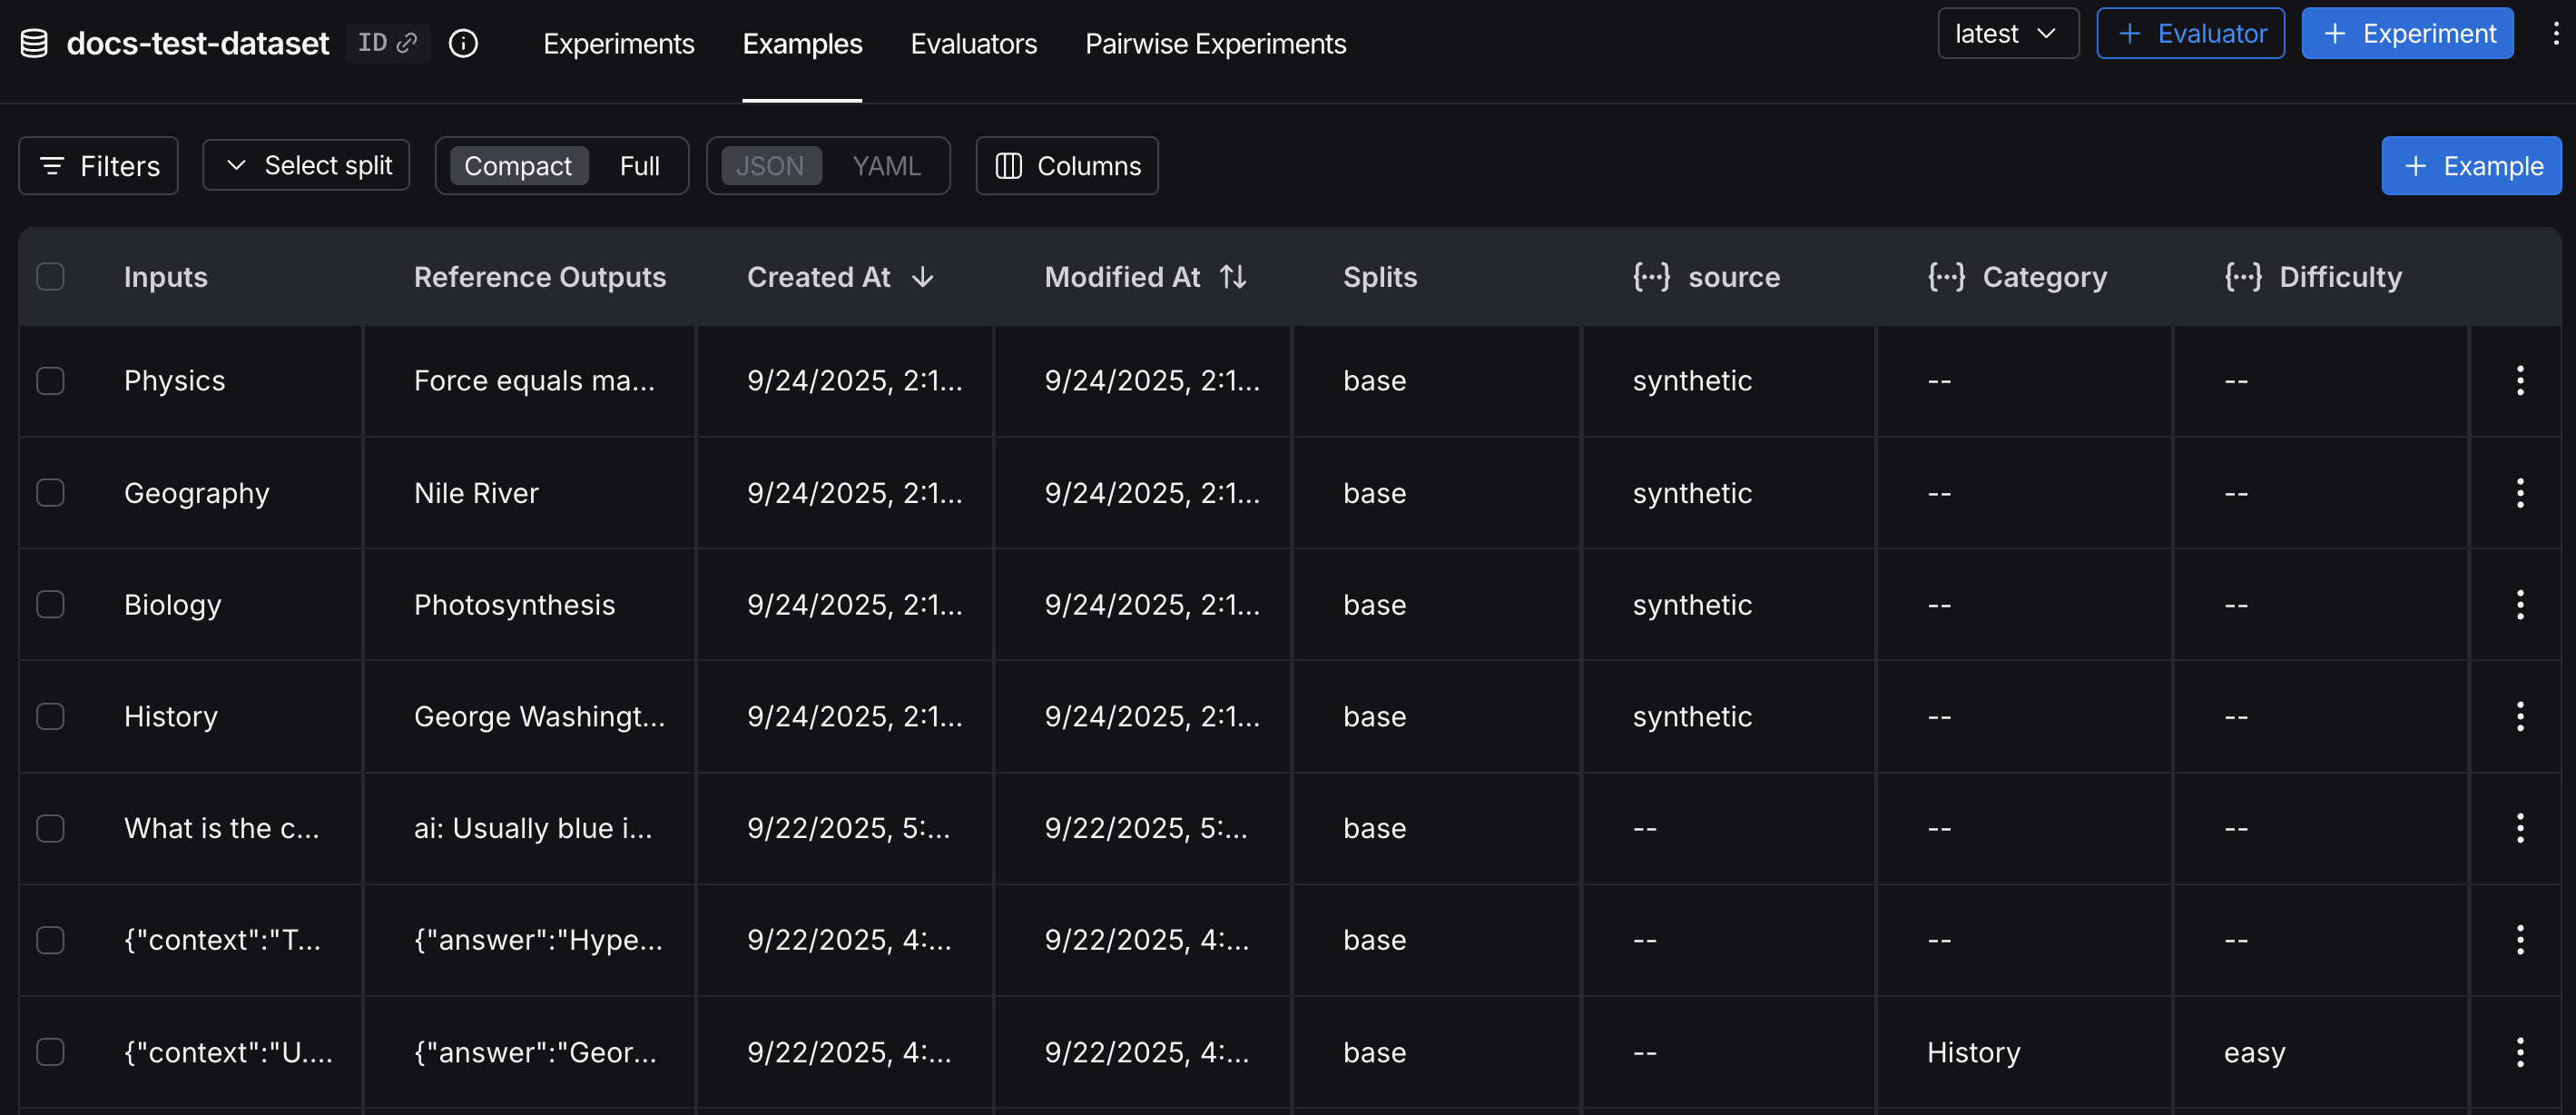
示例
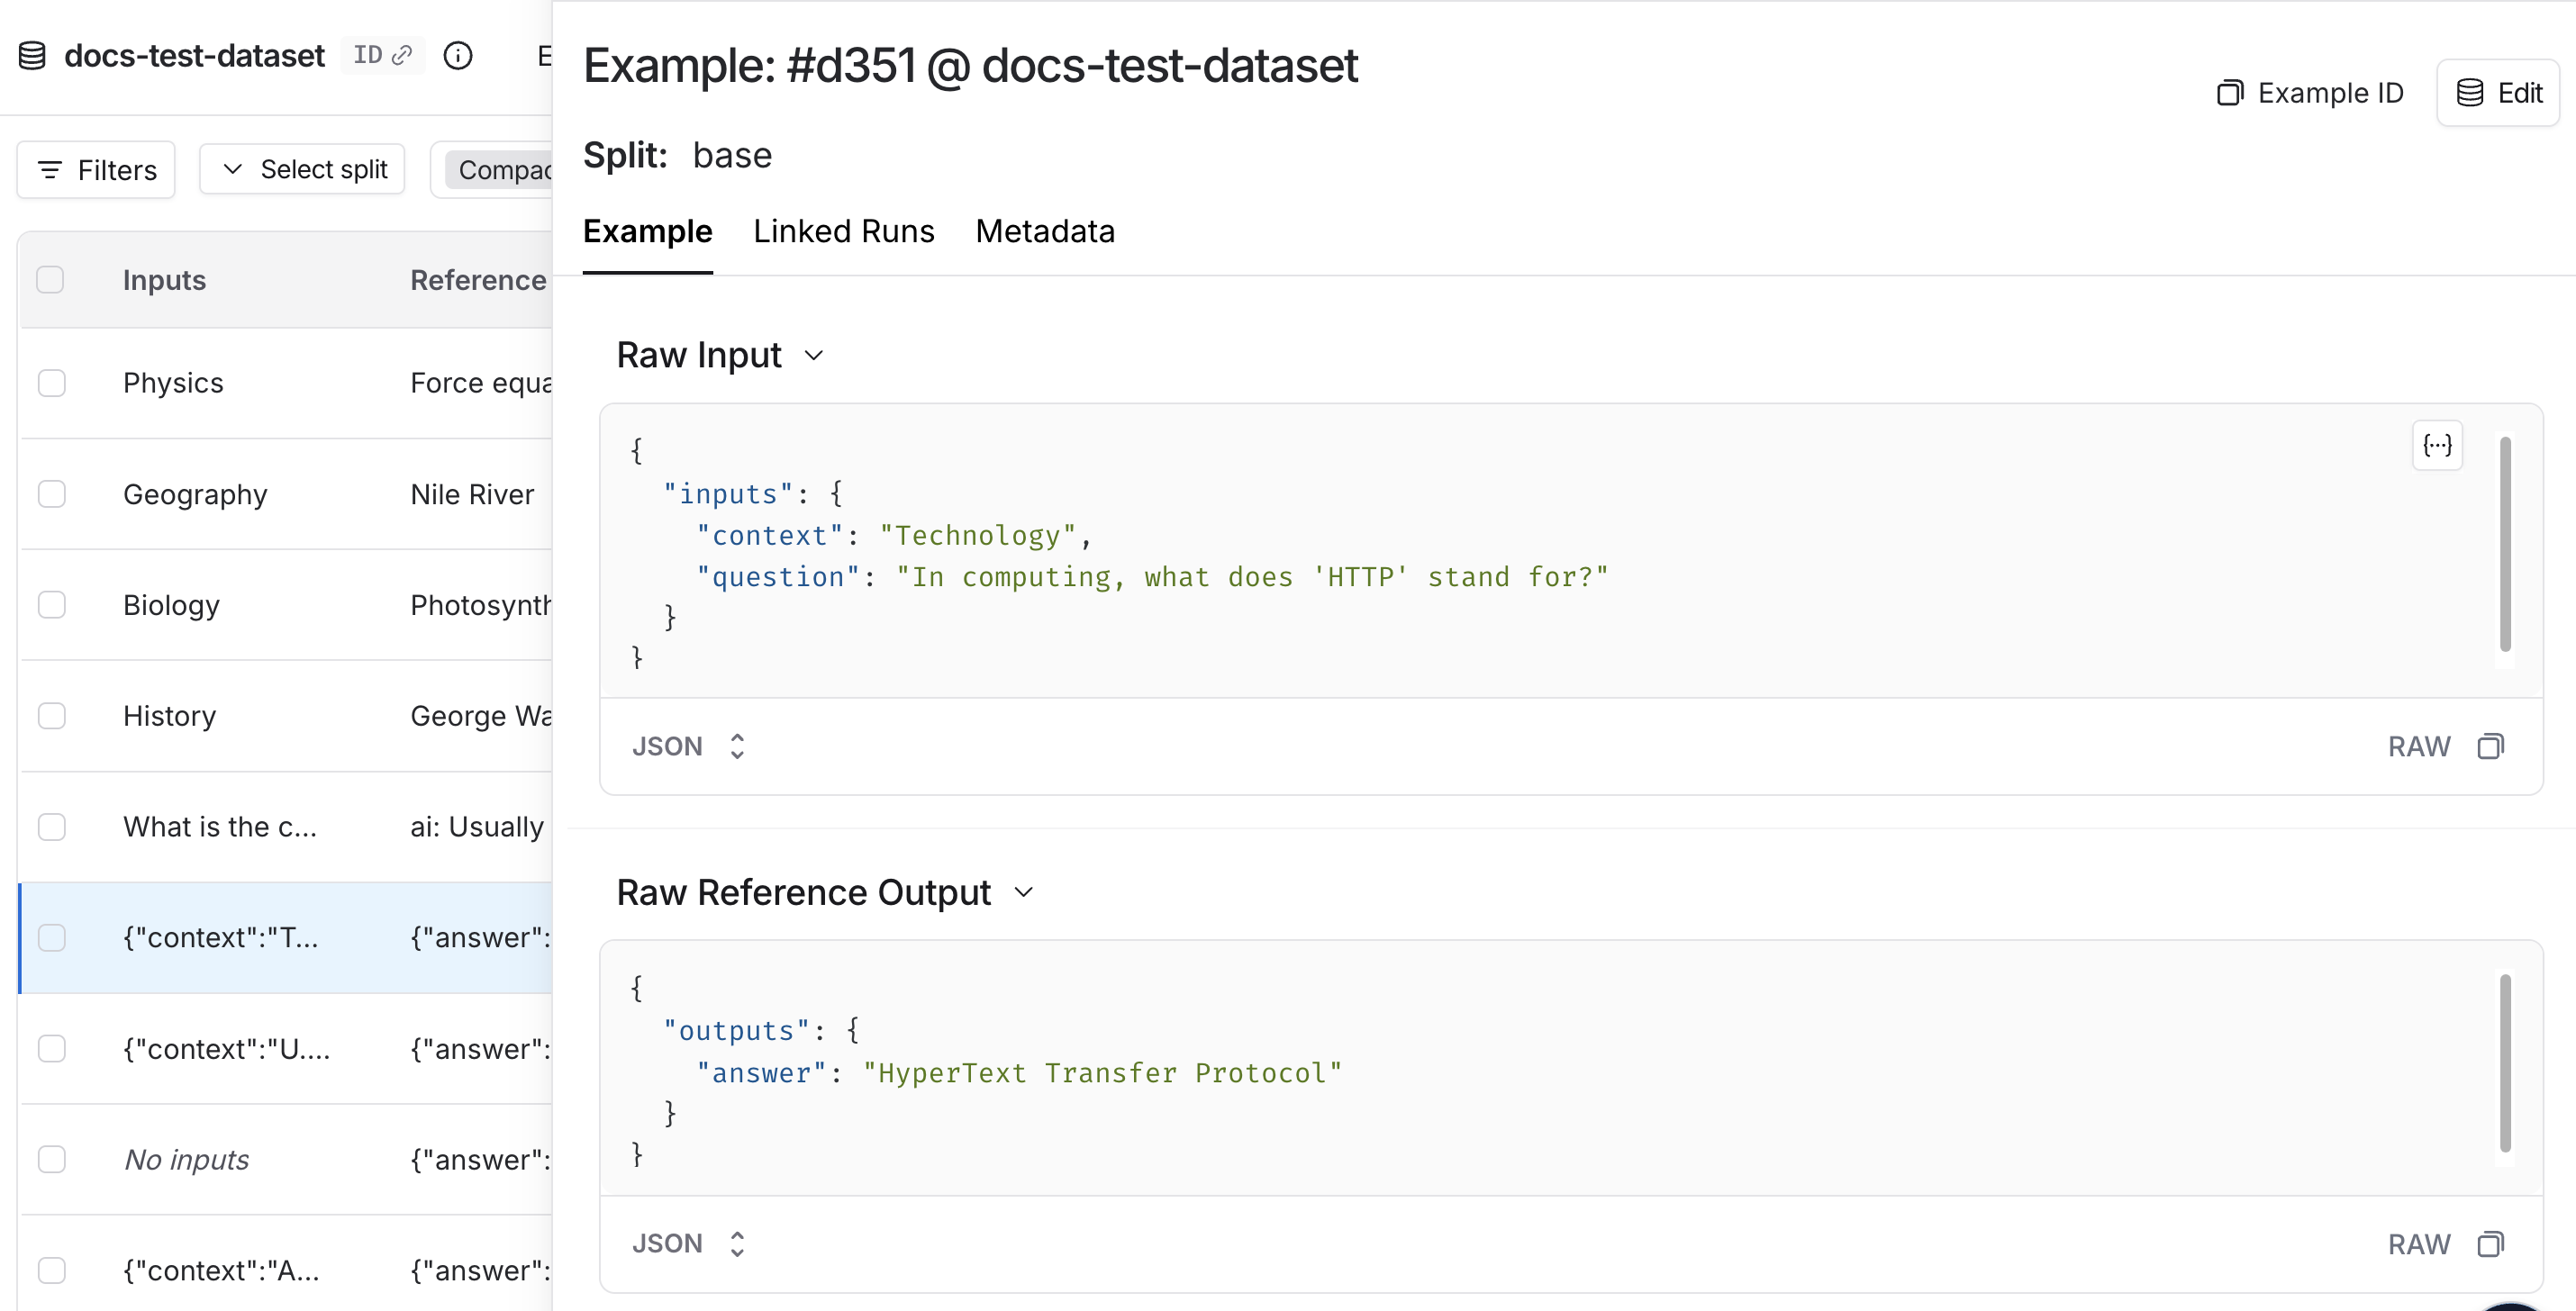
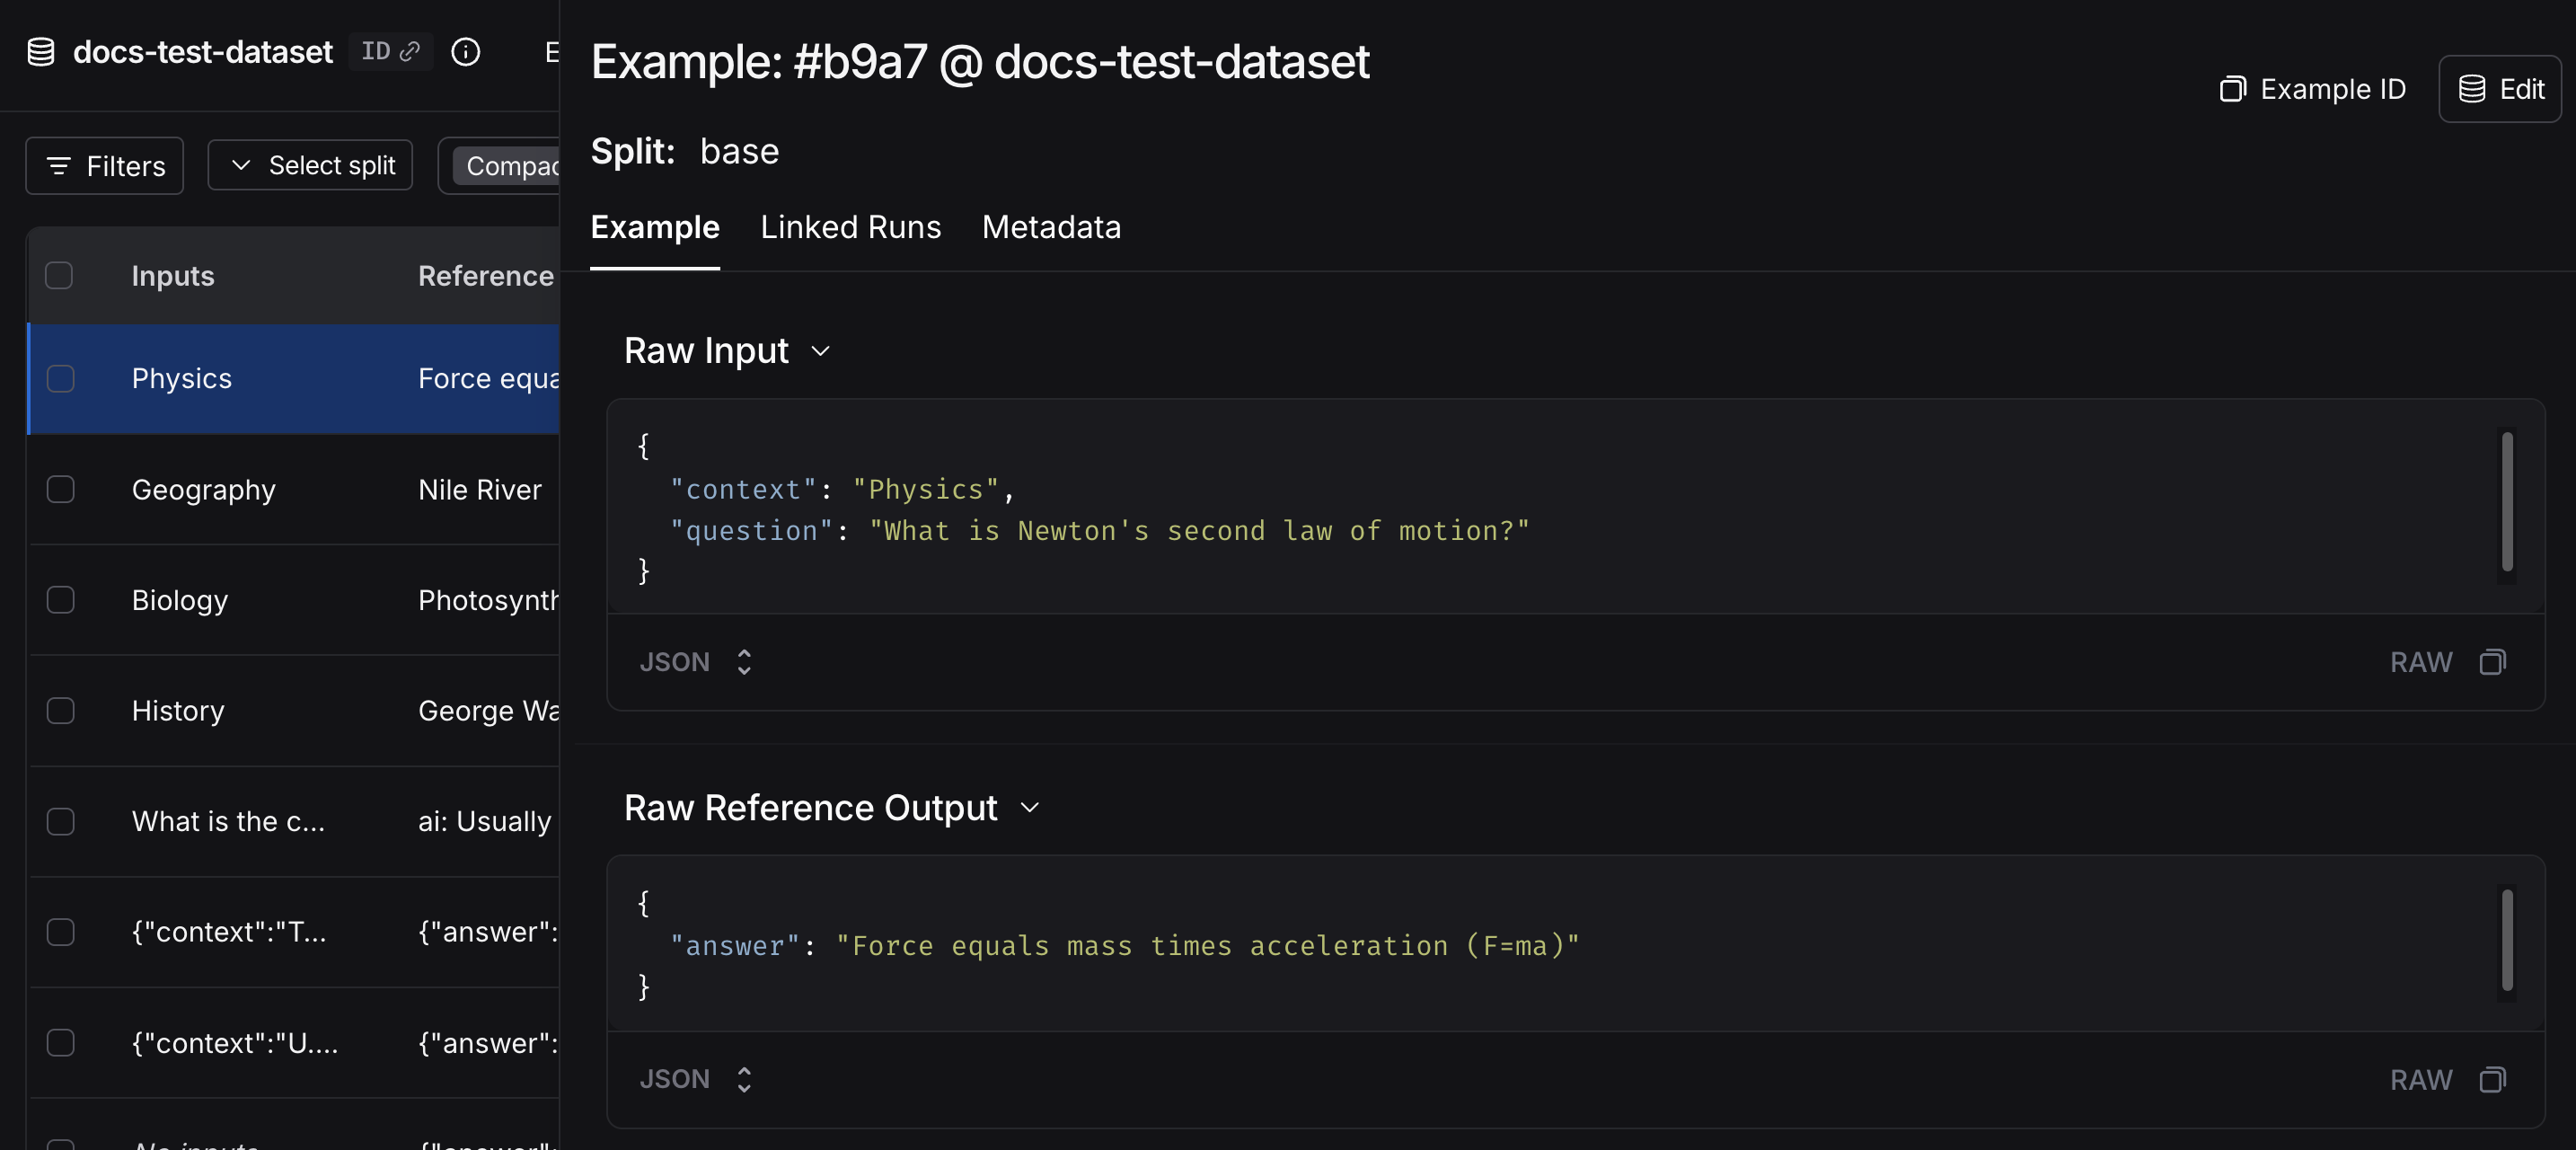
每个示例由以下部分组成:- 输入:要传递给应用的输入变量字典。
- 参考输出(可选):参考输出字典。这些内容不会传递给应用,仅用于评估器。
- 元数据(可选):可用于创建数据集筛选视图的附加信息字典。
 详细了解管理数据集。
实验
_实验_表示在某个数据集上评估特定应用版本所得到的结果。每个实验都会记录该数据集中每个示例的输出、评估器分数和执行追踪记录。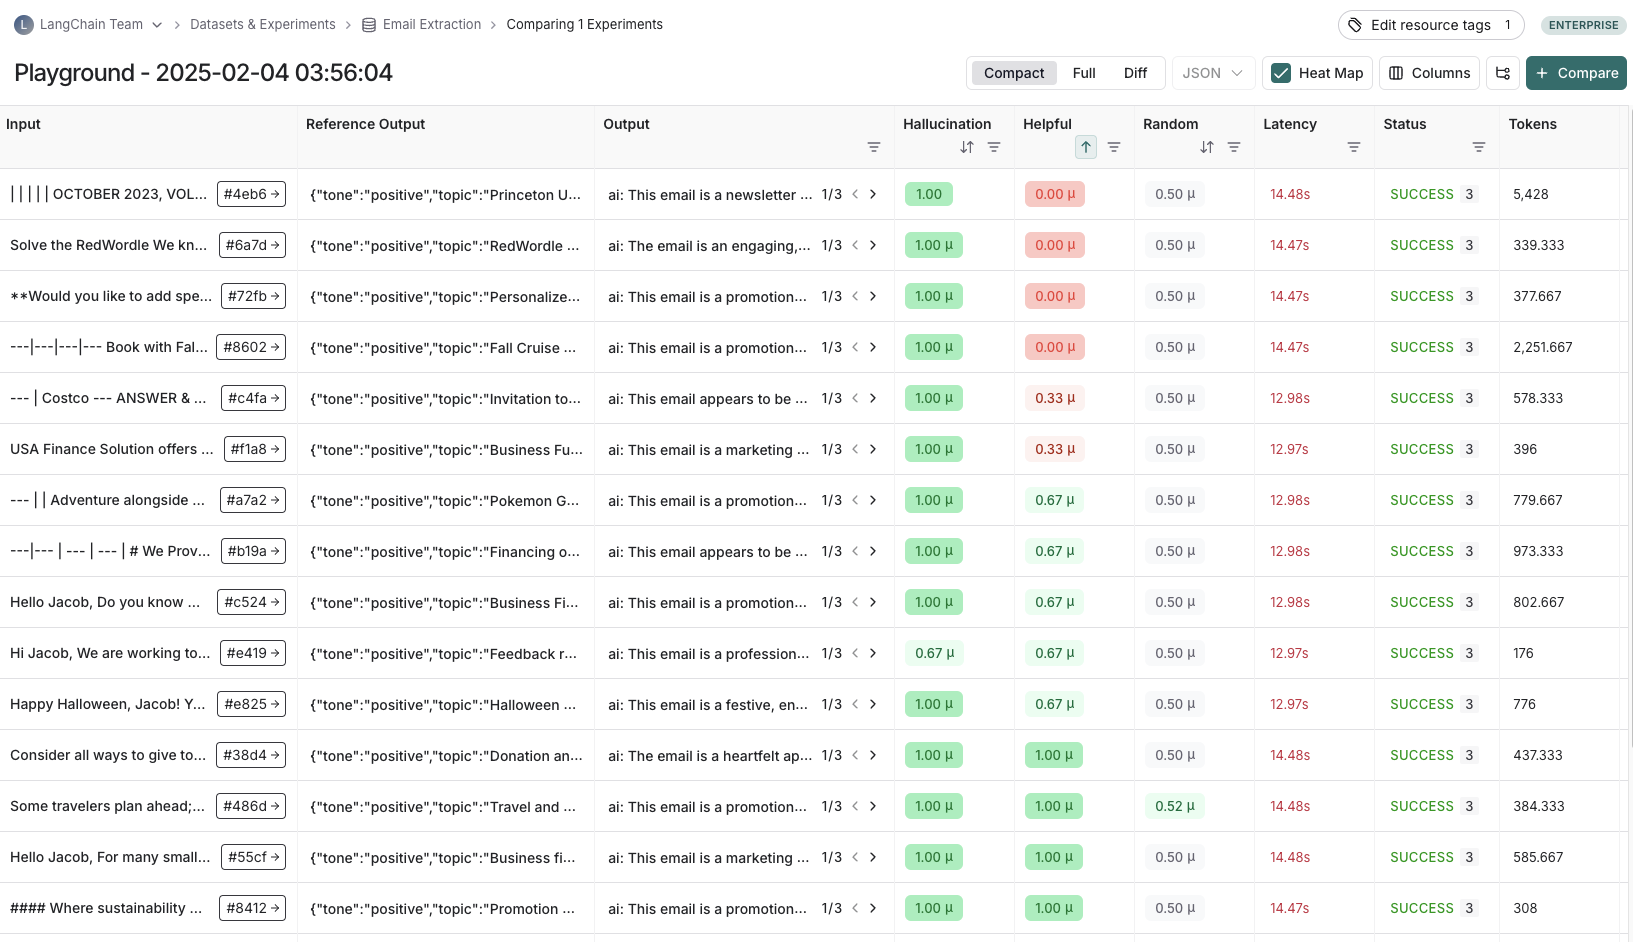 通常会在同一个数据集上运行多个实验,以测试不同的应用配置(例如不同的提示词或 LLM)。LangSmith 会显示与数据集关联的所有实验,并支持并排比较多个实验。
了解如何分析实验结果。
在线评估的目标
在线评估运行在生产流量中的运行和线程上。由于没有参考输出,评估器会专注于实时检测问题、异常和质量下降。运行
_运行_是来自已部署应用的一条执行追踪记录。每次运行包含:- 输入:应用实际接收到的用户输入。
- 输出:应用实际返回的内容。
- 中间步骤:所有子运行(工具调用、LLM 调用等)。
- 元数据:标签、用户反馈、延迟指标等。
线程
_线程_是表示多轮对话的相关运行集合。在线评估器可以在线程级别运行,以评估完整对话,而不是单独的轮次。这样就可以评估跨轮次连贯性、主题保持情况以及整个交互过程中的用户满意度等对话级属性。评估器
_评估器_是用于评估应用性能的工作区级资源。它们为离线评估和在线评估提供度量层,并根据可用数据调整输入。由于评估器的作用域为工作区,因此你可以将同一个评估器关联到多个追踪项目和数据集,而不必每次重新创建。 可以通过以下任一方式运行评估器:- 评估器页面,用于将评估器关联到追踪项目或数据集
- Playground
- LangSmith SDK(Python 和 TypeScript)
- 规则,用于在追踪项目或数据集上自动运行评估器
将评估器关联到追踪项目或数据集
单个评估器可以关联到多个追踪项目和数据集。采样率、筛选器和支出限制等配置,是针对每个已关联的项目或数据集设置的,而不是针对评估器设置的。在评估器的 项目和数据集 标签页中,可以查看与其关联的项目和数据集。评估器输入
评估器的输入取决于评估类型: 离线评估器接收: 在线评估器接收:- 运行:包含输入、输出和中间步骤的生产环境追踪记录(不包含参考输出)。
评估器输出
评估器返回反馈,即评估得到的分数。反馈是一个字典或字典列表。每个字典包含:key:指标名称。score|value:指标值(数值指标使用score,类别指标使用value)。comment(可选):对该分数的补充理由或解释。
评估技术
LangSmith 支持多种评估方法:人工评估
_人工评估_涉及人工检查应用输出和执行追踪记录。这种方法通常是开始评估的有效方式。LangSmith 提供了用于检查应用输出和追踪记录(所有中间步骤)的工具。 标注队列 标注队列可以简化对运行进行结构化人工反馈收集的过程。它们通过提供具有预设评分标准、团队协作功能和进度跟踪的有组织工作流,补充内联标注。 LangSmith 支持两种队列类型:- 单运行队列:根据自定义评分项,一次检查一条运行。适合问题分类,或从生产环境追踪记录构建数据集。单运行队列还支持断言,即离线评估器可以据此评估未来运行的自由格式验收标准。
- 成对队列:并排比较两条运行,以判断哪一条更好。适用于在实验之间进行快速 A/B 比较。
代码评估
_代码评估器_是确定性的、基于规则的函数。它们适用于以下检查:验证聊天机器人的响应结构不为空、生成的代码可以编译,或分类结果完全匹配。LLM 作为评判者
_作为评判者的 LLM 评估器_使用 LLM 对应用输出进行评分。评分规则和标准通常编码在 LLM 提示词中。这些评估器可以是:- 无参考:检查输出是否包含攻击性内容,或是否符合特定标准。
- 基于参考:将输出与参考内容进行比较(例如,检查相对于参考内容的事实准确性)。
成对评估
_成对评估器_使用启发式方法(例如比较哪条响应更长)、LLM(使用成对比较提示词)或人工评审者,对两个应用版本的输出进行比较。 当直接为单个输出评分较为困难,但比较两个输出相对容易时,成对评估非常有效。例如,在摘要任务中,选择两个摘要中信息更丰富的一个,通常比为单个摘要分配绝对分数更容易。 了解如何运行成对评估。无参考评估器与基于参考的评估器
了解评估器是否需要参考输出,对于确定其适用时机至关重要。 无参考评估器无需与预期输出进行比较即可评估质量,适用于离线评估和在线评估:- 安全检查:毒性检测、个人身份信息(PII)检测、内容政策违规检测
- 格式验证:JSON 结构、必填字段、模式合规性
- 质量启发式指标:响应长度、延迟、特定关键词
- 无参考的 LLM 作为评判者:清晰度、连贯性、有用性、语气
- 正确性:与参考答案的语义相似度
- 事实准确性:根据真实标准进行事实核查
- 完全匹配:具有已知标签的分类任务
- 基于参考的 LLM 作为评判者:将输出质量与参考内容进行比较
评估类型
LangSmith 支持适用于开发和部署不同阶段的多种评估方法。了解每种类型的适用时机,有助于构建全面的评估策略。 离线评估和在线评估服务于不同目的:- 离线评估类型:使用包含参考输出的整理数据集进行部署前测试
- 在线评估类型:在没有参考输出的情况下,监控线上流量中的生产环境行为
最佳实践
构建数据集
构建数据集有多种策略: 人工整理的示例 这是推荐的起点。创建 10–20 个高质量示例,覆盖常见场景和边界情况。这些示例定义了应用中“什么样的结果才算好”。 历史追踪记录 进入生产环境后,将真实追踪记录转换为示例。对于高流量应用:- 用户反馈:添加收到负面反馈的运行,以便进行测试。
- 启发式方法:识别有价值的运行(例如延迟较高或出现错误的运行)。
- LLM 反馈:使用 LLM 检测值得关注的对话。
数据集组织
拆分 拆分是数据集的命名子集,用于将示例划分到不同组中。常见模式包括:- 机器学习风格的拆分:将示例划分为训练集、验证集和测试集,以避免过拟合,即模型在训练数据上表现良好,但在未见过的数据上表现较差。
- 基于类别的拆分:当数据集涵盖多个任务类别时,分别评估不同类型的输入。
- 分阶段发布:将探索性示例单独存放,直到准备好将其纳入主要评估集。
收集人工反馈
人工反馈通常能提供最有价值的评估,尤其是在评估主观质量维度时。 标注队列 标注队列支持结构化收集人工反馈。标记需要检查的特定运行,通过简化的界面收集标注,并将带有标注的运行转移到数据集中,用于未来的评估。 标注队列通过提供运行分组、指定标准和配置评审者权限等额外功能,补充内联标注。评估与测试
测试和评估是相似但不同的概念。 评估根据指标衡量性能。 指标可能是模糊的或主观的,以相对值表示时通常更有用。它们通常用于比较不同系统。 测试验证正确性。 只有通过所有测试,系统才能部署。 评估指标可以转换为测试。例如,回归测试可以断言:新版本必须在相关指标上优于基准版本。当系统运行成本较高时,可以同时运行测试和评估,以提高效率。 可以使用pytest或Vitest/Jest等标准测试工具编写评估。快速参考:离线评估与在线评估
下表总结了离线评估和在线评估之间的主要差异:Connect these docs to Claude, VSCode, and more via MCP for real-time answers.