

智能体
由 LLM 驱动的自主智能体由三个组件组成:(1) 工具调用、(2) 记忆和 (3) 规划。智能体通过规划(例如,通常通过提示实现)和记忆(例如,通常使用短期消息历史记录)来使用工具调用生成响应。工具调用允许模型响应给定的提示,生成两项内容:(1) 要调用的工具,以及 (2) 工具所需的输入参数。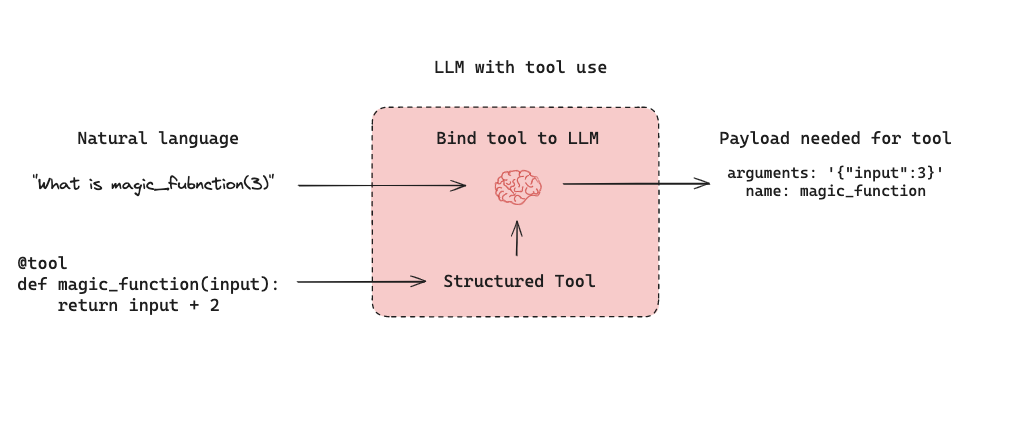 下面是一个使用 LangGraph 构建的工具调用智能体。
assistant node 是一个 LLM,它根据输入决定是否调用工具。tool condition 用于判断 assistant node 是否选择了某个工具;如果选择了,则将流程路由到 tool node。tool node 执行工具,并将输出作为工具消息返回给 assistant node。只要 assistant node 选择工具,这个循环就会继续。如果没有选择工具,智能体就会直接返回 LLM 响应。
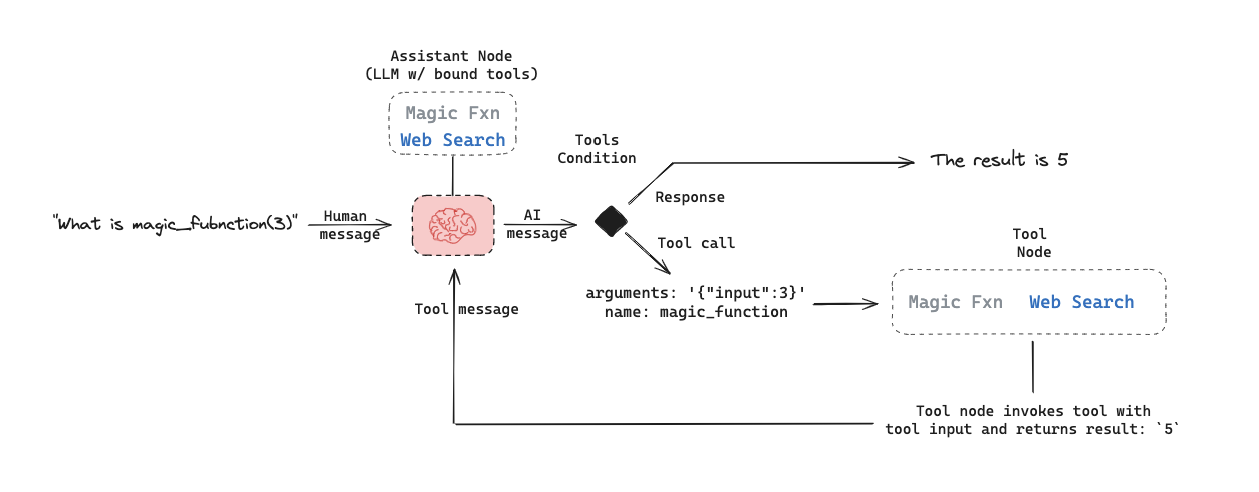 这就形成了用户通常感兴趣的三类智能体评估:
最终响应:评估智能体的最终响应。单步:单独评估智能体中的某一步(例如,判断它是否选择了合适的工具)。轨迹:评估智能体是否按照预期路径执行(例如,工具调用路径)来得出最终答案。
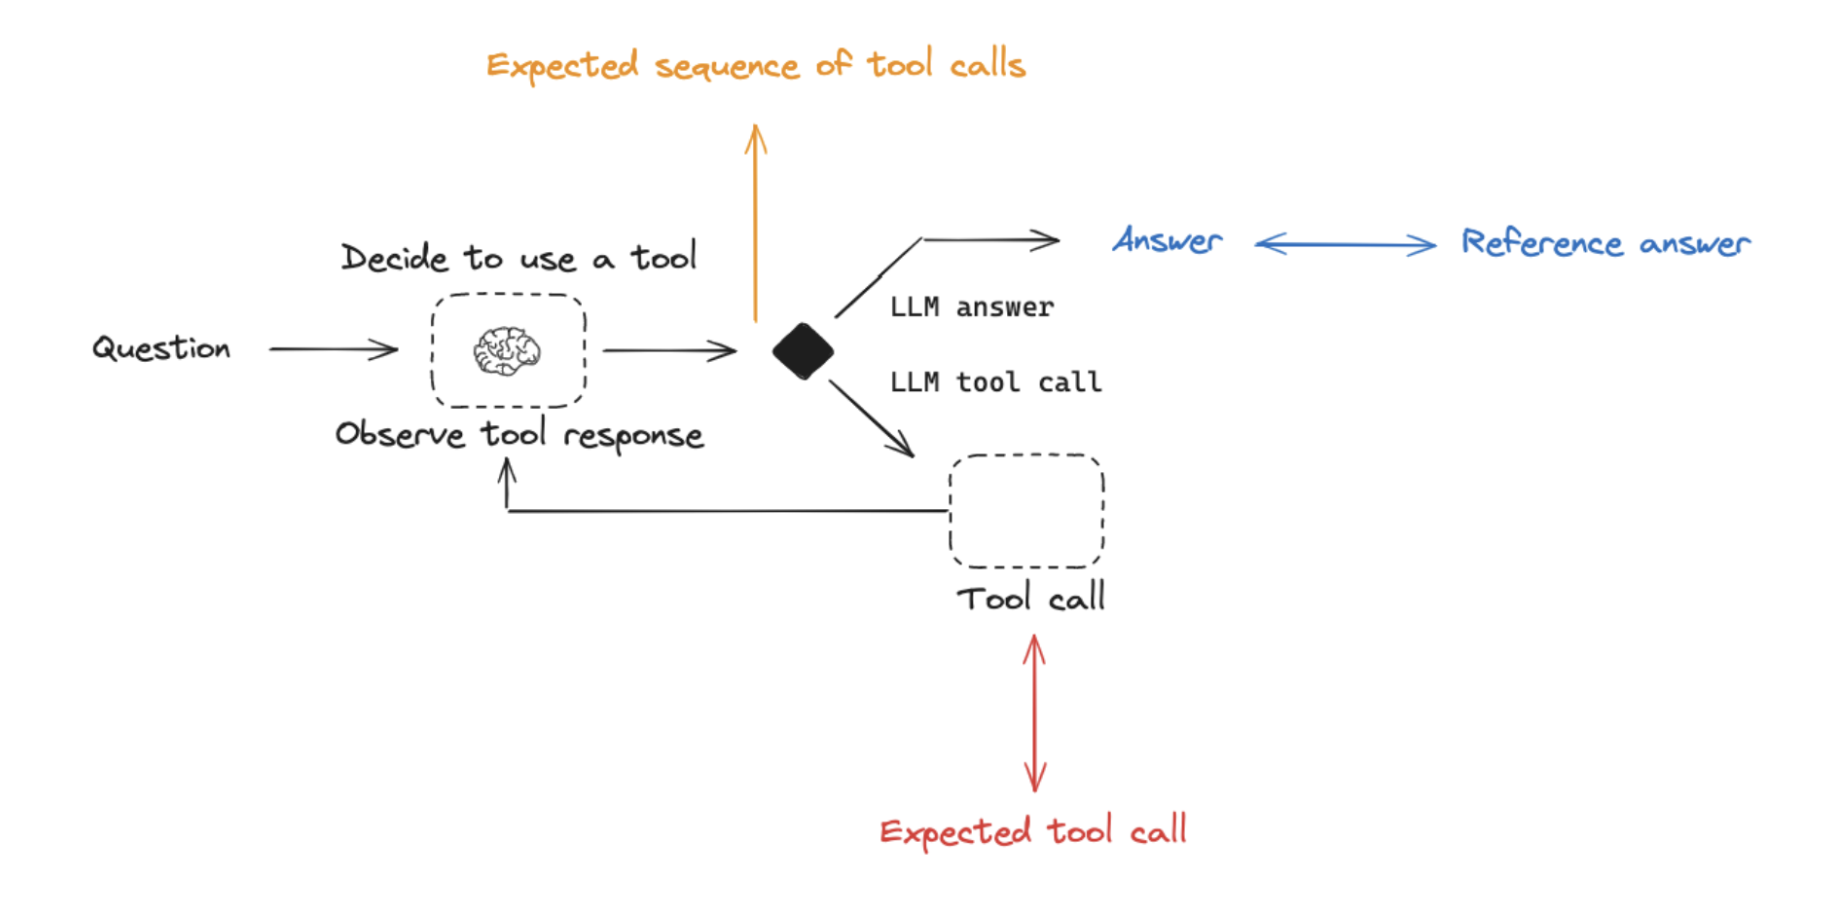 以下部分将介绍这些评估类型、每种评估所需的组件(输入、输出和评估器),以及适用场景。实际使用中通常会组合使用其中多种或全部评估类型;它们并不互斥。
评估智能体的最终响应
评估智能体的一种方式是评估它在某项任务上的整体表现。基本做法是将智能体视为一个黑盒,只评估它是否完成了任务。 输入应包括用户输入,以及(可选的)工具列表。在某些情况下,工具已作为智能体的一部分硬编码,因此不需要传入。其他情况下,智能体更加通用,没有固定的工具集,因此需要在运行时传入工具。 输出应为智能体的最终响应。 评估器会根据要求智能体执行的任务而有所不同。许多智能体会执行一系列相对复杂的步骤,然后输出最终的文本响应。与 RAG 类似,在这类情况下,LLM-as-judge 评估器通常很有效,因为它们可以直接根据文本响应判断智能体是否完成了任务。 不过,这种评估方式也有一些缺点。第一,它通常需要较长时间才能运行。第二,它不会评估智能体内部发生的任何事情,因此出现故障时可能很难调试。第三,有时很难定义合适的评估指标。评估智能体的单个步骤
智能体通常会执行多个操作。虽然端到端评估很有用,但评估这些单独的操作也很有帮助。这通常意味着评估智能体的单个步骤,即 LLM 决定下一步行动时进行的调用。 输入应为单个步骤的输入。具体取决于测试内容,它可能只是原始用户输入(例如,一个提示和/或一组工具),也可能还包括之前已经完成的步骤。 输出就是该步骤的输出,通常是 LLM 响应。LLM 响应通常包含工具调用,用于指示智能体下一步应执行的操作。 这类评估器通常会使用二元分数来判断是否选择了正确的工具调用,同时使用某种启发式方法判断传入工具的输入是否正确。参考工具可以直接指定为字符串。 这种评估方式有多项优点。它允许你评估单独的操作,从而更准确地定位应用可能出现故障的位置。运行速度也相对较快(因为只涉及一次 LLM 调用),并且评估通常只需使用简单的启发式方法,将所选工具与参考工具进行比较。缺点之一是,它无法捕捉完整的智能体行为,只能评估其中某一个特定步骤。另一个缺点是,创建数据集可能比较困难,尤其是在希望将历史记录包含在智能体输入中的情况下。为智能体轨迹早期的步骤生成数据集相对容易(例如,可能只包含输入提示),但为轨迹后期的步骤生成数据集则可能很困难(例如,需要包含之前的大量智能体操作和响应)。评估智能体的轨迹
评估智能体的轨迹意味着评估智能体执行的所有步骤。 输入仍然是整个智能体的输入(用户输入,以及可选的工具列表)。 输出是工具调用列表。它可以表示为“精确”轨迹(例如,预期的工具调用序列),也可以只是一个预期工具调用的集合(调用顺序不限)。 这里的评估器是一个作用于已执行步骤的函数。评估“精确”轨迹时,可以使用一个二元分数,确认序列中每个工具名称是否完全匹配。这种方法很简单,但存在一些问题。有时可能存在多条正确路径。此外,这种评估无法区分轨迹只偏离了一步和轨迹完全错误这两种情况。 为了解决这些问题,评估指标可以关注执行的“错误”步骤数量,从而更好地反映轨迹接近预期还是存在较大偏差。评估指标还可以关注所有预期工具是否都被调用,而不考虑调用顺序。 不过,这些方法都不会评估传递给工具的输入;它们只关注所选工具。为了将工具输入纳入评估,另一种评估技术是将智能体的完整轨迹(以及参考轨迹)作为一组消息(例如,所有 LLM 响应和工具调用)传递给 LLM-as-judge。这样可以评估智能体的完整行为,但编制这种最完整的参考数据也最具挑战性。这正是使用 LangGraph 等框架可以提供帮助的地方。另一个缺点是,设计评估指标可能会比较棘手。评估 RAG 应用
检索增强生成(RAG)会针对用户输入检索文档,并将这些文档传递给模型,使响应能够使用外部知识。有关分步操作指南,请参阅评估 RAG 应用。选择数据集
评估 RAG 应用时,首先要确定每个示例是否都有参考答案:- 有参考答案:将其作为真实标准,用于评估答案的正确性。
- 没有参考答案:使用无参考提示,检查文档相关性、答案忠实度和有用性(请参阅 RAG 评估摘要)。
选择评估器
LLM-as-judge 评估器非常适合 RAG,因为它们可以评估事实准确性以及文本之间的一致性。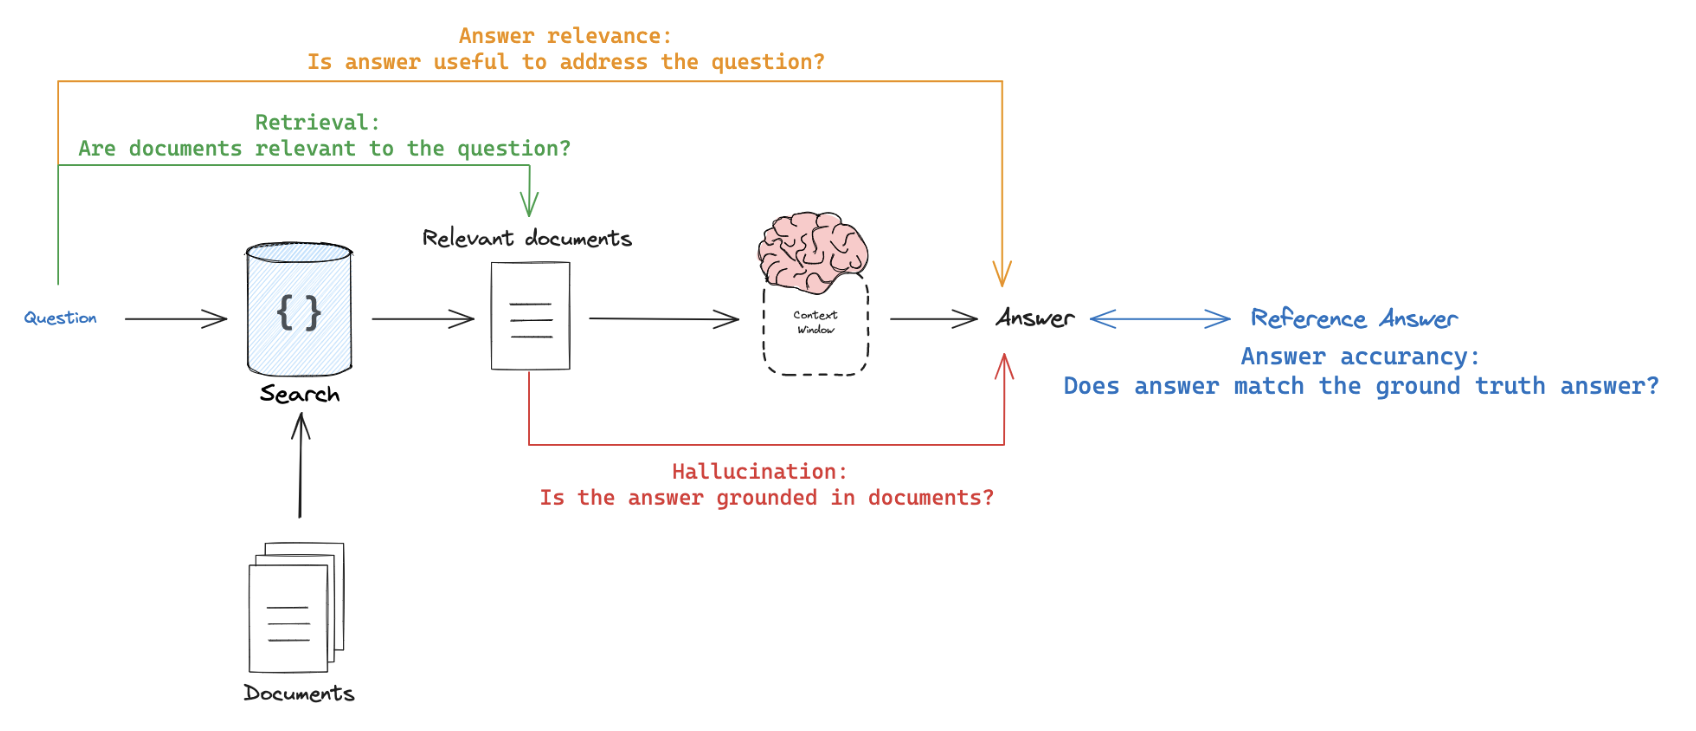 你可以使用两类评估器:
- 基于参考的评估器:将生成的答案或检索到的文档与参考答案或参考检索结果进行比较。
- 无参考评估器:运行不需要参考答案的一致性检查(上图中的橙色、绿色和红色部分)。
选择评估模式
- 离线:当提示需要参考答案时使用,最常见的场景是评估答案正确性。
- 在线:对无参考提示使用,以便评估实时流量。
- 成对比较:根据格式或风格等标准,比较不同 RAG 链生成的答案。正确性评估应改用一致性检查或参考答案。
RAG 评估摘要
摘要生成
摘要生成是一种特定类型的自由形式写作。其评估目标通常是根据一组标准来检查写作内容(摘要)。 评估中通常会使用用于摘要生成的文本开发者整理的示例(请参阅摘要数据集示例)。不过,也可以使用生产环境中摘要应用的用户日志,结合下面任意一种无参考评估提示进行在线评估。
摘要生成(以及其他类型的写作)通常使用 LLM-as-judge 进行评估,配合基于给定标准对摘要评分的无参考提示。由于摘要生成是一项创造性任务,可能存在许多正确答案,因此较少提供特定的参考摘要。
由于使用了无参考提示,在线或离线评估都是可行的。成对比较也是比较不同摘要链的有效方式(例如,比较不同的摘要提示或 LLM):
分类和标记
分类和标记会为给定输入应用一个标签(例如,用于毒性检测、情感分析等)。分类/标记评估通常包含以下组件,下面将详细介绍这些组件: 分类/标记评估的一个核心考量是:是否有包含参考标签的数据集。如果没有,用户通常希望定义一个基于标准为输入应用标签的评估器(例如,将毒性等作为标准,将文本、用户问题等作为输入)。但是,如果提供了真实类别标签,那么评估目标就会转变为:根据真实类别标签,对分类/标记链进行评分(例如,使用精确率、召回率等指标)。
如果提供了真实参考标签,通常可以直接定义一个自定义启发式评估器,将真实标签与链的输出进行比较。不过,随着 LLM 的兴起,越来越多的场景会直接使用 LLM-as-judge,根据指定标准对输入进行分类/标记,而不依赖真实参考标签。
当使用 LLM-as-judge 和无参考提示时,在线或离线评估都是可行的。尤其是当用户希望为应用输入添加标签或进行分类时(例如,检测毒性等),这种方法非常适合在线评估。
Connect these docs to Claude, VSCode, and more via MCP for real-time answers.