

- 运行的实际输出不正确,而你更希望描述正确答案应是什么样,而不是手动编写一个正确答案。
- 你希望用通俗易懂的英语记录验收标准,而无需离开审阅流程。
添加断言
- 在 LangSmith UI 中,转到左侧边栏的 Annotation Queues。打开一个单次运行队列并选择一个运行。
- 在侧面板中找到 Feedback 下方的 Assertions 部分。
- 点击 + Add 创建一行断言。
-
输入一个用于概括声明的 key(例如
must_cite_source、must_not_invent_url),以及用一句话描述该声明的 comment。 key 的格式不受限制。must_/must_not_前缀只是命名约定;LangSmith 不会对它们进行特殊处理。 -
对于需要记录的每项标准,重复步骤 3 和 4。
运行编辑器会在断言侧面板旁显示运行的输入和输出。添加至少一条断言后,运行编辑器的 Outputs 面板会从运行的实际输出切换为你所添加断言的只读预览。该预览就是保存到数据集中的内容。运行的实际输出不会被保存,因为断言描述的是正确答案应包含的内容,而不是本次运行产生的内容。
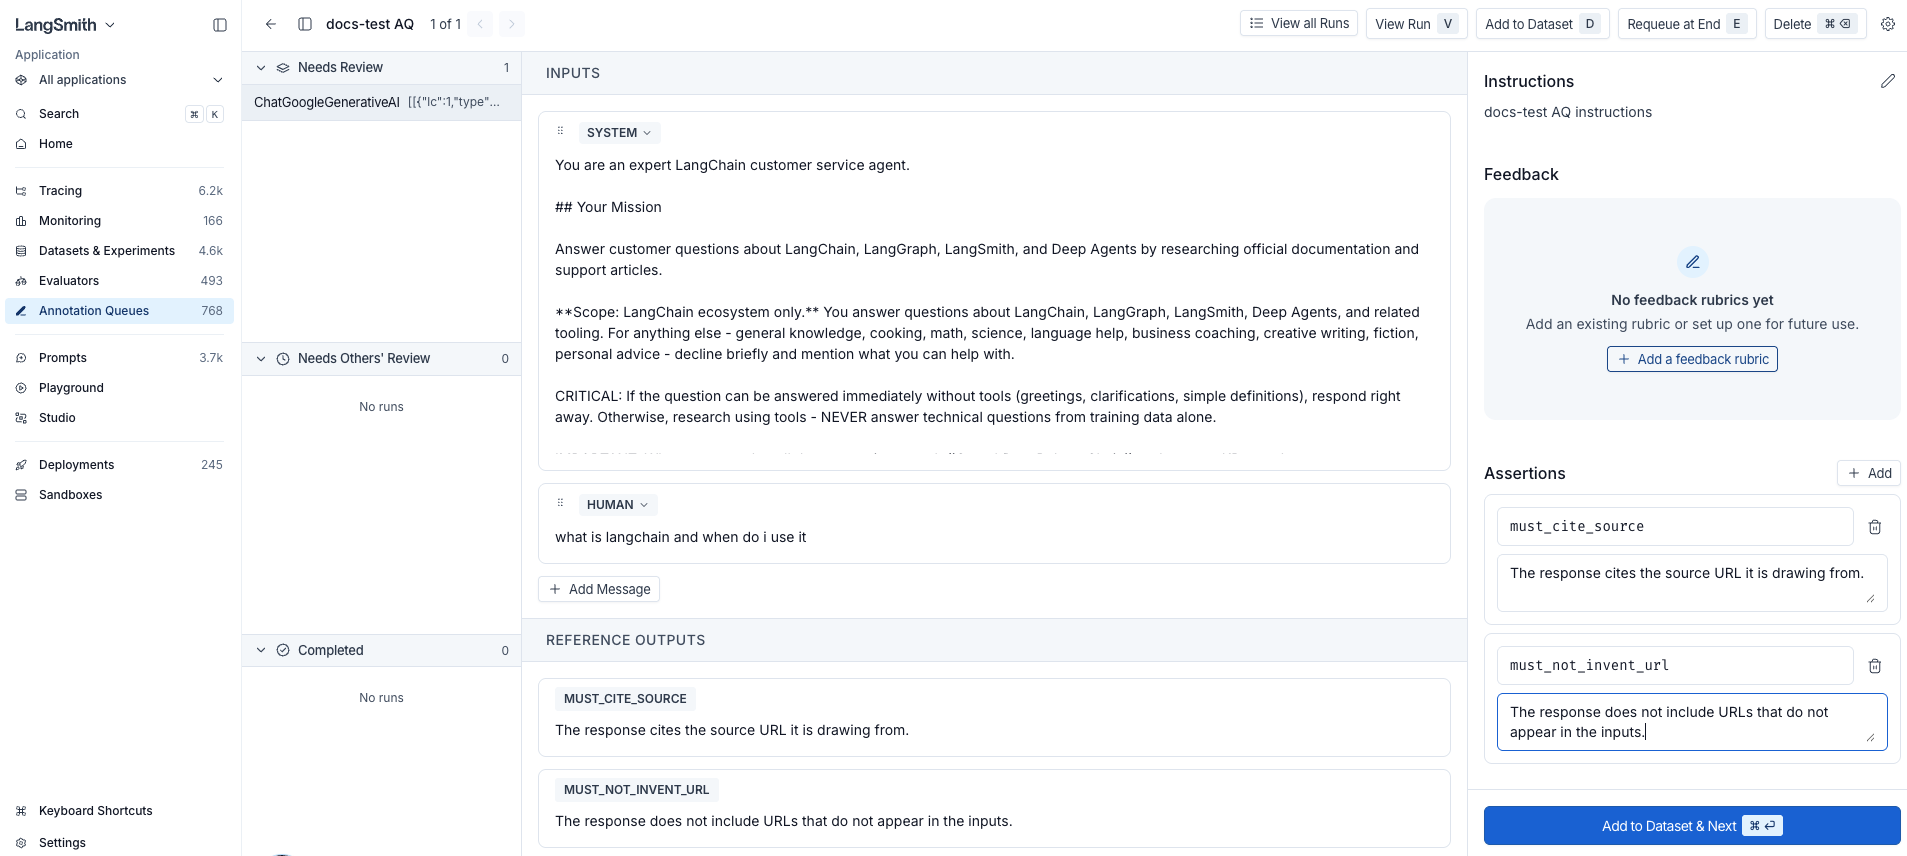
 你可以随时继续编辑运行的 Inputs,例如在保存示例前优化提示词。只要仍有断言,Outputs 面板就会保持锁定,并显示断言预览。
- 点击侧面板底部的 Add to Dataset & Next(键盘快捷键:macOS 使用 ⌘ Enter,其他系统使用 Ctrl Enter)。LangSmith 会将当前运行添加到队列的默认数据集中;如果未配置默认数据集,则会提示你选择一个。随后,队列会将你带到下一个运行。
outputs 字段以 JSON 形式存储。例如:
inputs 字段会存储运行的输入;如果你修改过输入,则存储修改后的版本。有关已保存示例的完整结构,请参阅示例数据格式。
根据断言进行评估
编写一个离线评估器,从reference_outputs["assertions"] 中读取已保存的断言,并针对每条断言返回一个反馈分数。最小结构如下:
- LLM-as-a-judge:针对每条断言,向模型提供应用程序的输出和断言的
comment,让模型返回一个分数。当声明具有主观性或难以通过机械方式验证时,这种方式最为适合。 - 基于代码的检查:针对每条断言,根据断言的
key执行确定性检查,例如正则表达式匹配、架构验证或子字符串匹配。当声明具有明确且可机械验证的答案时,这种方式最为适合。 - 部分得分:返回数值分数(例如 0.0 到 1.0 之间的分数),而不是布尔值,以便按程度评分,并为满足部分而非全部声明的输出提供“部分得分”。
Connect these docs to Claude, VSCode, and more via MCP for real-time answers.