

- 完全隐藏输入和输出,使用环境变量或 Client 配置。
- 隐藏元数据以移除或转换运行元数据。
- 应用基于规则的掩码,使用正则表达式模式或匿名化库来选择性地脱敏敏感信息。
- 从追踪中脱敏密钥,使用 SDK 匿名化器,其中包含用于 API 密钥、令牌和凭据的即用型正则表达式模式。
- 为单个函数处理输入和输出,支持函数级别的自定义。
- 使用第三方匿名化器,例如 Microsoft Presidio 和 Amazon Comprehend,进行高级个人身份信息 (PII) 检测。
- 批量处理运行操作,一次对多个运行应用成本较高的掩码逻辑,从而减少每次运行的开销。LangSmith 在后台线程中处理这些运行,不会阻塞您的应用程序。
- 按请求脱敏输入和输出,使用
tracing_context仅对特定调用(例如,基于租户或功能标志)掩码数据,同时保持其他追踪不变。
如果您的合规性或隐私要求强制规定某些操作绝不应被追踪(例如,具有零保留策略的客户端),请考虑使用条件追踪来选择性地禁用特定请求的追踪,而不是掩码数据。
隐藏输入和输出
如果您想完全隐藏追踪的输入和输出,可以在运行应用程序时设置以下环境变量:hide_inputs 和 hide_outputs 参数来实现(在 TypeScript 中为 hideInputs 和 hideOutputs)。
以下示例为 hide_inputs 和 hide_outputs 返回一个空对象,但您可以根据需要进行自定义:
隐藏元数据
hide_metadata 参数允许您在使用 LangSmith Python SDK 进行追踪时,控制运行元数据是否被隐藏或转换。元数据在创建运行时通过 extra 参数传递(例如,extra={"metadata": {...}})。hide_metadata 对于移除敏感信息、遵守隐私要求或减少发送到 LangSmith 的数据量很有用。您可以通过两种方式配置元数据隐藏:
-
使用 SDK:
-
使用环境变量:
hide_metadata 参数接受三种类型的值:
True:完全移除所有元数据(发送空字典)。False或None:保持元数据原样(默认行为)。Callable:一个自定义函数,用于转换元数据字典。
extra 参数的 metadata 字段,包括通过 @traceable 装饰器或 LangChain 集成创建的运行。
隐藏所有元数据
设置hide_metadata=True 可以完全移除发送到 LangSmith 的运行中的所有元数据:
自定义转换
使用可调用函数可以在数据发送到 LangSmith 之前,选择性地过滤、脱敏或修改元数据:基于规则的输入和输出掩码
此功能在以下 LangSmith SDK 版本中可用:
- Python:0.1.81 及以上版本
- TypeScript:0.1.33 及以上版本
create_anonymizer / createAnonymizer 函数,并在实例化 Client 时传入新创建的匿名化器。匿名化器可以从正则表达式模式列表和替换值构建,也可以从一个接受并返回字符串值的函数构建。
如果设置了 LANGSMITH_HIDE_INPUTS = true,则匿名化器将对输入跳过处理。同样,如果设置了 LANGSMITH_HIDE_OUTPUTS = true,则对输出也跳过。
但是,如果输入或输出需要发送给 Client,那么 anonymizer 方法将优先于 hide_inputs 和 hide_outputs 中找到的函数。默认情况下,create_anonymizer 最多只查看 10 层嵌套深度,这可以通过 max_depth 参数进行配置。
提升
anonymizer API 的性能已在我们的路线图中!如果您遇到性能问题,请通过 support.langchain.com 联系支持。 旧版本的 LangSmith SDK 可以使用
hide_inputs 和 hide_outputs 参数来达到相同的效果。您也可以使用这些参数更高效地处理输入和输出。
为单个函数处理输入和输出
process_outputs 参数在 LangSmith SDK 版本 0.1.98 及以上版本中可用于 Python。@traceable 装饰器的 process_inputs 和 process_outputs 参数提供了函数级别的处理。
这些参数接受函数,允许您在特定函数的输入和输出被记录到 LangSmith 之前对其进行转换。这对于减小负载大小、移除敏感信息或自定义特定函数的对象序列化方式及其在 LangSmith 中的表示非常有用。
以下是使用 process_inputs 和 process_outputs 的示例:
process_inputs 创建一个包含处理后的输入数据的新字典,而 process_outputs 在记录到 LangSmith 之前将输出转换为特定格式。
对于异步函数,用法类似:
hide_inputs 和 hide_outputs)。
示例
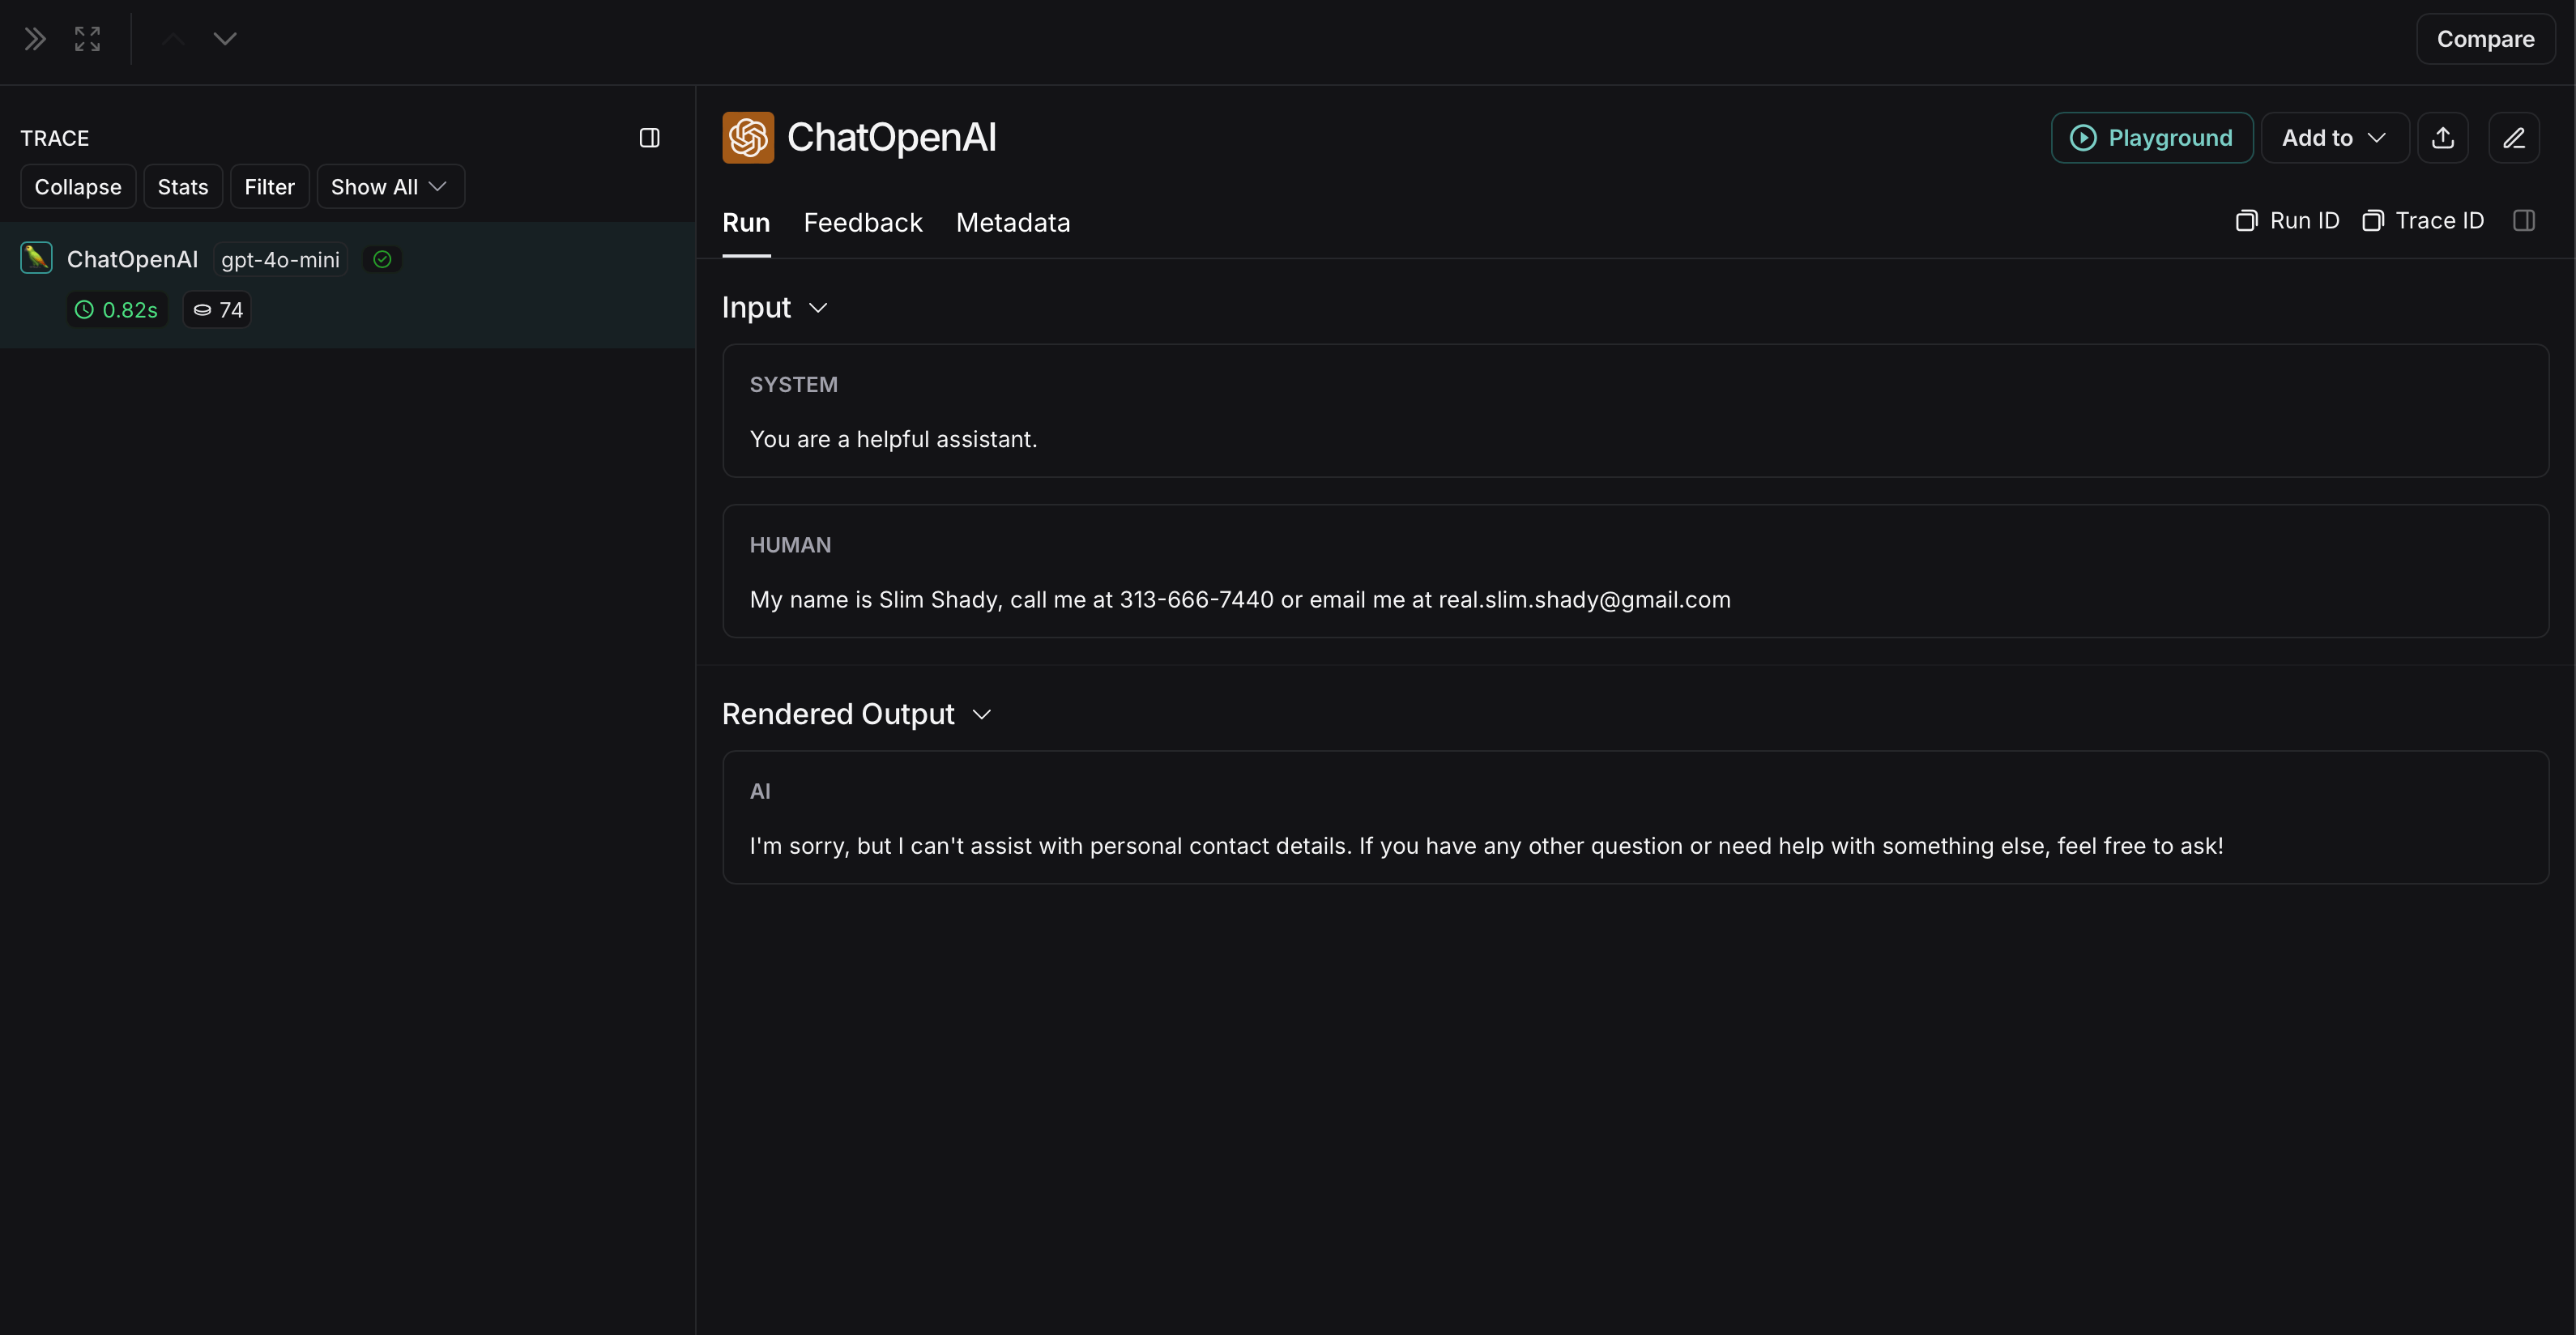
您可以将基于规则的掩码与各种匿名化器结合使用,以清除输入和输出中的敏感信息。以下示例将涵盖使用正则表达式、Microsoft Presidio 和 Amazon Comprehend 的方法。正则表达式
下面的实现并非详尽无遗,可能遗漏某些格式或边缘情况。在生产环境中使用前,请彻底测试任何实现。
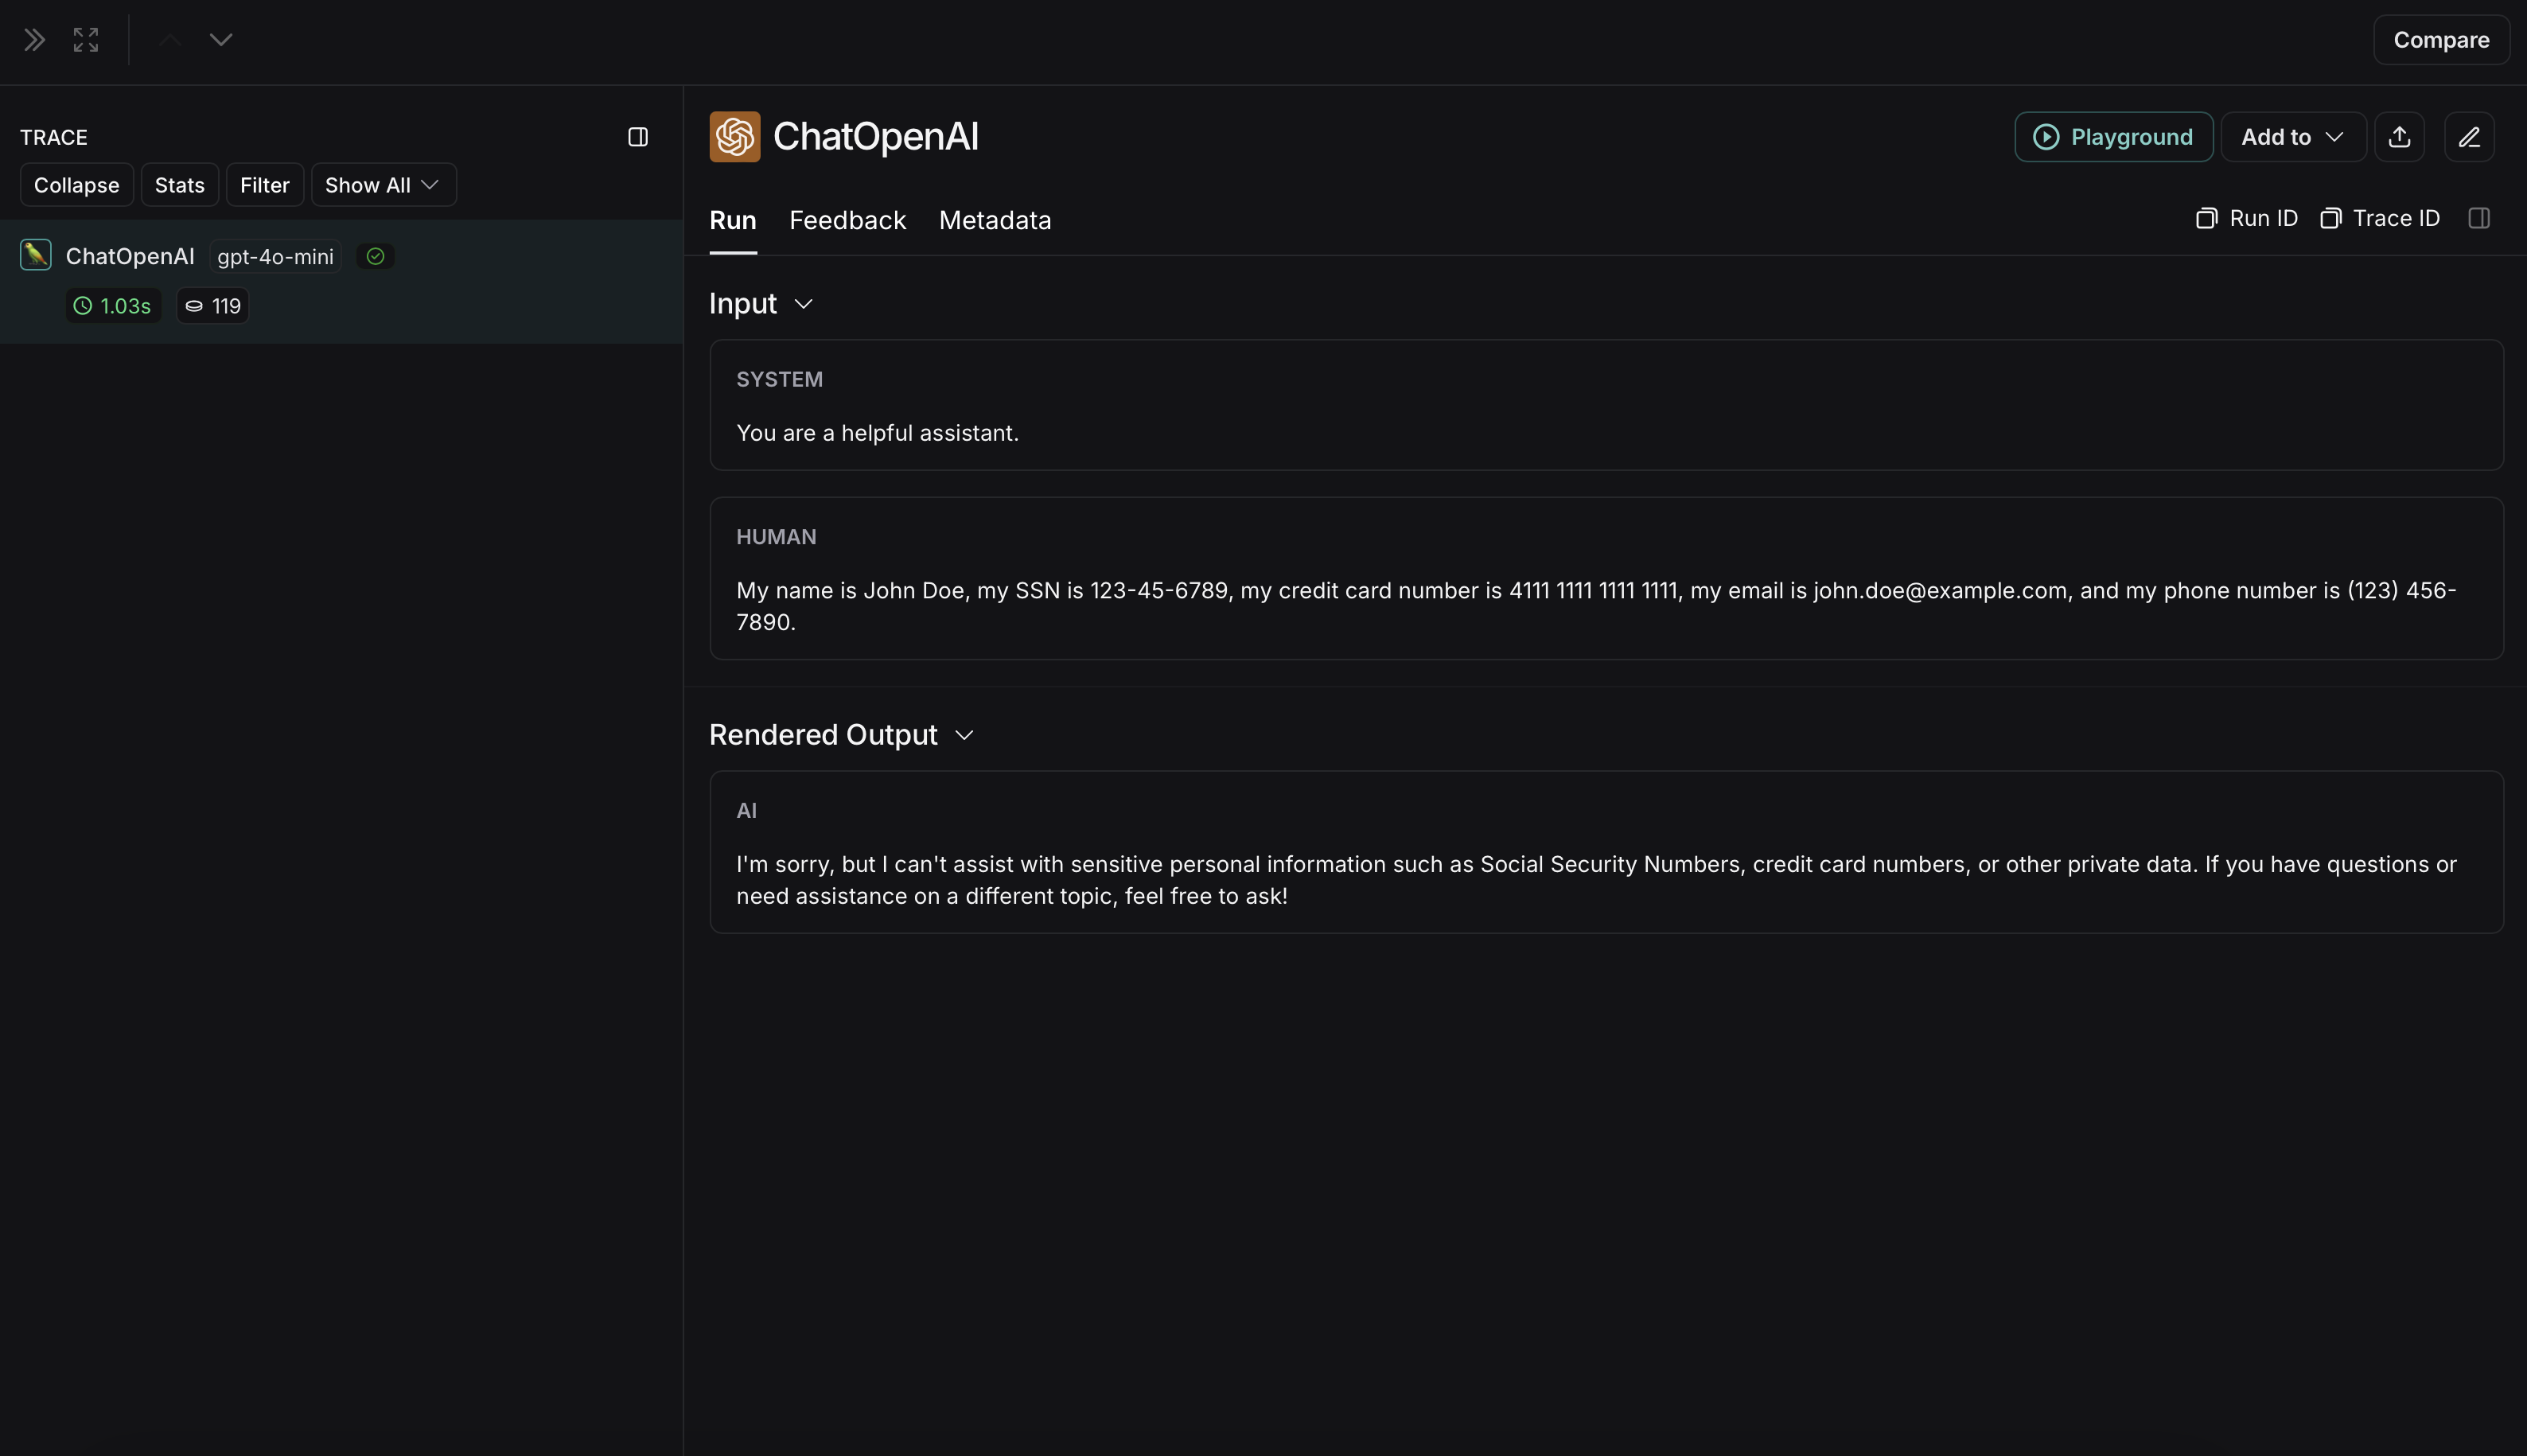
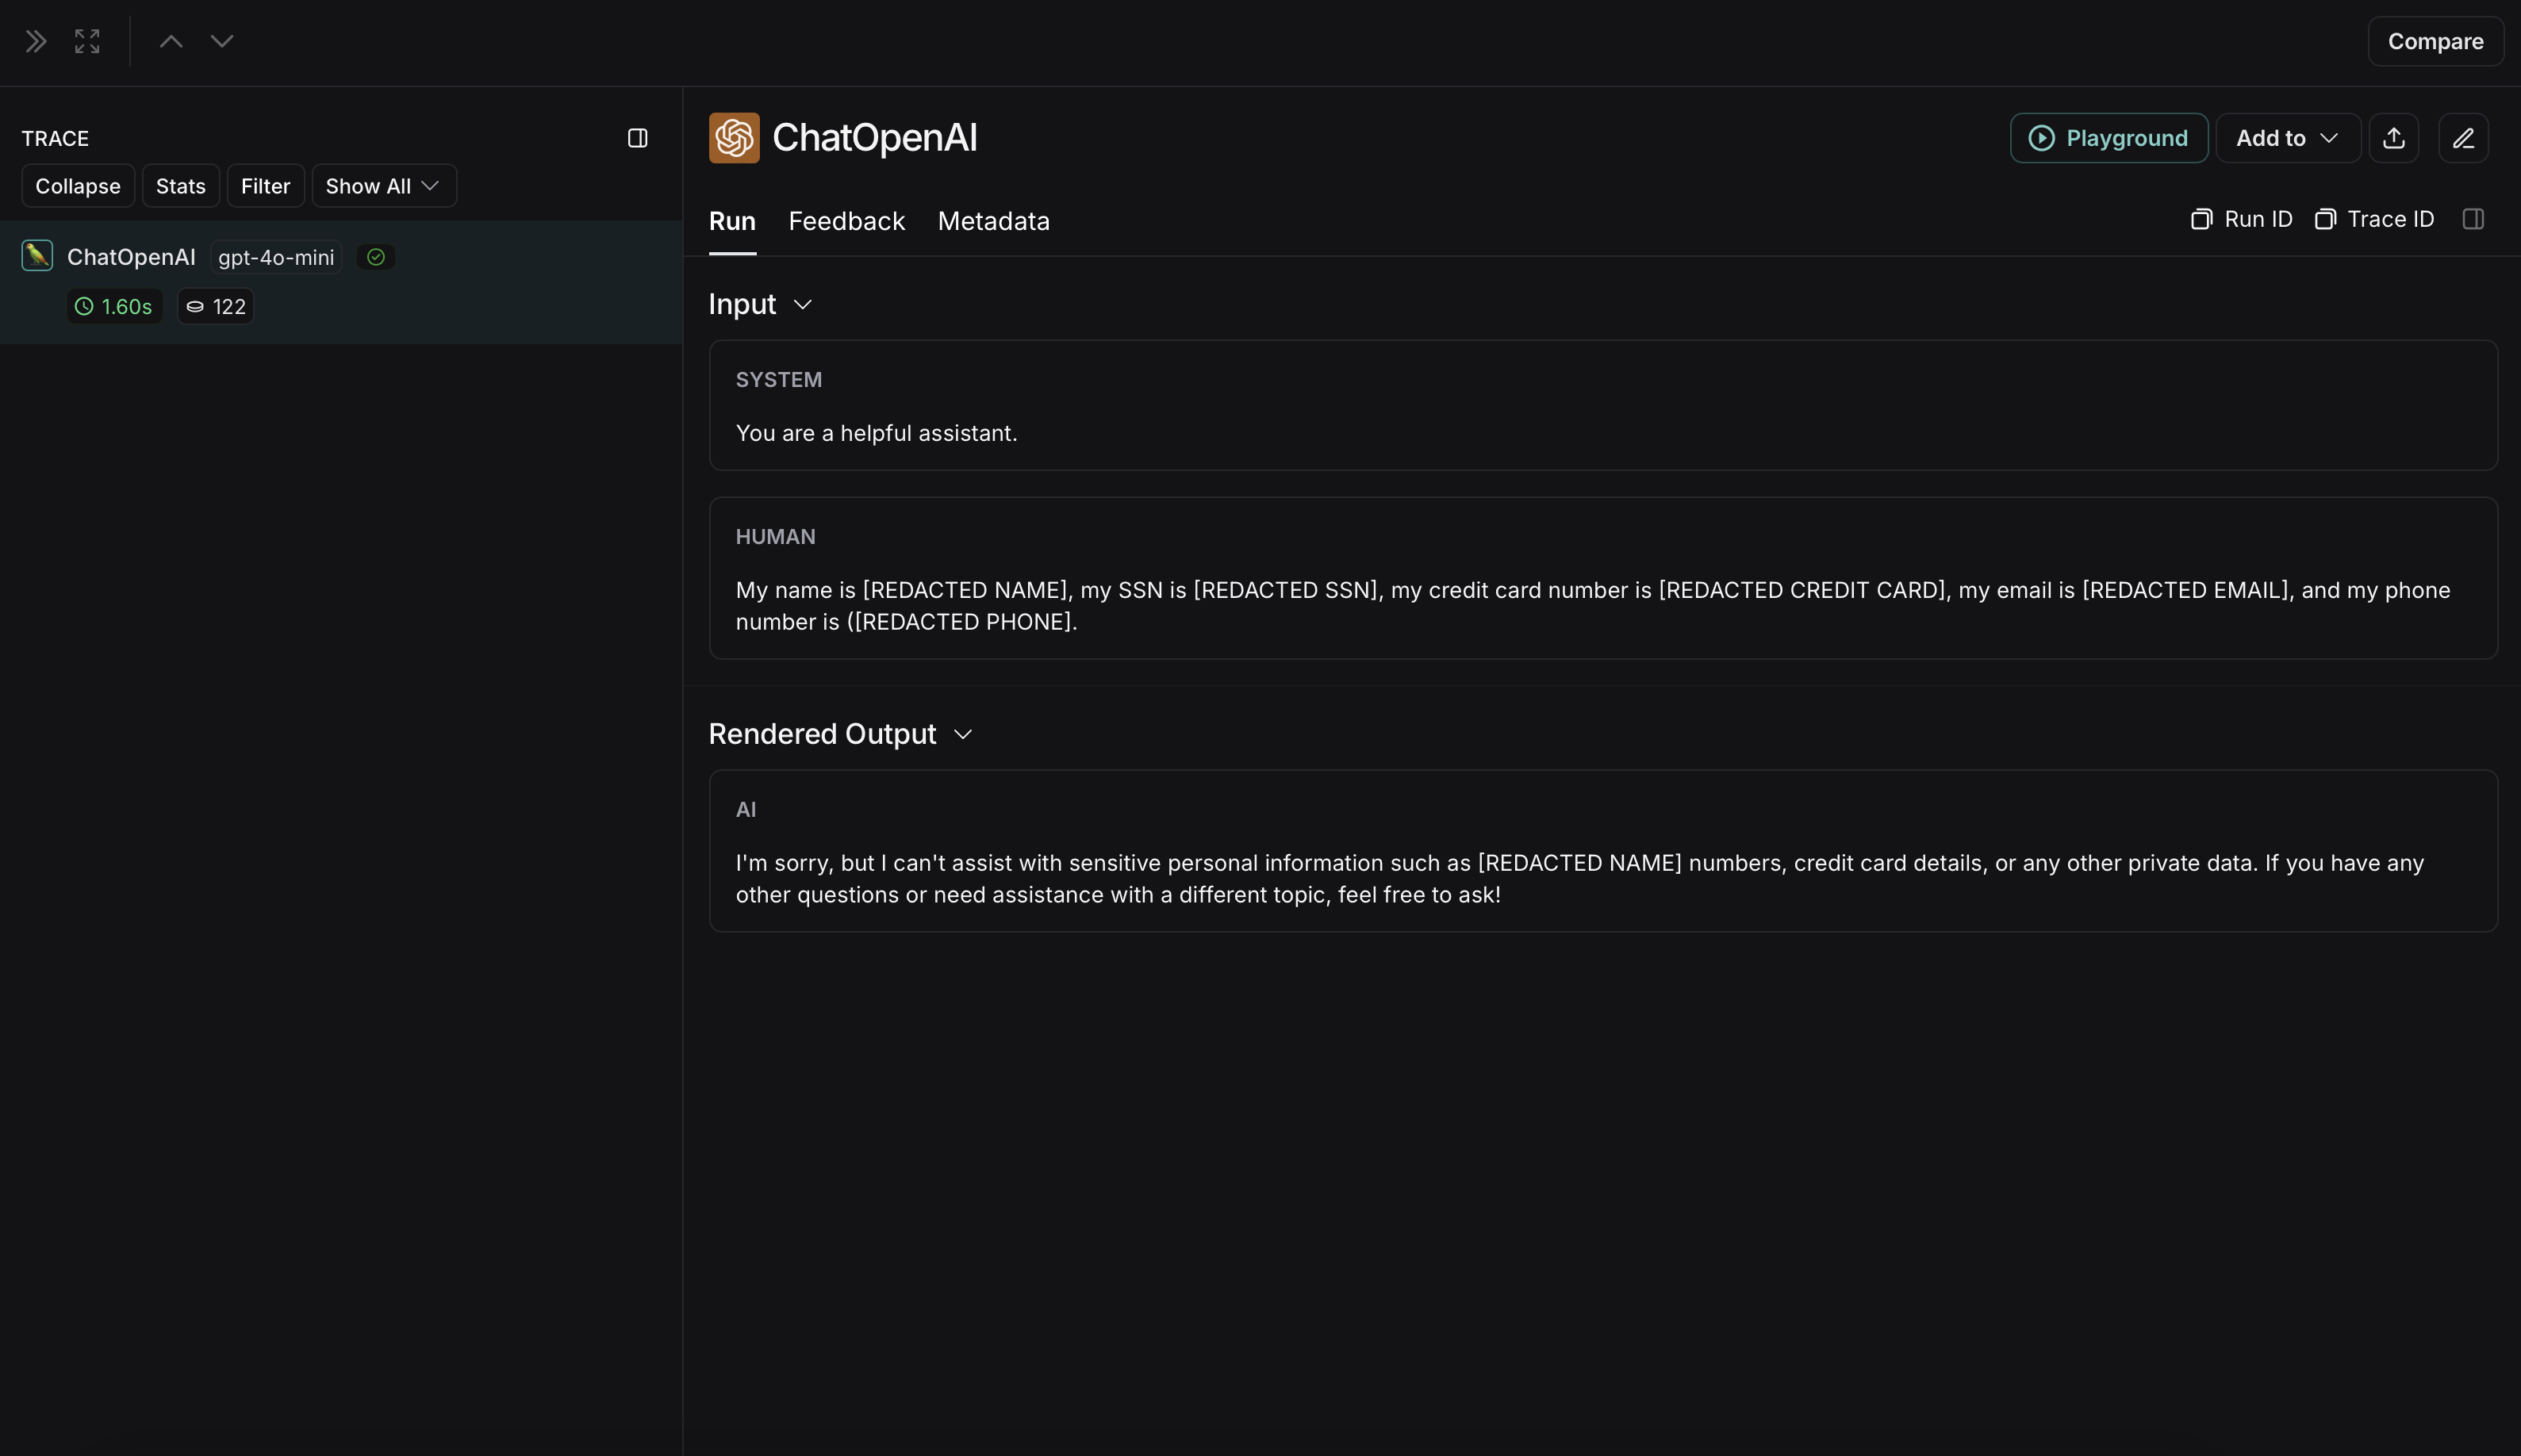 非匿名化运行在 LangSmith 中将如下所示:
Microsoft Presidio
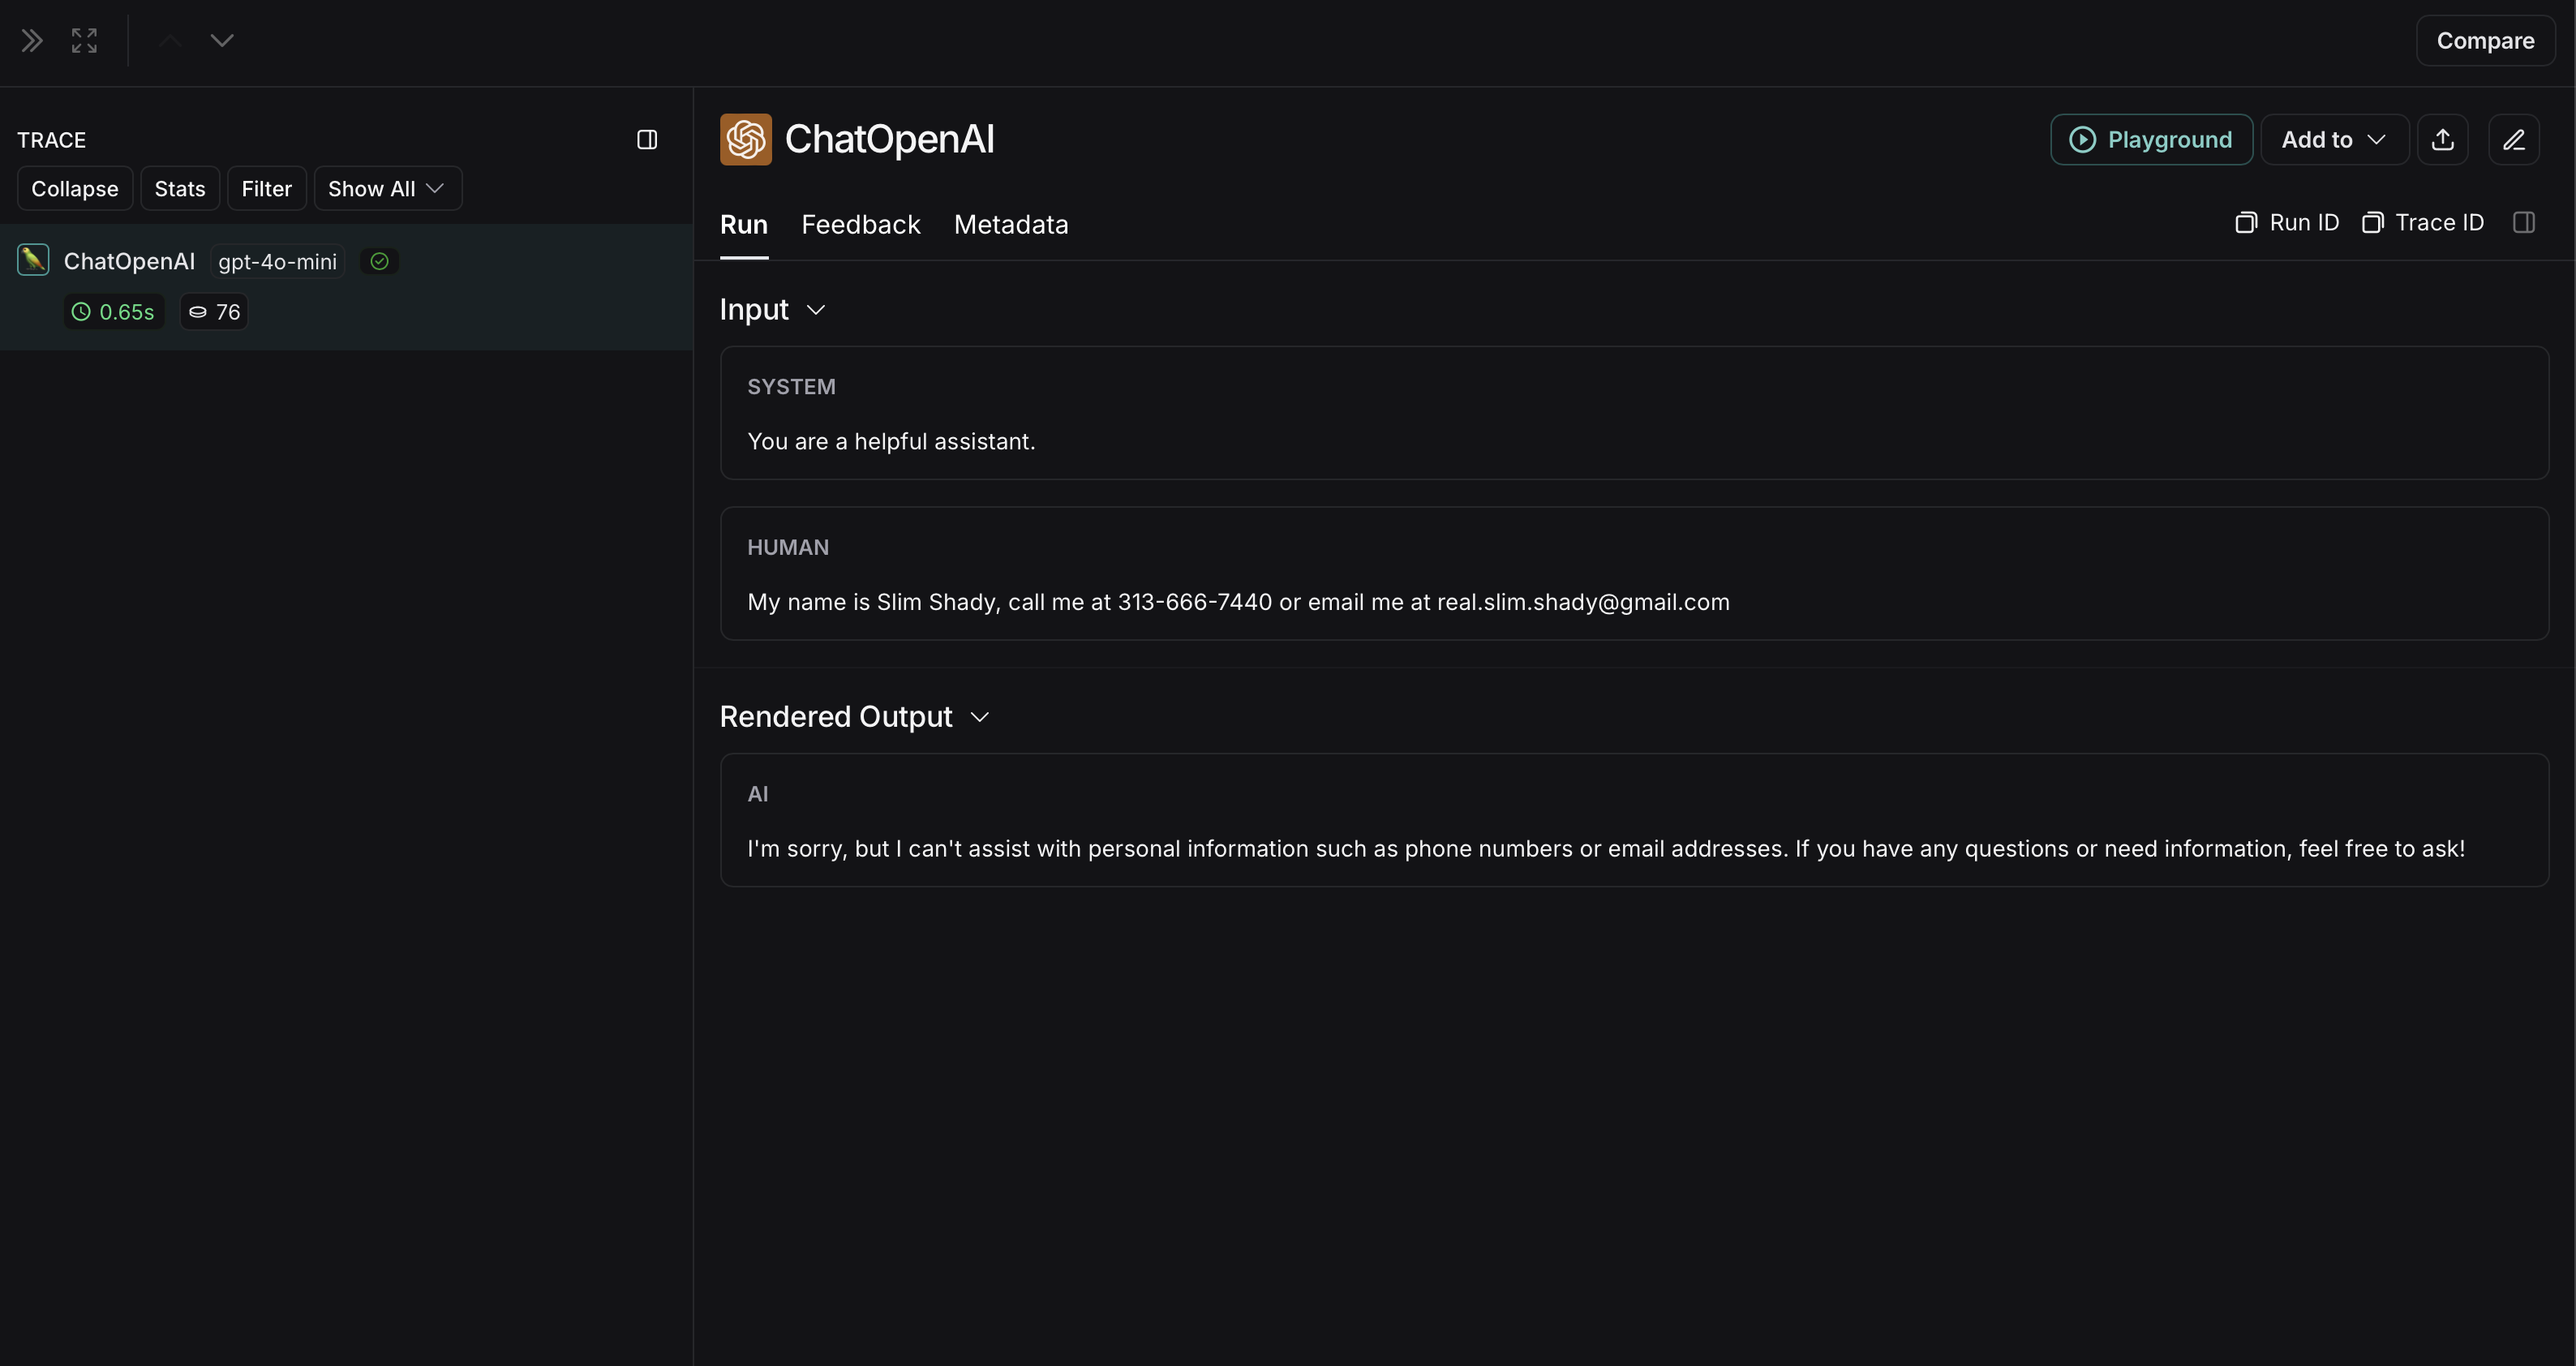
下面的实现提供了一个如何匿名化用户与 LLM 交换的消息中的敏感信息的通用示例。它并非详尽无遗,也未涵盖所有情况。在生产环境中使用前,请彻底测试任何实现。
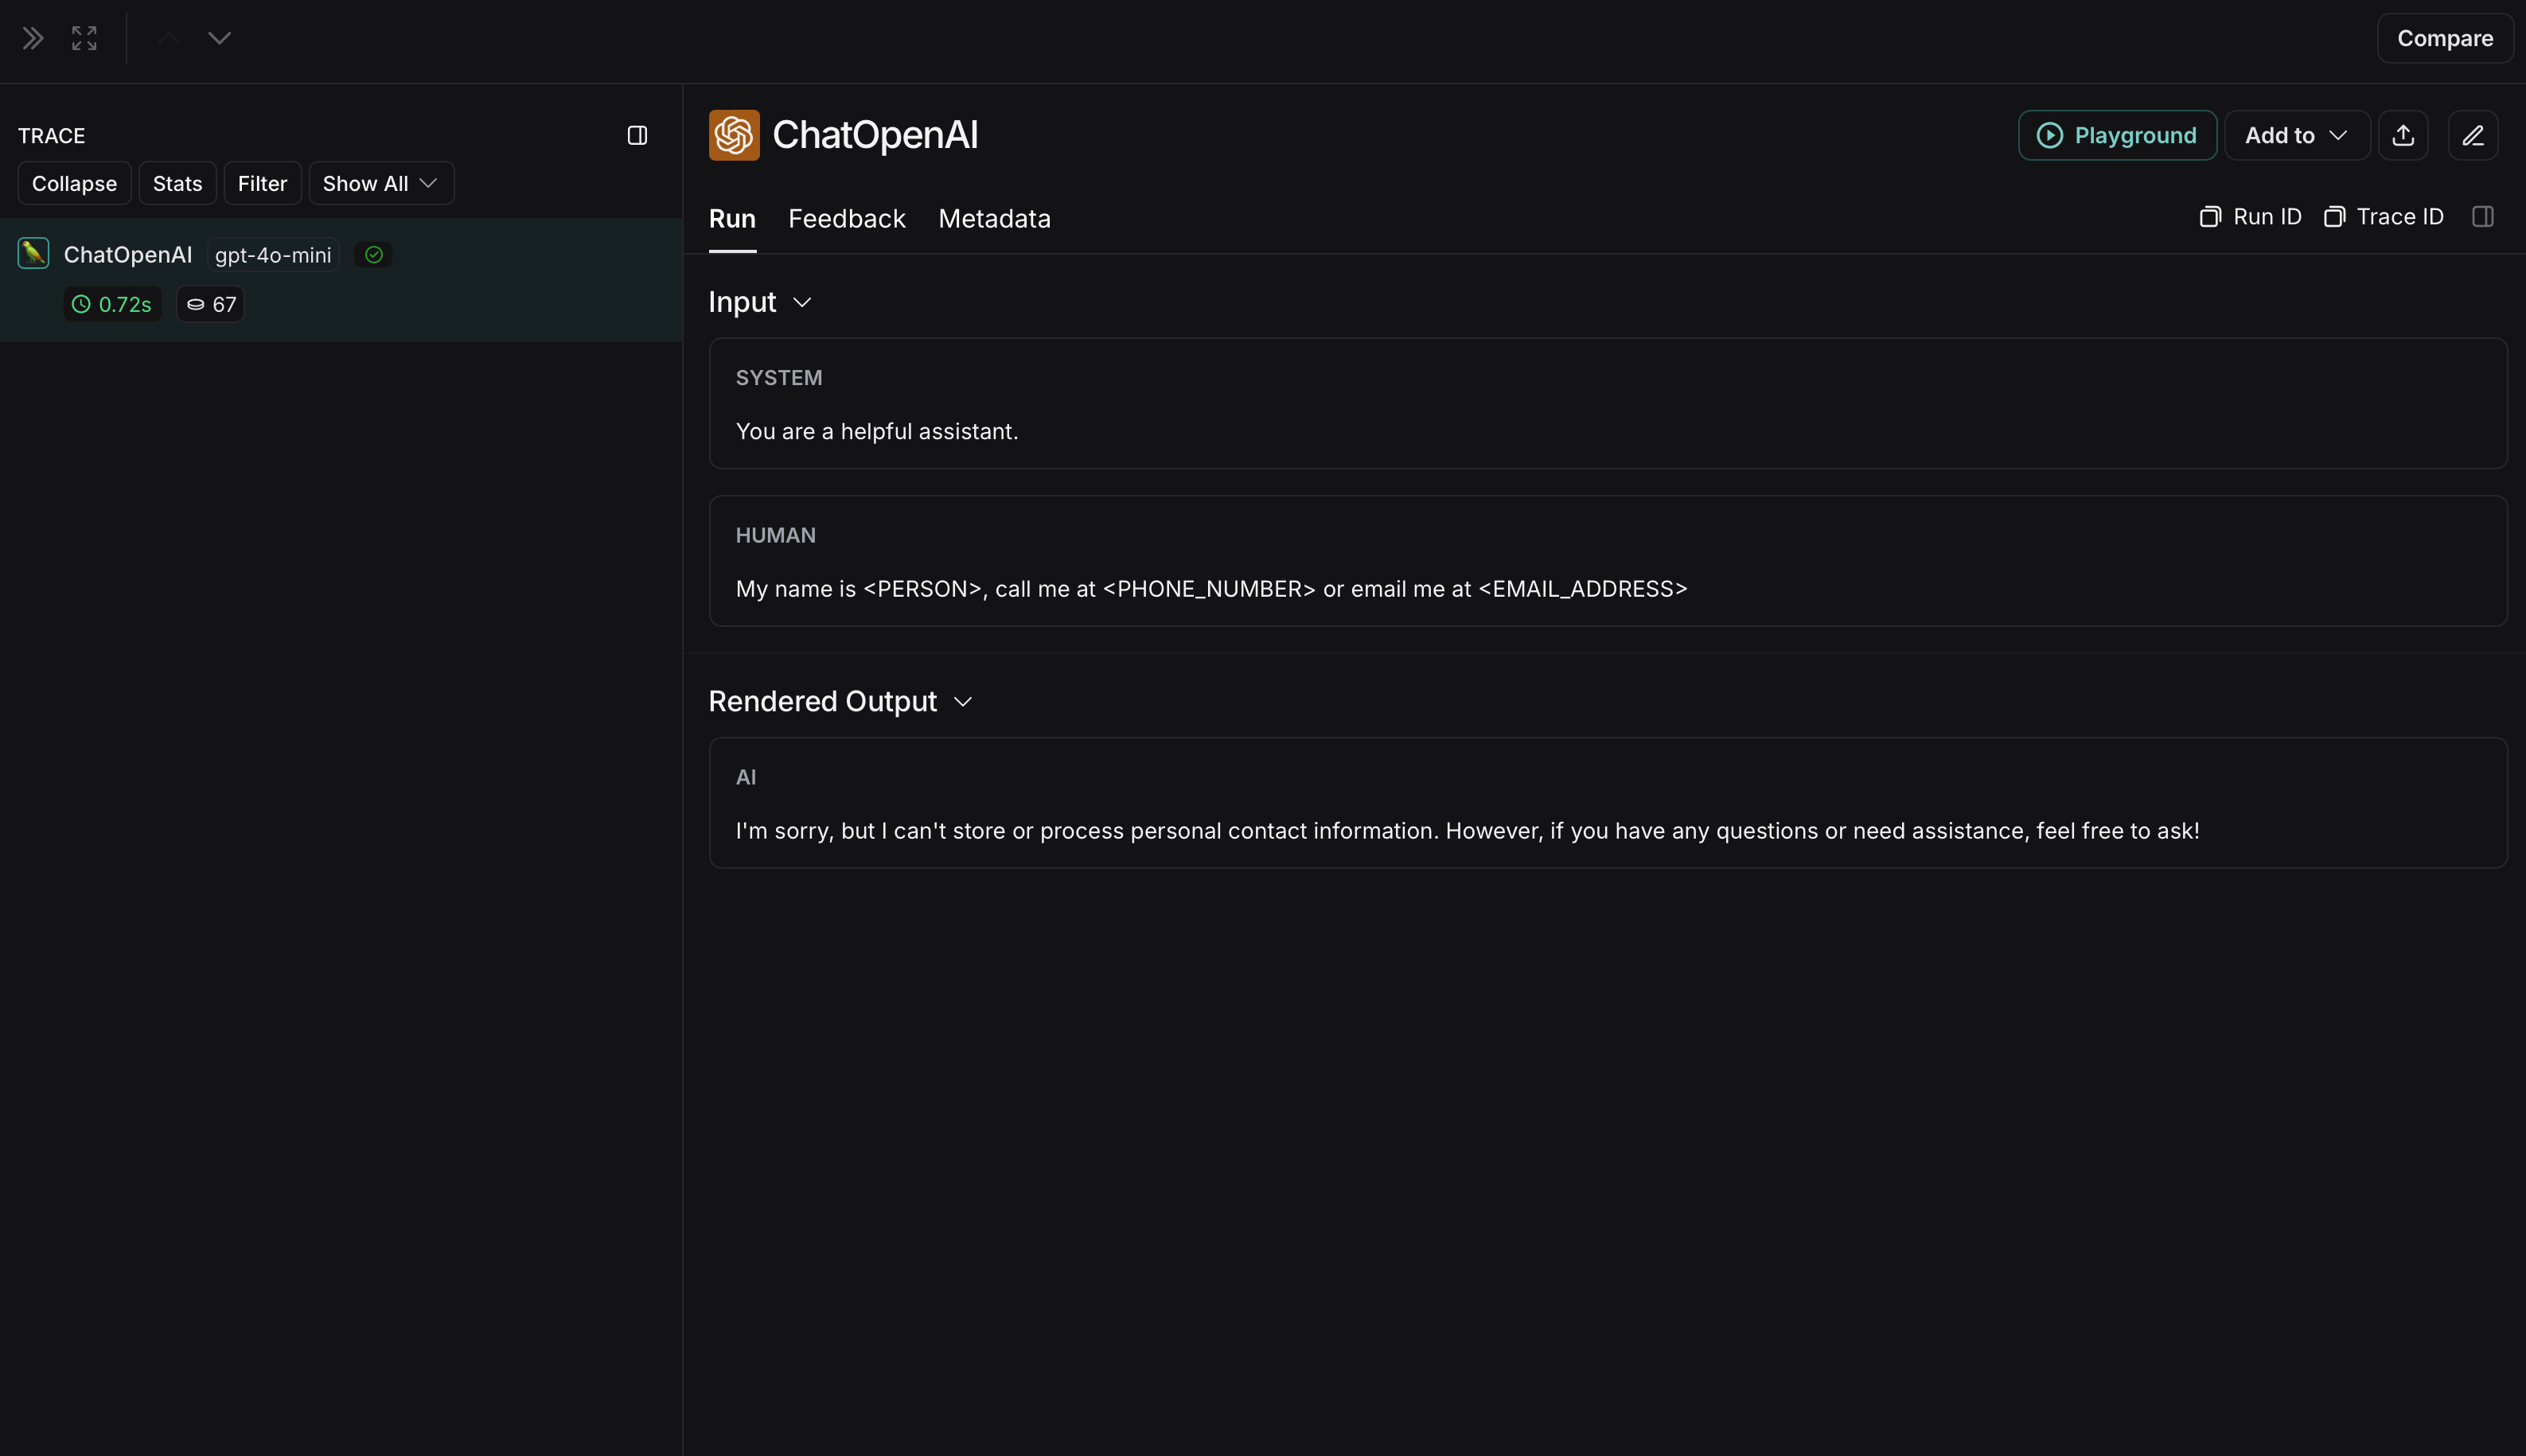 非匿名化运行在 LangSmith 中将如下所示:
Amazon Comprehend
下面的实现提供了一个如何匿名化用户与 LLM 交换的消息中的敏感信息的通用示例。它并非详尽无遗,也未涵盖所有情况。在生产环境中使用前,请彻底测试任何实现。
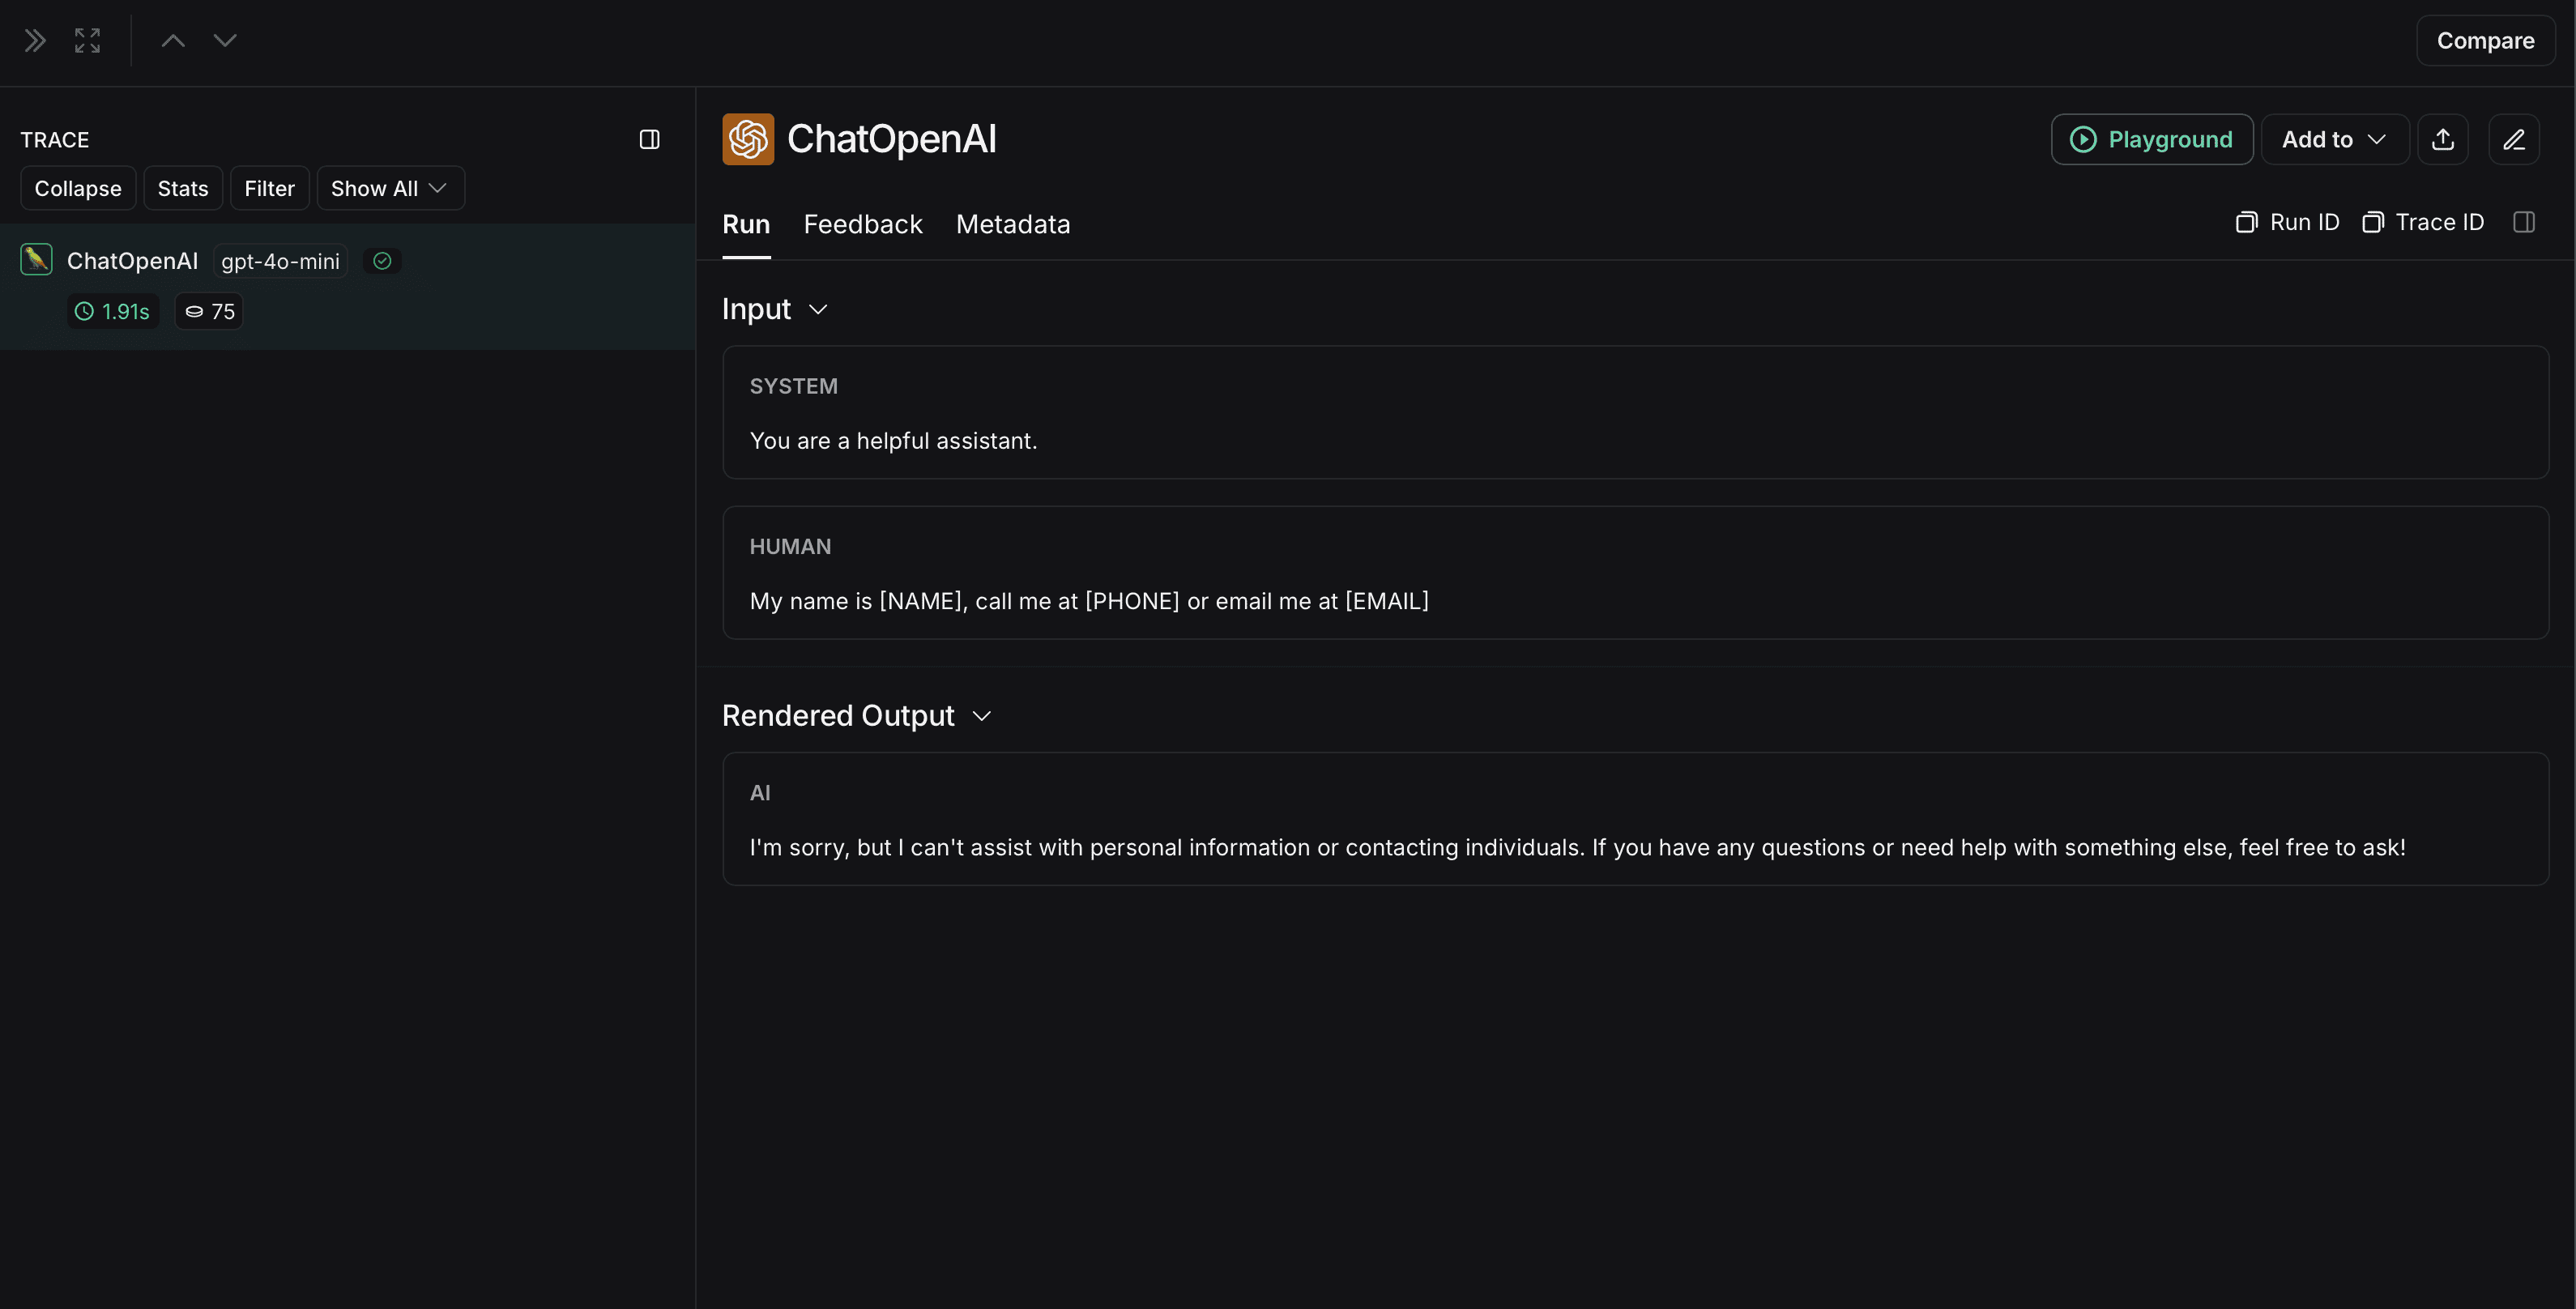 非匿名化运行在 LangSmith 中将如下所示:
高吞吐量掩码的批处理
process_buffered_run_ops 仅在 Python SDK 中可用。process_buffered_run_ops 允许您在原始运行字典序列化并发送到 API 之前拦截一批原始运行字典,从而可以将成本分摊到多个运行上。LangSmith 在后台线程中处理这些运行,不会阻塞您的应用程序。
LangSmith 将运行保存在内存缓冲区中,并在以下任一情况发生时将它们作为一批进行刷新:
- 累积了
run_ops_buffer_size个运行操作,或者 - 自上次添加运行以来已经过去了
run_ops_buffer_timeout_ms毫秒(默认值:5000 毫秒)。
ValueError。
run_ops_buffer_size 计算的是单个运行操作,而不是唯一的运行。每个被追踪的调用通常产生两个操作:一个创建(当运行开始时)和一个更新(当它以输出结束时)。请相应地设置缓冲区大小。例如,run_ops_buffer_size=1000 将缓冲大约 500 个被追踪的调用。因此,同一个运行 ID 可能会出现在同一批次中两次:一次带有输入,一次带有输出。inputs,在运行开始时发送),要么是一个更新操作(带有 outputs,在运行结束时发送)。以下是单个被追踪调用的典型操作对:
batch_detect_entities 端点,该端点每次调用最多接受 25 个文本。使用逐运行方法(hide_inputs)时,每个运行需要进行一次 API 调用。而在这里,首先收集整个缓冲区中的所有消息文本,然后按 25 个一组发送给 Comprehend,这在高吞吐量下显著减少了 API 调用次数。
process_buffered_run_ops 和 run_ops_buffer_size 必须始终一起设置 — 只提供其中一个会引发 ValueError。
Connect these docs to Claude, VSCode, and more via MCP for real-time answers.