

设置
安装langgraph:
定义和更新状态
这里我们将展示如何在 LangGraph 中定义和更新状态。我们将演示:定义状态
LangGraph 中的状态可以是TypedDict、Pydantic 模型或数据类。下面我们将使用 TypedDict。有关使用 Pydantic 的详情,请参阅使用 Pydantic 模型定义图状态。
默认情况下,图将具有相同的输入和输出架构,而状态决定了该架构。有关如何定义不同的输入和输出架构,请参阅定义输入和输出架构。
让我们考虑一个使用消息的简单例子。这代表了许多 LLM 应用程序中一种通用的状态表示方式。更多详情请参阅我们的概念页面。
更新状态
让我们构建一个包含单个节点的示例图。我们的节点只是一个 Python 函数,它读取图的状态并对其进行更新。此函数的第一个参数始终是状态:StateGraph 来定义一个在此状态上操作的图。然后使用 add_node 来填充我们的图。
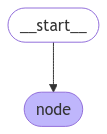 在这种情况下,我们的图只执行一个节点。让我们进行一次简单的调用:
- 我们通过更新状态的单个键来启动调用。
- 我们在调用结果中接收整个状态。
使用归约器处理状态更新
状态中的每个键都可以拥有自己独立的归约器函数,该函数控制来自节点的更新如何被应用。如果没有显式指定归约器函数,则假定对该键的所有更新都应覆盖它。 对于TypedDict 状态架构,我们可以通过使用归约器函数注释状态的相应字段来定义归约器。
在前面的例子中,我们的节点通过向 "messages" 键追加一条消息来更新状态。下面我们为该键添加一个归约器,使得更新会自动追加:
MessagesState
在实践中,更新消息列表还有其他注意事项: LangGraph 包含一个内置的归约器[add_messages](https://reference.langchain.com/python/langgraph/graph/message/add_messages) 来处理这些考虑:
MessagesState,因此我们可以这样写:
使用 Overwrite 绕过归约器
在某些情况下,你可能希望绕过归约器并直接覆盖状态值。LangGraph 提供了 Overwrite 类型用于此目的。当一个节点返回一个用 Overwrite 包装的值时,归约器被绕过,通道被直接设置为该值。
当你希望重置或替换累积的状态,而不是将其与现有值合并时,这很有用。
"__overwrite__" 的 JSON 格式:
定义输入和输出架构
默认情况下,StateGraph 使用单一架构操作,并且所有节点都预期使用该架构进行通信。然而,也可以为图定义不同的输入和输出架构。
当指定了不同的架构时,内部仍会使用一个架构在节点之间通信。输入架构确保提供的输入符合预期的结构,而输出架构则过滤内部数据,仅根据定义的输出架构返回相关信息。
下面,我们将看到如何定义不同的输入和输出架构。
invoke 的输出只包含输出架构。
在节点之间传递私有状态
在某些情况下,你可能希望节点交换对中间逻辑至关重要但不需要成为图主架构一部分的信息。这些私有数据与图的总体输入/输出无关,并且只应在特定节点之间共享。 下面,我们将创建一个由三个节点(node_1、node_2 和 node_3)组成的顺序图示例,其中私有数据在前两个步骤(node_1 和 node_2)之间传递,而第三步(node_3)只能访问公共的整体状态。使用 Pydantic 模型定义图状态
StateGraph 在初始化时接受一个[state_schema](https://reference.langchain.com/python/langchain/middleware/#langchain.agents.middleware.AgentMiddleware.state_schema) 参数,该参数指定图中节点可以访问和更新的状态的“形状”。
在我们的示例中,我们通常使用 Python 原生的 TypedDict 或 dataclass 作为 state_schema,但 [state_schema](https://reference.langchain.com/python/langchain/middleware/#langchain.agents.middleware.AgentMiddleware.state_schema) 可以是任何类型。
这里,我们将看到如何将 Pydantic BaseModel 用作 [state_schema](https://reference.langchain.com/python/langchain/middleware/#langchain.agents.middleware.AgentMiddleware.state_schema),以便对输入进行运行时验证。
已知限制
- 目前,图的输出不会是 Pydantic 模型的实例。
- 运行时验证仅发生在图的第一个节点的输入上,不会发生在后续节点或输出上。
- Pydantic 的验证错误跟踪不会显示错误发生在哪个节点。
- Pydantic 的递归验证可能较慢。对于性能敏感的应用程序,你可能需要考虑改用
dataclass。
序列化行为
序列化行为
当使用 Pydantic 模型作为状态架构时,了解序列化的工作方式非常重要,尤其是在:
- 将 Pydantic 对象作为输入传递时
- 从图接收输出时
- 处理嵌套的 Pydantic 模型时
运行时类型强制转换
运行时类型强制转换
Pydantic 会对某些数据类型执行运行时类型强制转换。这可能是有帮助的,但如果你不了解它,也可能导致意外行为。
处理消息模型
处理消息模型
在状态架构中使用 LangChain 消息类型时,序列化有一些重要注意事项。当通过网络传输消息对象时,你应该使用
AnyMessage(而不是 BaseMessage)以确保正确的序列化/反序列化。添加运行时配置
有时你希望在调用图时能够对其进行配置。例如,你可能希望能够在运行时指定使用哪个 LLM 或系统提示符,而不会用这些参数污染图状态。 要添加运行时配置:- 为你的配置指定一个架构
- 将配置添加到节点或条件边的函数签名中
- 将配置传递给图。
扩展示例:在运行时指定 LLM
扩展示例:在运行时指定 LLM
下面我们演示一个实际示例,我们在运行时配置要使用的 LLM。我们将使用 OpenAI 和 Anthropic 的模型。
扩展示例:在运行时指定模型和系统消息
扩展示例:在运行时指定模型和系统消息
下面我们演示一个实际示例,我们配置两个参数:运行时要使用的 LLM 和系统消息。
添加重试策略
在许多用例中,你可能希望你的节点具有自定义的重试策略,例如,如果你正在调用 API、查询数据库或调用 LLM 等。LangGraph 允许你为节点添加重试策略。 要配置重试策略,请将retry_policy 参数传递给 [add_node](https://reference.langchain.com/python/langgraph/graph/state/StateGraph/add_node)。retry_policy 参数接受一个 RetryPolicy 命名元组对象。下面我们使用默认参数实例化一个 RetryPolicy 对象,并将其与一个节点关联:
retry_on 参数使用 default_retry_on 函数,该函数会对除以下异常之外的任何异常进行重试:
ValueErrorTypeErrorArithmeticErrorImportErrorLookupErrorNameErrorSyntaxErrorRuntimeErrorReferenceErrorStopIterationStopAsyncIterationOSError
requests 和 httpx)的异常,它仅对 5xx 状态码进行重试。
扩展示例:自定义重试策略
扩展示例:自定义重试策略
考虑一个从 SQL 数据库读取的示例。下面我们向节点传递两个不同的重试策略:
设置节点超时
使用add_node 的 timeout 参数来限制单个异步节点调用可以运行的时长。可以以秒为单位或作为 datetime.timedelta 提供超时时间。
timeout,LangGraph 在编译图时会抛出一个错误,因为同步 Python 执行无法在进程中被安全取消。
当节点超出其超时时间时,LangGraph 会抛出 NodeTimeoutError,它是 Python 内置 TimeoutError 的子类。如果节点有一个重试 TimeoutError 或 NodeTimeoutError 的 retry_policy,则超时的尝试会被重试。超时独立应用于每次尝试,因此每次重试时计时器都会重置。
超时的尝试不会提交其缓冲的写入。这可以防止状态更新或子任务调度在超时边界后泄漏。
配置节点超时
add_node 上的 timeout= 参数限制了单次异步节点尝试可以运行的时长。传递一个数字(秒)、一个 timedelta 或一个 TimeoutPolicy 以对运行超时空闲超时进行更精细的控制。当超过限制时,LangGraph 会抛出 NodeTimeoutError,并让重试策略决定是否重试。
每个节点的超时需要
langgraph>=1.2。runtime.heartbeat(),请参阅容错性。
处理节点错误
add_node 上的 error_handler= 参数注册一个在节点失败且所有重试用尽后运行的函数。该处理程序接收当前状态和一个带有失败上下文的类型化 NodeError,并且可以通过 Command 路由到恢复分支:
节点级错误处理程序需要
langgraph>=1.2。Command 路由,请参阅容错性。
设置图范围的节点默认值
需要
langgraph>=1.2。set_node_defaults 为图中的每个节点设置一次 retry_policy、timeout、cache_policy 或 error_handler,而不是在每次 add_node 调用中重复它们。每个节点的值始终优先,并且默认值在 StateGraph.compile 时应用:
retry_policy 和 timeout 默认值适用于每个节点,包括错误处理程序节点。cache_policy 和 error_handler 默认值仅适用于常规节点——处理程序不会捕获自己,并且缓存处理程序结果是不安全的。默认值不会被子图继承。
有关完整的优先级规则和适用性表,请参阅容错性。
在节点内部访问执行信息
你可以通过runtime.execution_info 访问执行标识和重试信息。这会显示线程、运行和检查点标识符以及重试状态,而无需直接从 config 读取。
访问线程和运行 ID
使用execution_info 在节点内部访问线程 ID、运行 ID 和其他标识字段:
根据重试状态调整行为
当节点具有重试策略时,使用execution_info 检查当前尝试次数,并在第一次尝试失败后切换到回退方案:
execution_info 也可在 Runtime 对象上使用——node_attempt 默认为 1,node_first_attempt_time 设置为节点开始执行的时间。
在节点内部访问服务器信息
当你的图在 LangGraph Server 上运行时,你可以通过runtime.server_info 访问服务器特定的元数据。这会显示助手 ID、图 ID 和已认证用户,而无需直接从配置元数据或可配置键中读取。
server_info 为 None。
需要
deepagents>=0.5.0(或 langgraph>=1.1.5)才能使用 runtime.execution_info 和 runtime.server_info。在节点内部访问排空状态
当请求了优雅关闭时,runtime.drain_requested 为 True。在节点内部读取此值,以在下一个超步边界之前跳过昂贵的工作:
需要
langgraph>=1.2。有关完整的 RunControl API,请参阅优雅关闭。添加节点缓存
节点缓存在你想要避免重复操作的情况下很有用,比如执行某些昂贵的操作时(无论是时间成本还是资源成本)。LangGraph 允许你为图中的节点添加个性化的缓存策略。 要配置缓存策略,请将cache_policy 参数传递给 add_node 函数。在以下示例中,一个 CachePolicy 对象被实例化,生存时间为 120 秒,并使用默认的 key_func 生成器。然后将其与一个节点关联:
cache 参数。下面的示例使用 InMemoryCache 设置一个具有内存缓存的图,但 SqliteCache 也可用。
创建步骤序列
前提条件
本指南假设你熟悉上面关于状态的部分。
- 如何构建一个顺序图
- 构建类似图的内置简写方式。
add_node 和 add_edge 方法:
.add_sequence:
为什么使用 LangGraph 将应用程序步骤拆分为序列?
为什么使用 LangGraph 将应用程序步骤拆分为序列?
LangGraph 可以轻松地为你的应用程序添加底层持久化层。
这允许在节点执行之间对状态进行检查点,因此你的 LangGraph 节点控制着:它们还决定执行步骤如何被流式传输,以及你的应用程序如何使用 Studio 进行可视化和调试。让我们演示一个端到端的示例。我们将创建一个三个步骤的序列:我们的节点只是读取图的状态并对其进行更新的 Python 函数。该函数的第一个参数始终是状态:最后,我们定义图。我们使用 StateGraph 来定义一个操作此状态的图。然后我们将使用 请注意:接下来我们编译我们的图。这会提供一些基本的图结构检查(例如,识别孤立的节点)。如果我们通过检查点器为应用程序添加持久化功能,它也会在这里传入。LangGraph 提供了内置的工具来可视化你的图。让我们检查一下我们的序列。有关可视化的详细信息,请参见可视化你的图。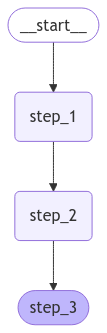 让我们进行一次简单的调用:请注意:
- 在状态的某个键中填入一个值
- 更新同一个值
- 填入一个不同的值
请注意,在向状态发出更新时,每个节点只需指定它希望更新的键的值。默认情况下,这会覆盖相应键的值。你也可以使用 Reducer 来控制更新的处理方式——例如,你可以将连续的更新追加到某个键后面。更多详情请参见使用 Reducer 处理状态更新。
add_node 和 add_edge 来填充我们的图并定义其控制流。让我们进行一次简单的调用:- 我们通过为单个状态键提供一个值来启动调用。我们必须始终为至少一个键提供一个值。
- 我们传入的值被第一个节点覆盖了。
- 第二个节点更新了该值。
- 第三个节点填入了一个不同的值。
创建分支
节点的并行执行对于加速整体图运行至关重要。LangGraph 原生支持节点的并行执行,这可以显著提高基于图的工作流的性能。这种并行化是通过扇出和扇入机制实现的,利用标准边和 conditional_edges。下面是一些示例,展示了如何添加适合你的创建分支数据流。并行运行图节点
在此示例中,我们从Node A 扇出到 B 和 C,然后扇入到 D。对于我们的状态,我们指定了 reducer add 操作。这将为状态中的特定键组合或累积值,而不是简单地覆盖现有值。对于列表,这意味着将新列表与现有列表连接起来。有关使用 Reducer 更新状态的更多详情,请参见上面关于状态 Reducer 的部分。
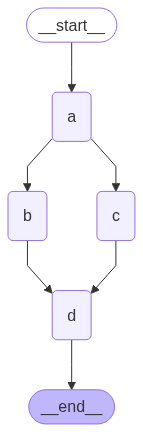 通过 Reducer,你可以看到在每个节点中添加的值被累加了。
在上面的示例中,节点
"b" 和 "c" 在同一个超步中并发执行。因为它们在同一个步骤中,节点 "d" 在 "b" 和 "c" 都完成后才执行。重要的是,并行超步的更新可能不会一致排序。如果你需要来自并行超步的更新具有一致、预定的顺序,你应该将输出与用于排序的值一起写入状态的单独字段中。异常处理?
异常处理?
LangGraph 在超步内执行节点,这意味着虽然并行分支是并行执行的,但整个超步是事务性的。如果这些分支中的任何一个引发异常,则不会将任何更新应用到状态(整个超步入错)。重要的是,当使用检查点器时,超步内成功节点的结果会被保存,并且在恢复时不会重复执行。如果你有容易出错的节点(也许想处理不稳定的 API 调用),LangGraph 提供两种方式来解决:
- 你可以在节点内编写常规的 Python 代码来捕获和处理异常。
- 你可以设置一个 retry_policy 来指示图重试引发特定类型异常的节点。只有失败的分支会被重试,因此你不必担心执行冗余工作。
延迟节点执行
延迟节点执行在你想要将节点的执行延迟到所有其他待处理任务完成之后时很有用。这在分支长度不同时特别相关,这在 Map-Reduce 流等工作流中很常见。 上面的示例展示了当每条路径只有一步时如何扇出和扇入。但如果一个分支有多个步骤怎么办?让我们在"b" 分支中添加一个节点 "b_2":
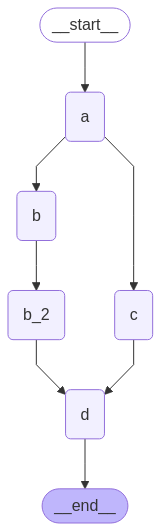
"b" 和 "c" 在同一个超步中并发执行。我们在节点 d 上设置了 defer=True,因此它将等到所有待处理任务完成后再执行。在这种情况下,这意味着 "d" 会等到整个 "b" 分支完成后再执行。
条件分支
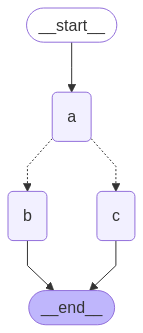
如果你的扇出应该在运行时根据状态变化,你可以使用add_conditional_edges 来使用图状态选择一个或多个路径。参见下面的示例,其中节点 a 生成一个状态更新,决定后续节点。
Map-Reduce 和 Send API
LangGraph 使用 Send API 支持 Map-Reduce 和其他高级分支模式。以下是如何使用它的一个示例: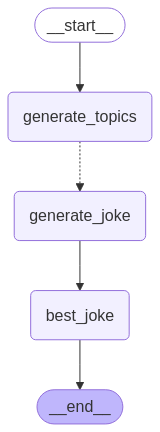
创建和控制循环
创建带有循环的图时,我们需要一种机制来终止执行。最常见的方式是添加一个条件边,一旦我们达到某个终止条件,就路由到 END 节点。 你也可以在调用或流式传输图时设置图的递归限制。递归限制设置了图在引发错误之前允许执行的超步数量。阅读更多关于递归限制概念的信息。 让我们考虑一个带有循环的简单图,以更好地理解这些机制的工作原理。 创建循环时,您可以包含一个指定终止条件的条件边:"recursion_limit"。这将引发 GraphRecursionError,您可以捕获并处理它:
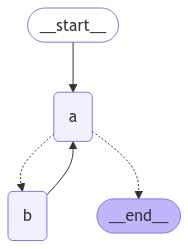 此架构类似于一个 ReAct 智能体,其中节点
"a" 是一个工具调用模型,节点 "b" 代表工具。
在我们的 route 条件边中,我们指定当状态中的 "aggregate" 列表长度超过阈值后应终止。
调用图时,我们可以看到节点 "a" 和 "b" 交替执行,直到满足终止条件。
施加递归限制
在某些应用中,我们可能无法保证会达到给定的终止条件。在这些情况下,我们可以设置图的 递归限制。这会在给定数量的 超级步骤 后引发GraphRecursionError。然后我们可以捕获并处理此异常:
扩展示例:在达到递归限制时返回状态
扩展示例:在达到递归限制时返回状态
与其引发
GraphRecursionError,我们可以向状态中添加一个新键来跟踪距离达到递归限制的剩余步数。然后我们可以使用这个键来确定是否应结束运行。LangGraph 实现了一个特殊的 RemainingSteps 注解。在底层,它创建了一个 ManagedValue 通道——一个仅在图运行期间存在的状态通道。扩展示例:带分支的循环
扩展示例:带分支的循环
为了更好地理解递归限制的工作原理,让我们考虑一个更复杂的例子。下面我们实现了一个循环,但其中一步分叉到了两个节点: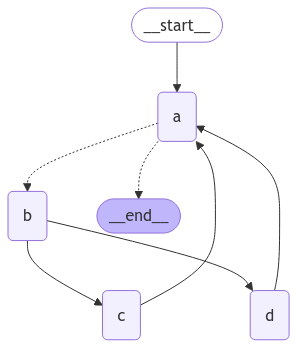 这个图看起来复杂,但可以概念化为一个超级步骤的循环:然而,如果我们将递归限制设置为四,我们只完成一圈,因为每圈有四个超级步骤:
这个图看起来复杂,但可以概念化为一个超级步骤的循环:- 节点 A
- 节点 B
- 节点 C 和 D
- 节点 A
- …
异步
在并发运行 IO 密集型 代码时(例如,向聊天模型提供商发出并发 API 请求),使用异步编程范式可以带来显著的性能提升。 要将图的同步 实现转换为 异步 实现,您需要:
- 将
节点更新为使用async def而不是def。 - 更新内部代码以适当使用
await。 - 根据需要使用
.ainvoke或.astream调用图。
同步 方法的 异步 变体,所以通常将 同步 图升级为 异步 图相当快捷。
参见下面的示例。为了演示底层 LLM 的异步调用,我们将包含一个聊天模型:
- OpenAI
- Anthropic
- Azure
- Google Gemini
- AWS Bedrock
- HuggingFace
- OpenRouter
使用 Command 组合控制流和状态更新
将控制流(边)和状态更新(节点)组合起来可能很有用。例如,您可能希望在同一个节点中同时执行状态更新并决定下一步要跳转到哪个节点。LangGraph 提供了一种方法,通过从节点函数返回一个 Command 对象来实现:
StateGraph。请注意,该图没有用于路由的条件边!这是因为控制流是在 node_a 内部使用 Command 定义的。
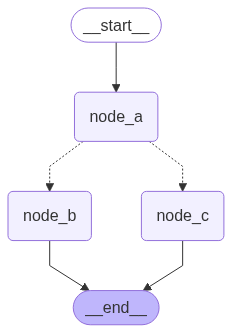 如果我们多次运行该图,我们会看到它根据节点 A 中的随机选择走不同的路径(A -> B 或 A -> C)。
导航到父图中的节点
如果您正在使用子图,您可能希望从子图中的一个节点导航到另一个子图(即父图中的不同节点)。为此,您可以在Command 中指定 graph=Command.PARENT:
nodeA 改成一个单节点图,并将其作为子图添加到我们的父图中来实现。
在工具内部使用
一个常见的用例是从工具内部更新图状态。例如,在一个客户支持应用中,您可能希望在对话开始时根据客户的账号或 ID 查询客户信息。要从工具更新图状态,您可以从工具返回Command(update={"my_custom_key": "foo", "messages": [...]}):
Command 更新状态的工具,我们建议使用预构建的 ToolNode,它可以自动处理返回 Command 对象的工具并将其传播到图状态。如果您正在编写一个调用工具的自定义节点,则需要手动将工具返回的 Command 对象作为该节点的更新进行传播。
可视化您的图
这里我们演示如何可视化您创建的图。 您可以可视化任意 Graph,包括 StateGraph。 让我们画分形图找点乐趣 :)。Mermaid
我们也可以将图类转换为 Mermaid 语法。PNG
如果愿意,我们可以将 Graph 渲染成.png。这里有三种选择:
- 使用 Mermaid.ink API(无需额外安装包)
- 使用 Mermaid + Pyppeteer(需要
pip install pyppeteer) - 使用 graphviz(需要
pip install graphviz)
draw_mermaid_png() 使用 Mermaid.Ink 的 API 来生成图表。
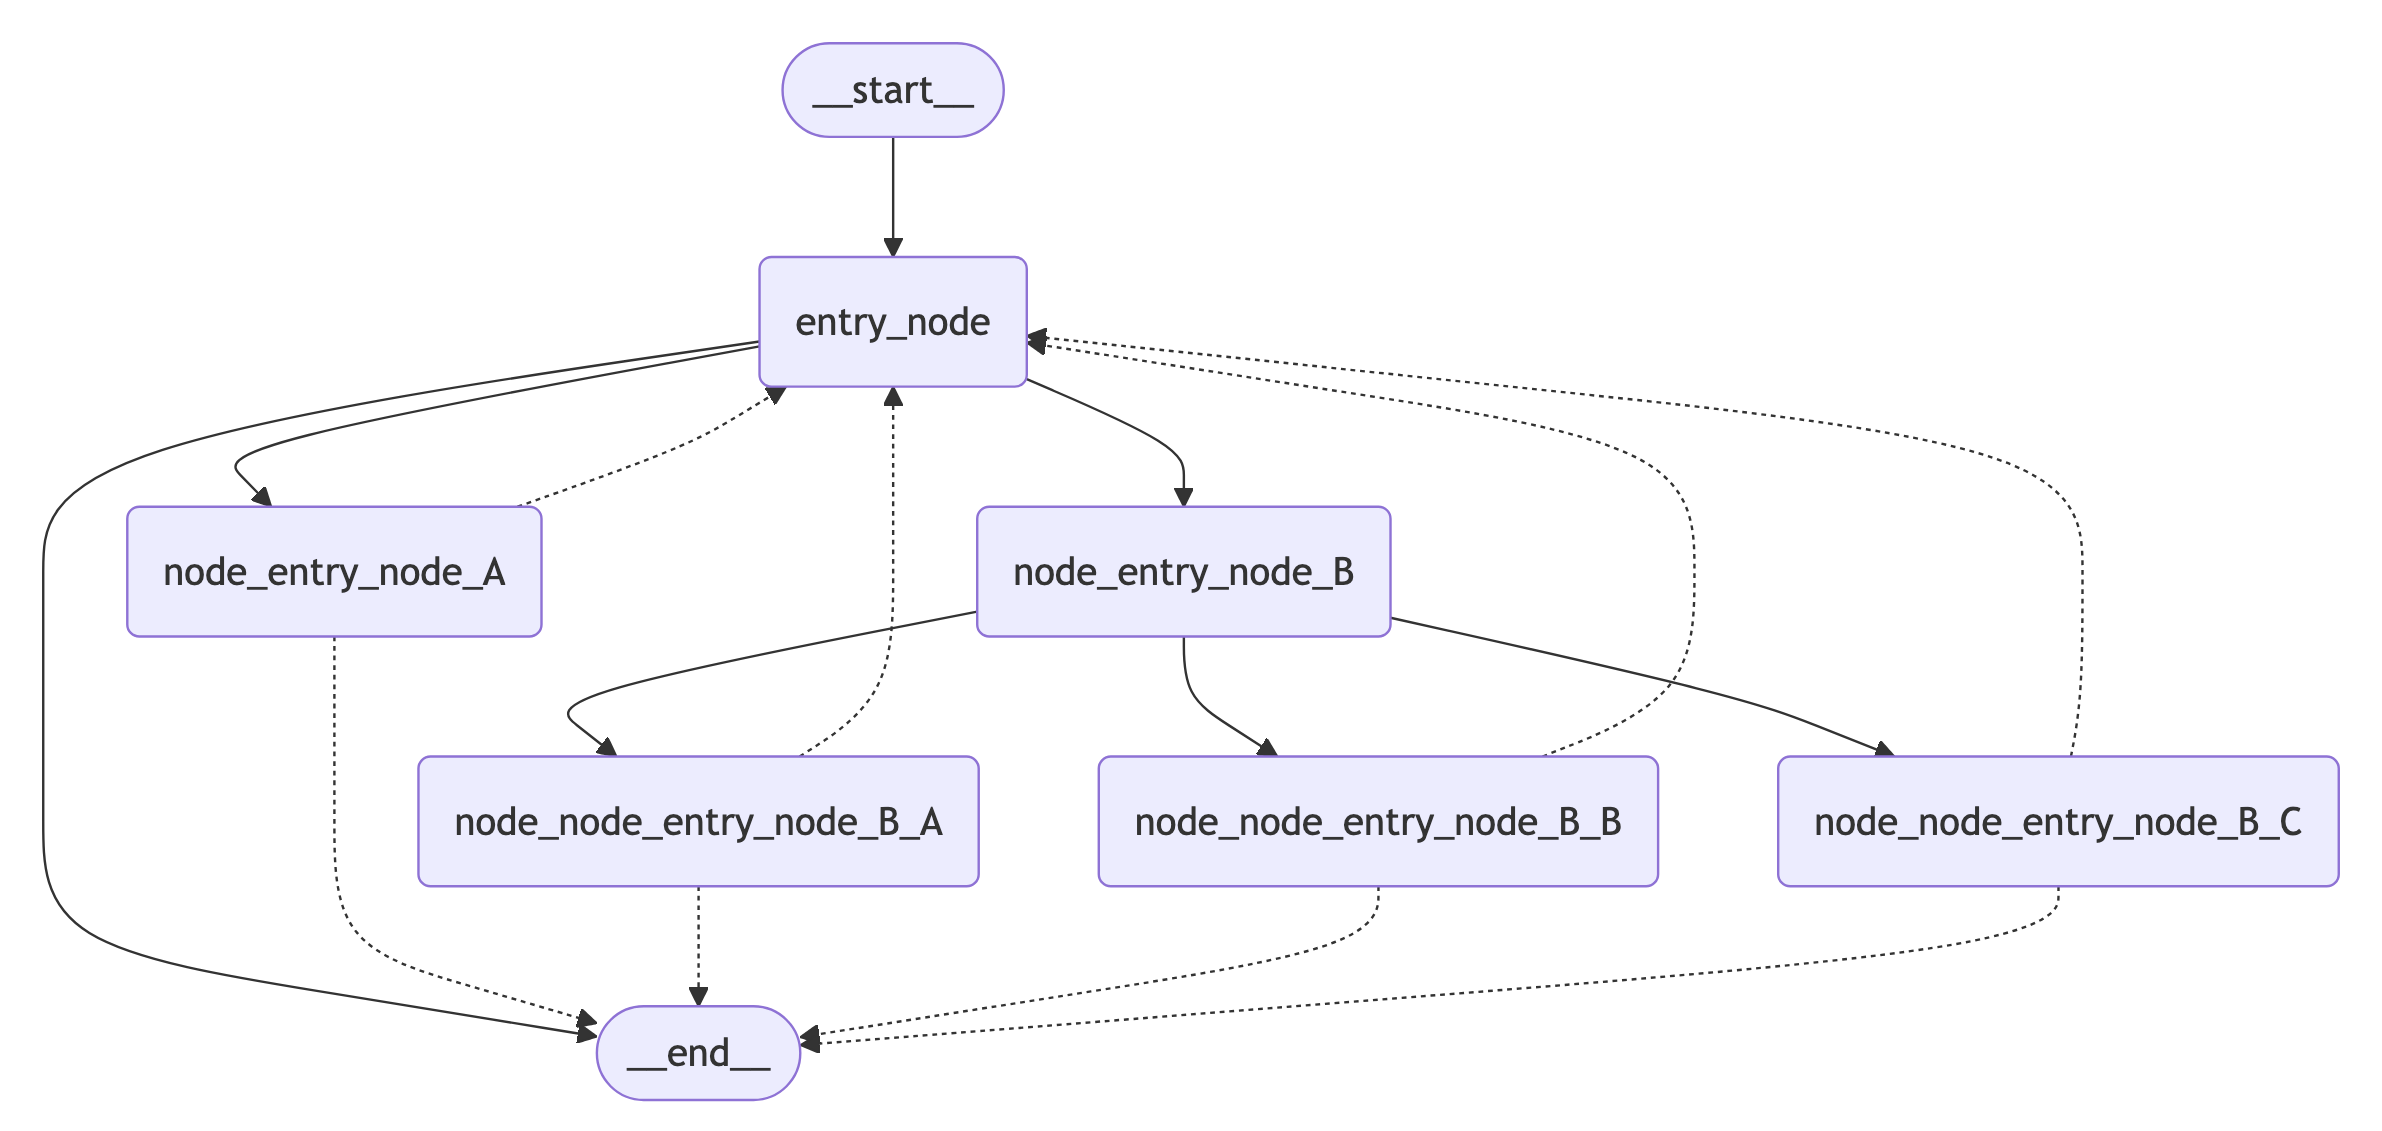 使用 Mermaid + Pyppeteer
Connect these docs to Claude, VSCode, and more via MCP for real-time answers.