

目标
在本示例中,我们将构建一个基于 GitHub issue 标题对其进行分类的机器人。它将接收一个标题,并将其分类为多个不同类别之一。然后,我们将开始收集用户反馈,并利用它来塑造此分类器的性能。入门
首先,我们将进行设置,以便将所有跟踪发送到一个特定的项目。我们可以通过设置一个环境变量来实现:设置自动化
我们现在可以设置自动化,将具有某种反馈的示例移动到一个数据集中。我们将设置两个自动化,一个用于正面反馈,另一个用于负面反馈。 第一个将捕获所有具有正面反馈的运行,并自动将它们添加到一个数据集中。其背后的逻辑是,任何具有正面反馈的运行都可以在未来的迭代中用作良好示例。让我们创建一个名为classifier-github-issues 的数据集来添加这些数据。
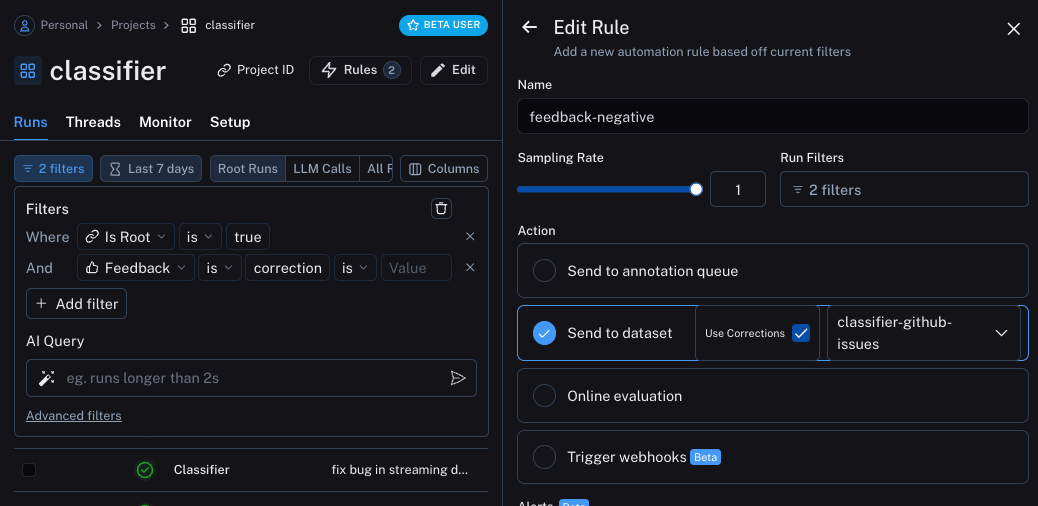
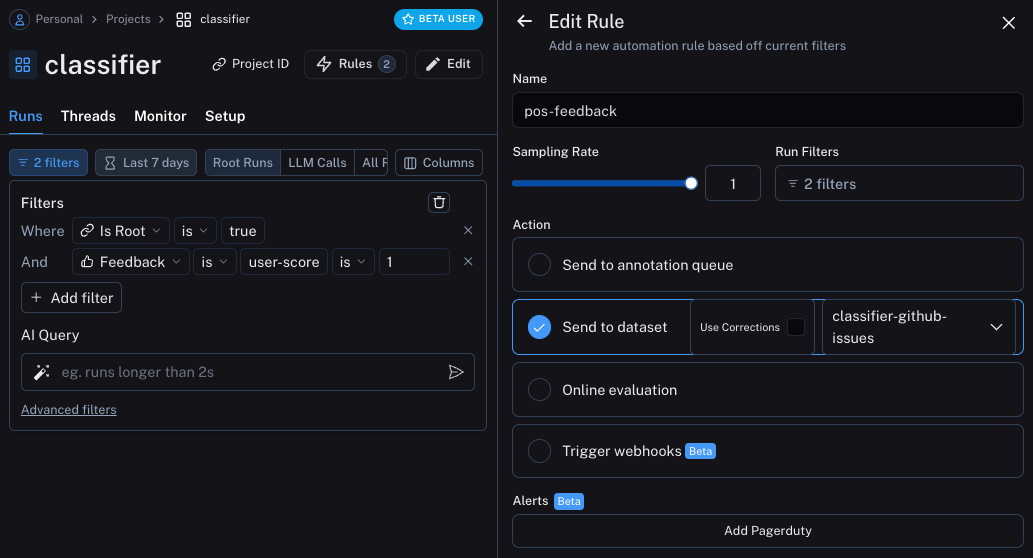 第二个将捕获所有具有修正的运行,并使用 Webhook 将它们添加到一个数据集中。创建此 Webhook 时,我们将选择“使用修正”选项。此选项将确保在从运行创建数据集时,不使用运行的输出作为数据点的黄金标准输出,而是使用修正值。
更新应用程序
我们现在可以更新代码,以拉取我们正在发送运行数据的数据集。一旦拉取下来,我们就可以创建一个包含示例的字符串。然后,我们可以将这个字符串作为提示的一部分!documentation。
示例的语义搜索
我们可以做的另一件事是仅使用语义最相似的示例。当您开始积累大量示例时,这很有用。 为了做到这一点,我们可以首先定义一个函数来查找最相似的k 个示例:
Connect these docs to Claude, VSCode, and more via MCP for real-time answers.