


 Amazon Bedrock

 Anthropic

 Azure OpenAI

 DeepSeek

 Fireworks

 Google GeminiGoogle Vertex AI

 Groq

 Mistral AI

 OpenAIOpenAI 兼容端点

 XAI
Amazon Bedrock
在使用此模型之前,请确保您拥有 AWS 凭证或 IAM 角色。身份验证
Amazon Bedrock 支持两种身份验证方法。IAM 受信任实体是推荐的方法,因为它避免了向 LangSmith 共享长期有效的 AWS 访问密钥。IAM 受信任实体(推荐)
不适用于自托管 LangSmith。 请改用访问密钥(或 Bedrock API 密钥)。
- 在您的 AWS 账户中创建一个具有调用 Bedrock 模型权限(例如
bedrock:InvokeModel)的 IAM 角色。 - 添加一个信任策略,允许 LangSmith 的 AWS 账户 (
808407022534) 承担该角色,并使用您的 LangSmith 工作区 ID 作为外部 ID:
-
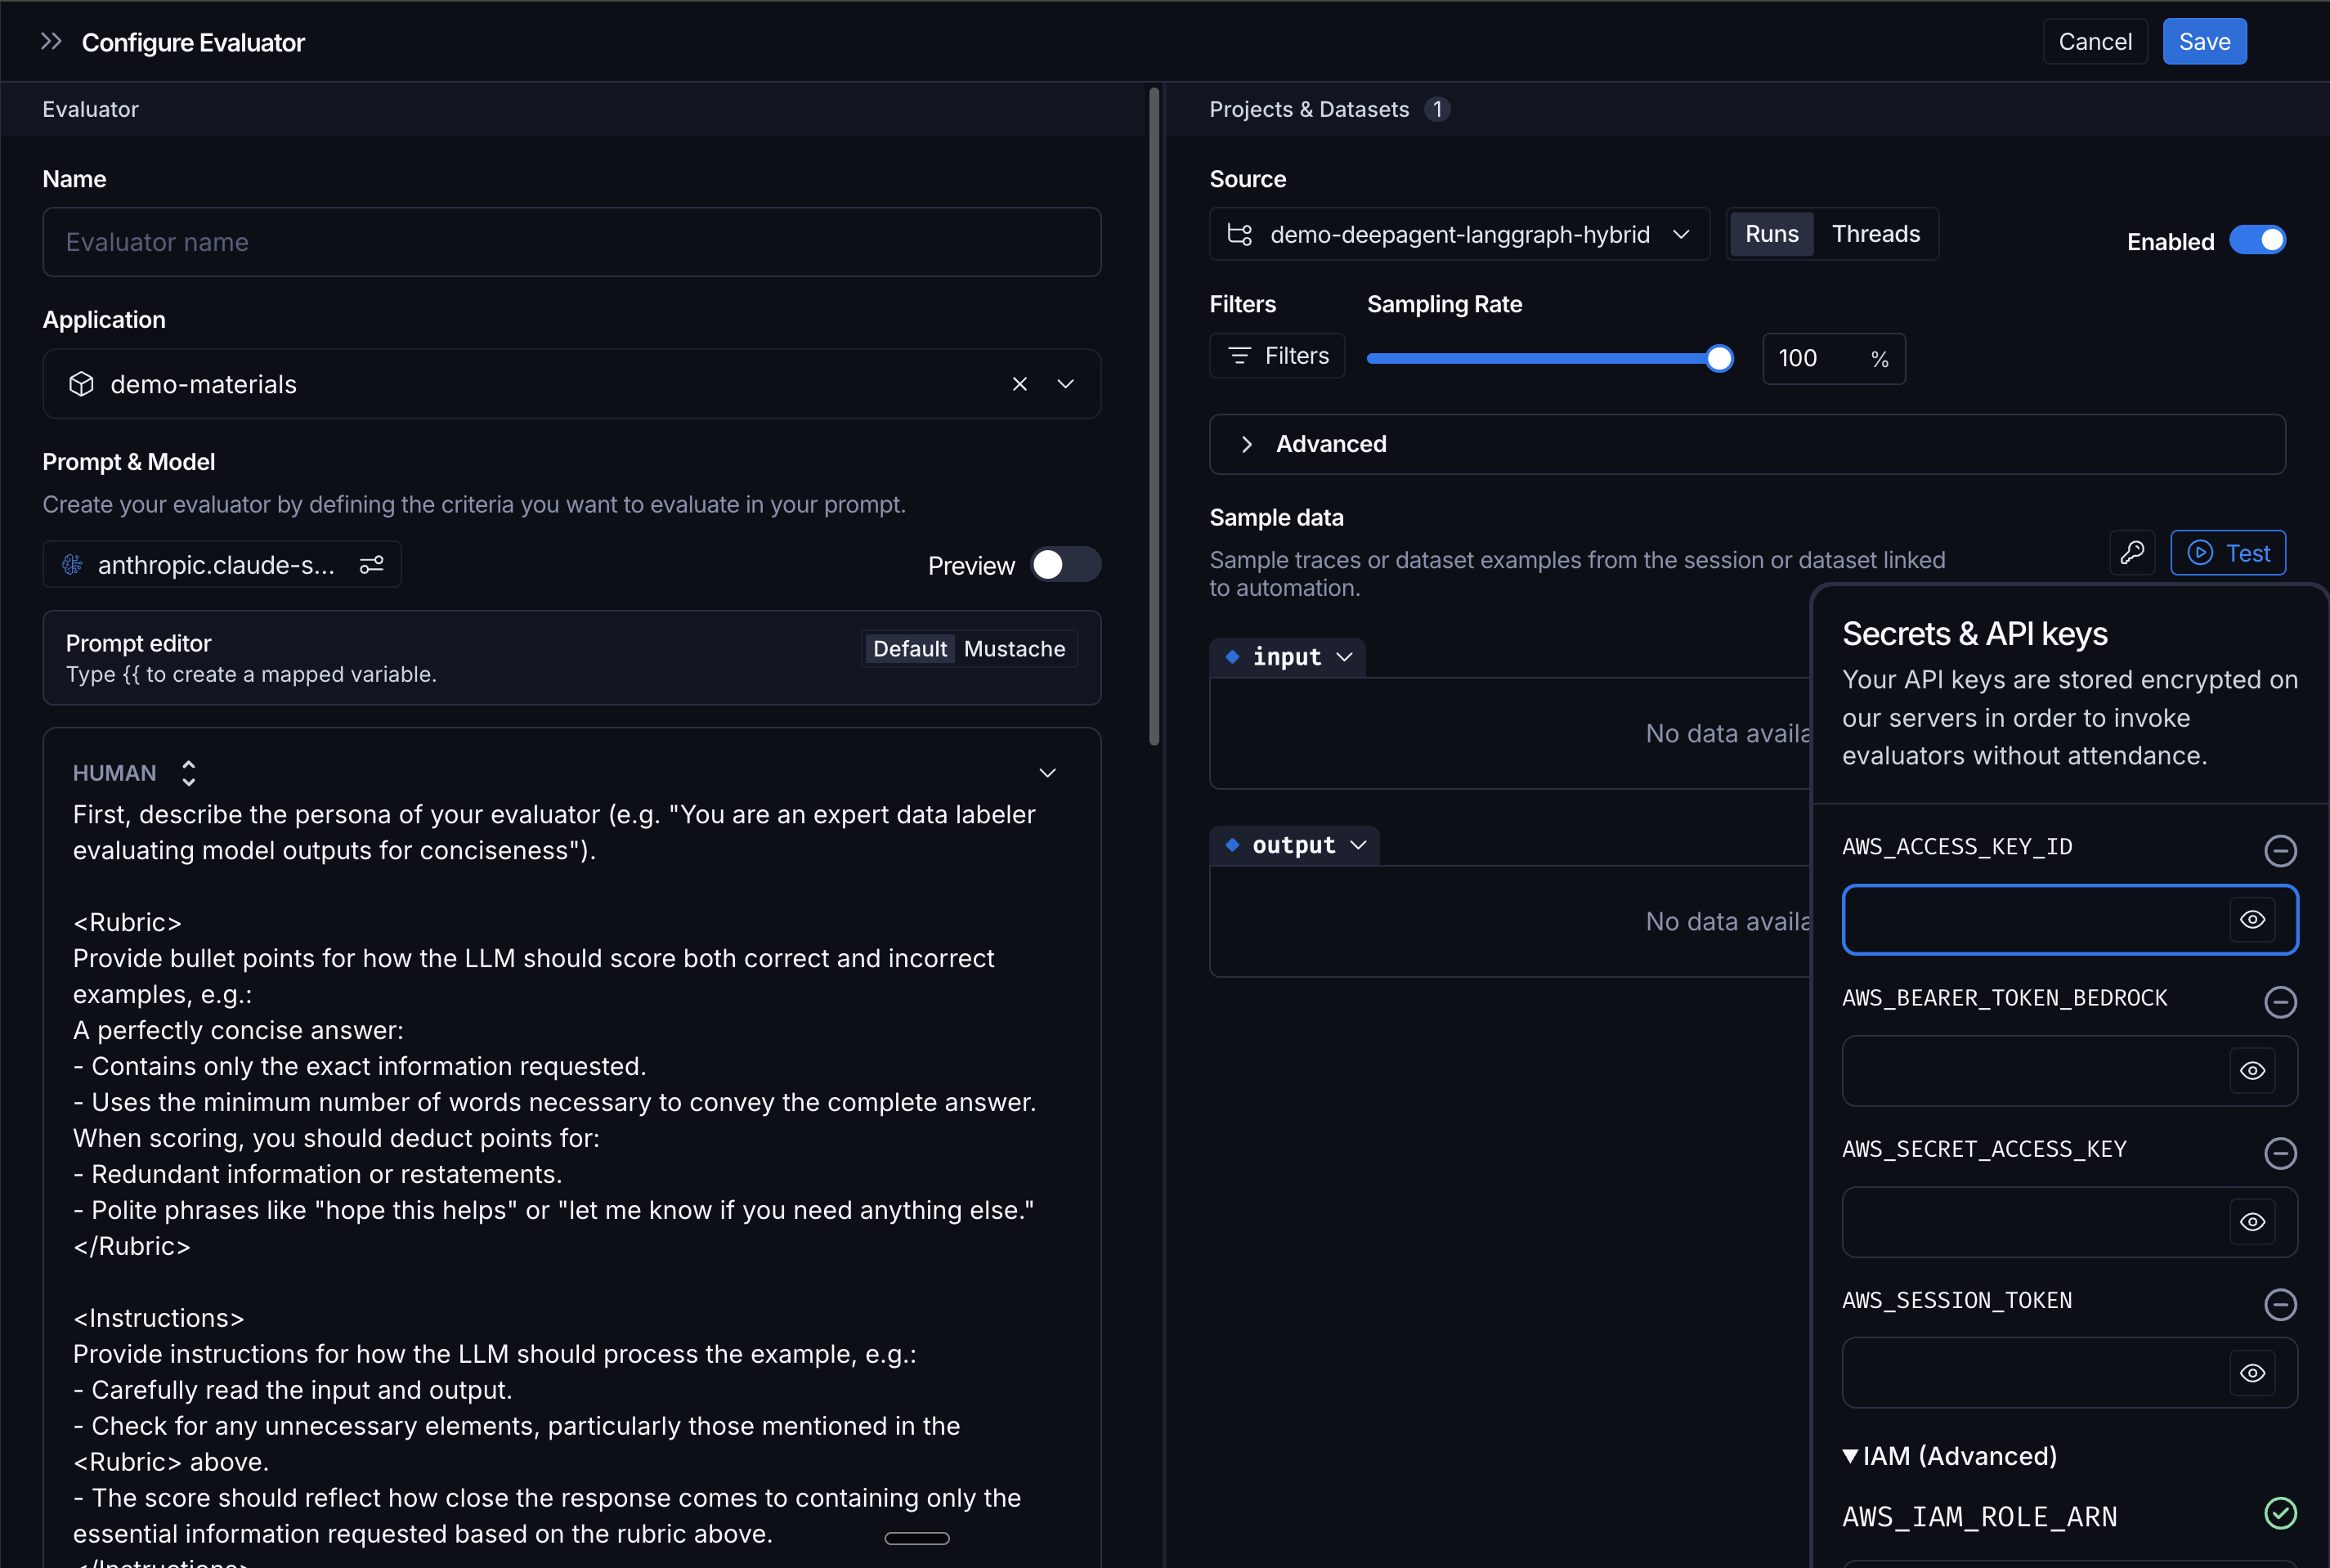
在 LangSmith 工作台中,点击 Key 图标打开 Bedrock 提供商的密钥配置(IAM 受信任实体选项在模型配置下拉菜单本身中不可用)。然后展开 IAM Trusted Entity 部分并输入您创建的角色的 ARN。
访问密钥
或者,您可以使用 AWS 访问密钥(AWS_ACCESS_KEY_ID 和 AWS_SECRET_ACCESS_KEY)进行身份验证。在工作台的 Bedrock 提供商配置中输入这些密钥。此方法设置更简单,但安全性较低,因为它需要存储长期有效的凭证。
可用模型
AWS Bedrock 提供对来自多个提供商的基础模型的访问:- Anthropic: Claude 模型。
- Amazon: Titan 模型。
- Cohere: Command 模型。
- Meta: Llama 模型。
- 其他: 根据区域提供其他提供商。
配置参数
参数取决于底层模型提供商:对于 Anthropic 模型
使用 Anthropic 配置(参见下面的 Anthropic 部分)。对于 Amazon Titan
AWS 特定设置
- Region: 模型部署的 AWS 区域。
工具调用
取决于底层模型:- Anthropic 模型:
auto,any。 - Cohere 模型:
auto。
Anthropic
在使用此模型之前,请确保您拥有一个 Anthropic API 密钥。可用模型
Anthropic 在其 Claude 各代模型中提供三个层级的模型:- Opus: 最高智能和能力。
- Sonnet: 平衡性能和成本。
- Haiku: 快速且经济高效。
配置参数
Temperature、Top P 和 Top K 是可选的。当未勾选时,Claude 使用其内部默认值。
扩展思考
适用于受支持的 Claude 模型。使模型能够在响应前显示推理过程,类似于 OpenAI 的 o 系列模型。
启用后,响应包括:
- 一个包含模型推理的 “thinking” 部分。
- 最终响应。
高级选项
- Base URL: 覆盖自定义部署的 API 端点。
工具调用
- 支持的工具选择:
auto、any(需要至少一个工具)。 - 并行执行: 否(仅顺序执行)。
Azure OpenAI
在使用此模型之前,请确保您拥有 Azure OpenAI 凭证(端点 + API 密钥)。可用模型
Azure OpenAI 提供与 OpenAI 相同的模型系列:- GPT 系列: 通用聊天模型。
- o 系列: 推理优化模型。
- 旧版模型: GPT-3.5 和 GPT-4 变体。
配置参数
Azure OpenAI 支持与 OpenAI 相同的参数:标准参数
高级参数
Reasoning Effort(推理强度):适用于推理优化模型(o 系列和更新的 GPT 模型)。 Service Tier(服务层级):适用于较新的模型。 其他参数:- JSON Mode: 强制输出有效的 JSON 响应。
- Parallel Tool Calls: 并发执行多个工具。
Azure 特定功能
- Deployment Management(部署管理): 模型必须在使用前部署。
- Regional Availability(区域可用性): 选择 Azure 区域以满足数据驻留要求。
- Content Filtering(内容过滤): 内置的内容审核和安全功能。
- Managed Identity(托管标识): 支持 Azure AD 身份验证。
- Private Endpoints(私有端点): VNet 集成以实现安全访问。
工具调用
- 支持的工具选择:
auto、required、none或特定工具名称。 - 并行执行: 是。
DeepSeek
在使用此模型之前,请确保您拥有一个 DeepSeek API 密钥。可用模型
DeepSeek 提供通用模型、推理优化模型(R 系列)和专门的编码模型。 有关当前可用模型列表,请参阅 DeepSeek 文档。配置参数
Fireworks
在使用此模型之前,请确保您拥有一个 Fireworks API 密钥。可用模型
Fireworks 为流行的开源模型和微调变体提供高速推理,包括:- Llama: Meta 的各种尺寸的 Llama 模型。
- Mixtral: Mistral 的专家混合模型。
- Qwen: 阿里巴巴的多语言模型。
- DeepSeek: DeepSeek 模型。
- 其他开放模型: Gemma、Phi 等。
配置参数
工具调用
- 支持的工具选择:
auto、required、none。 - 并行执行: 是。
Google Gemini
在使用此模型之前,请确保您拥有一个 Google AI API 密钥。可用模型
Google 提供多个层级的 Gemini 模型(Ultra、Pro、Flash),针对不同用例进行了优化。 有关当前可用模型列表,请参阅 Google 的 Gemini 文档。配置参数
工具调用
- 支持的工具选择:
auto、any、none。 - 并行执行: 否。
Google Vertex AI
在使用此模型之前,请确保您拥有 Google Cloud 凭证。可用模型
Google 提供多个层级的 Gemini 模型(Ultra、Pro、Flash),针对不同用例进行了优化,另外还有通过 Vertex AI 可用的其他模型。 有关当前可用模型列表,请参阅 Vertex AI 文档。配置参数
高级选项
- Region Selection(区域选择): 在特定的 Google Cloud 区域部署。
- Safety Settings(安全设置): 配置内容过滤阈值。
工具调用
- 支持的工具选择:
auto、any、none。 - 并行执行: 否。
Groq
在使用此模型之前,请确保您拥有一个 Groq API 密钥。可用模型
Groq 为流行的开源模型(包括 Llama、Mixtral 和 Gemma 变体)提供高速推理。 有关当前可用模型列表,请参阅 Groq 的模型文档。配置参数
工具调用
- 支持的工具选择:
auto、required、none。 - 并行执行: 是。
Mistral AI
在使用此模型之前,请确保您拥有一个 Mistral AI API 密钥。可用模型
Mistral 提供多个层级的模型(Large、Medium、Small),针对不同的性能和成本需求进行了优化。 有关当前可用模型列表,请参阅 Mistral 文档。配置参数
工具调用
- 支持的工具选择:
auto、any、none。 - 并行执行: 否。
OpenAI
在使用此模型之前,请确保您拥有一个 OpenAI API 密钥 或 Azure OpenAI 凭证。可用模型
OpenAI 提供几个具有不同能力和价格点的模型系列:- GPT 系列: 具有各种尺寸/能力层级的通用聊天模型。
- o 系列: 针对复杂问题解决进行优化的推理模型。
- 旧版模型: 较旧的 GPT-3.5 和 GPT-4 变体。
配置参数
标准:
高级:
Reasoning Effort(推理强度):适用于推理优化模型(o 系列和更新的 GPT 模型)。
控制响应前的推理深度。推理强度越高,复杂任务的质量越好,但延迟也更长。
当 reasoning_effort 激活(不是
none)时,temperature、top_p 和惩罚参数会自动禁用。
其他参数:
- JSON Mode: 强制输出有效的 JSON 响应。
- Responses API: 改进的流式传输(默认:启用)。
- Parallel Tool Calls: 并发执行多个工具。
工具调用
- 支持的工具选择:
auto、required、none或特定工具名称 - 并行执行: 是
OpenAI 兼容端点
身份验证方式因端点而异。常见选项:- API 密钥:存储为工作区密钥并作为
Authorization: Bearer <key>转发。 - 无:用于未身份验证的本地端点(例如,
localhost上的 Ollama)。 - OAuth2
client_credentials:存储在模型配置中。LangSmith 在请求时生成一个短期有效的承载令牌,并在过期前刷新它。请参阅 OAuth 客户端凭据。
配置
必需:- Base URL: 您的端点 URL(例如,
https://your-endpoint.com/v1)。 - Model Name: 您的模型标识符。
- 自托管的开源推理服务器
- 模型路由代理
- 自定义模型端点
配置参数
所有 OpenAI 兼容参数:
高级:
- JSON Mode: 如果端点支持。
- Streaming: 如果端点支持。
- Function Calling: 如果端点实现 OpenAI 格式。
工具调用
- 支持的工具选择:
auto、required、none(如果端点支持)。 - 并行执行: 是(如果端点支持)。
示例端点
本地 Ollama:XAI
在使用此模型之前,请确保您拥有一个 xAI API 密钥。可用模型
xAI 提供多种尺寸的 Grok 模型,适用于不同用例。 有关当前可用模型列表,请参阅 xAI 文档。配置参数
标准 OpenAI 兼容参数:工具调用
- 支持的工具选择: OpenAI 兼容。
- 并行执行: 是(如果支持)。
所有提供商的通用配置
额外参数
所有提供商都支持用于 UI 中未暴露的额外参数的 JSON 编辑器:- 提供商特定的测试版功能
- 尚未在 UI 中的高级参数
- 用于跟踪的自定义元数据
速率限制
每秒请求数 (RPS) - 在数据集上运行时,所有提供商均可用:- 范围: 0 - 500 RPS
- 用途: 尊重 API 速率限制,控制成本
- 默认值: 因提供商而异
后续步骤
配置提示词设置
了解如何在工作台中创建和管理模型配置。
创建提示词
开始使用您选择的模型提供商构建提示词。
Connect these docs to Claude, VSCode, and more via MCP for real-time answers.